


深度探索LangGraph的潜力
作者|崔皓审校|重楼摘要本文介绍了一种基于LangChain的新技术LangGraph,它通过循环图协调大模型和外部工具,解决复杂任务。首先,介绍了LangChain的DAG模型处理简单任务,以及LangGraph使用循环图处理复杂任务的原理。然后,详细阐述了LangGraph的三个核心组成部分:状态图StateGraph、节点Nodes和边Edges。最后,通过一个实例演示了如何使用LangGraph查询北京2024年春节的旅游情况,包括创建代理、定义图状态、节点和边,以及执行工作流。开篇在当今的技术领
作者 | 崔皓
审校 | 重楼
摘要
本文介绍了一种基于LangChain的新技术LangGraph,它通过循环图协调大模型和外部工具,解决复杂任务。首先,介绍了LangChain的DAG模型处理简单任务,以及LangGraph使用循环图处理复杂任务的原理。然后,详细阐述了LangGraph的三个核心组成部分:状态图StateGraph、节点Nodes和边Edges。最后,通过一个实例演示了如何使用LangGraph查询北京2024年春节的旅游情况,包括创建代理、定义图状态、节点和边,以及执行工作流。
开篇
在当今的技术领域,大型语言模型(Large Language Models, LLMs)已经逐渐成为我们日常生活和工作中的得力助手。无论是写作辅助、编程调试,还是简单的问答系统,LLMs都能够提供快速且准确的服务。然而,当面对一些更为复杂的任务时,LLMs可能就显得力不从心。为了解决这些挑战,我们引入了LangGraph,这是一种结合了人工智能代理(AI Agents)的新技术,旨在处理更为复杂的任务和交互。
LangGraph是一种新型库,与LangChain生态系统完全兼容。它采用循环图的方法来协调大型模型和外部工具,有效解决复杂问题,满足不同的应用场景需求。
在这篇文章中,我们将通过一个简单的案例来说明如何使用LangGraph应用程序。我们将以询问2024年春节北京的旅游情况为例,逐步介绍LangGraph的概念、构成要素以及如何将其应用于实际情景。通过这个案例,您将清楚地了解LangGraph是如何提高工作效率、解决复杂问题的。
什么需要使用LangGraph
使用过LangChain的朋友都知道,LangChain的核心优势在于其能够轻松构建自定义链,这些链通常是线性的,类似于有向无环图(DAG)。DAG是一种数据结构,其中任务按照一定的顺序执行,每个任务只有一个输出和一个后续任务,形成一个没有循环的线性流程。例如,当我们从向量库中搜索内容时,我们首先输入提示词,然后通过向量比对进行搜索,并返回结果,这个过程就是一个典型的DAG,每个步骤都严格按顺序执行。
有向无环图(DAG)在数据编排和工作流管理系统中扮演着重要角色,它描述了一组任务之间的依赖和关联关系,指示了任务执行的顺序。在DAG中,任务被表示为节点,节点之间的有向边表示了任务之间的依赖关系,这确保了只有在其前置任务成功完成后,后续任务才能执行。通过构建DAG,可以有效地管理任务的执行顺序,提高系统的可靠性和效率。这种结构使得任务的并行执行成为可能,同时也使得系统能够更好地处理复杂的数据流,提高数据处理的速度和准确性。因此,了解和应用DAG对于数据处理和工作流管理来说是至关重要的。
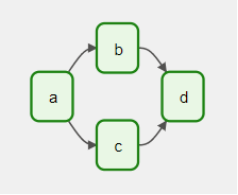
例如,一个基本的有向无环图可能会定义任务A、B、C和D,并明确指出它们的执行顺序和依赖关系。这种结构不仅指出了哪些任务必须先于其他任务执行,而且还指定了调度参数,比如从明天开始每5分钟运行一次DAG,或者从2024年1月1日开始每天运行一次。
DAG的主要关注点并不是任务内部的运作机制,而是它们应该如何执行,包括执行的顺序、重试逻辑、超时以及其他操作方面的问题。这种抽象使得创建复杂的工作流变得容易管理和监控。
然而,并非所有任务都如此简单。在遇到复杂任务时,比如第一次搜索没有找到想要的内容,我们可能需要进行第二次、第三次搜索,甚至可能需要调用网络搜索来完成。在这种情况下,顺序执行的任务(DAG)显然无法满足需求。此时,请求方和搜索方之间需要经历多次来回沟通,请求方可能会要求搜索方根据反馈调整搜索策略,这种多次的循环沟通才能逐步逼近最终答案。
这种情况下,我们需要的不再是DAG,而是一个循环图,它能够描述多个参与者之间的多轮对话和互动,以确认最终的答案。这种循环图能够处理更模糊、更复杂的用例,因为它允许系统根据反馈进行调整和迭代。那么,在循环图的运行模式就是智能代理,也就是AI Agent。
AI Agent,即人工智能代理,是一种基于强化学习理论设计的系统。如下图所示,强化学习是一种机器学习方法,它使智能体(Agent)能够根据环境的不同状态(State)采取行动(Action),目的是获取最大程度的奖励(Reward)。这种学习过程涉及到智能体与环境的不断互动,通过尝试和错误来学习哪种行动策略能够带来最佳的结果。
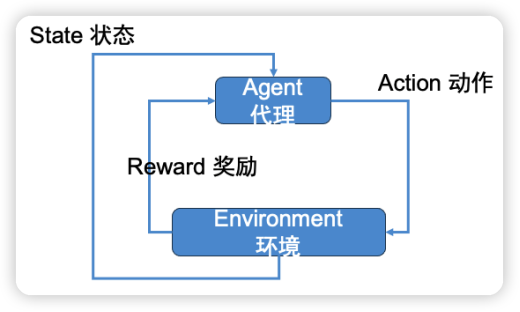
例如,在微信的跳一跳游戏中,智能体每次成功跳上平台都会获得奖励,而未能跳上平台则会受到惩罚。通过这种奖励和惩罚机制,智能体能够学习如何调整跳跃的力量和方向,以获得更高的分数。这个过程就是强化学习的一个简单体现,智能体通过不断的互动来优化其行动策略。
在LangGraph中,AI Agent的工作原理类似。LLM(大型语言模型)用于确定要采取的行动和向用户提供的响应,然后执行这些行动,并返回到第一步。这个过程会重复进行,直到生成最终的响应。这就是LangChain中核心AgentExecutor的工作循环原理。
然而,在实际应用过程中,我们发现需要对智能代理进行更多的控制。例如,我们可能希望智能代理始终首先调用特定工具,或者我们可能希望对工具的调用方式有更多的控制,甚至可能希望根据智能代理的状态使用不同的提示。为了解决这些问题,LangGraph提出了“状态机”的概念。通过状态机为图创建对应的状态机,这种方法可以更好地控制智能代理的行动流程,使其更加灵活和有效地处理复杂任务。
LangGraph的组成部分
在介绍LangGraph如何通过应用“状态机”来实现AI Agent功能时,有几个重要的概念我们需要理解,它们也是LangGraph的重要组成部分。
StateGraph(状态图)
首先,需要理解StateGraph这个核心概念。StateGraph是一个类,它负责表示整个图的结构。我们通过传入一个状态定义来初始化这个类,这个状态定义代表了一个中心状态对象,它会在执行过程中不断更新。这个状态对象由图中的节点更新,节点会以键值对的形式,返回对状态属性的操作。
状态对象的属性可以通过两种方式更新:
1. 覆盖更新:如果一个属性需要被新的值替换,我们可以让节点返回这个新值。
2. 增量更新:如果一个属性是一个动作列表(或类似的操作),我们可以在原有的列表上添加新的动作。
在创建状态定义时,我们需要指定属性的更新方式,是覆盖还是增量。
如果StateGraph的概念不好理解,可以想象一下你正在组织一次旅行。你设定了旅行的一些基本信息,比如确定目的地、预定航班和预定酒店。这些信息就像是一个中心状态对象,随着你计划的进展,它会不断更新。比如,你可能会添加新的活动到你的行程中,或者修改你的预算。这些更新就像是图中的节点,它们对你的旅行计划状态对象进行操作。
在LangGraph中,StateGraph类就是这样的旅行计划,而节点就像是规划旅行的不同步骤,比如确定目的地、预定航班和预定酒店。每个步骤都会更新你的旅行计划,可能是完全替换旧的计划,也可能是添加新的信息到现有的计划中。
Nodes(节点)
说完了StateGraph,我们来关注图的节点部分。在创建了StateGraph之后,我们需要向其中添加Nodes(节点)。添加节点是通过`graph.add_node(name, value)`语法来完成的。
其中,`name`参数是一个字符串,用于在添加边时引用这个节点。`value`参数应该可以是函数或者LCEL(LangChain Expression Language)可运行的实例,它们将在节点被调用时执行。它们可以接受一个字典作为输入,这个字典的格式应该与State对象相同,在执行完毕之后也会输出一个字典,字典中的键是State对象中要更新的属性。说白了,Nodes(节点)的责任是“执行”,在执行完毕之后会更新StateGraph的状态。
接着,上面旅行计划的例子,Nodes(节点)就好像旅行计划中需要完成的任务,例如:预定航班、预订酒店。Nodes(节点)接受旅行计划(State对象)作为输入,并输出一个更新后的任务状态,例如:完成酒店的预订。
换句话说为了完成复杂任务,我们会在StateGraph中添加很多Nodes(节点)。每个节点都代表一个任务,它们执行的结果会影响StateGraph的状态。这些节点通过边相互连接,形成了一个有向无环图(DAG),确保了任务的正确执行顺序。
Edges(边)
说了StateGraph之后就不得不提到Edge(边)了。在LangGraph中,Edges(边)是连接Nodes(节点)并定义StateGraph(状态图)中节点执行顺序的关键部分。添加节点后,我们可以添加边来构建整个图。边有几种类型:
- 起始边(Starting Edge):这个边确定了图的开始,比如在旅行计划中,起始边就是确定你的目的地。一旦目的地被确定,你的旅行计划就可以开始执行了。
- 普通边(Normal Edges):这些边表示一个节点总是要在另一个节点之后被调用。在旅行计划中,普通边就像是确定了任务执行的顺序。例如,在找到合适的航班之后,你可能会决定预订酒店。这个顺序确保了任务的有序执行。
- 条件边(Conditional Edges):使用函数(通常由LLM提供)来确定首先调用哪个节点。在旅行计划中,条件边就像是根据你的喜好或者天气情况来决定你的下一步行动。比如,如果你发现没有合适的航班,你可能会选择推迟预订酒店,而去查找火车车票。条件边提供了灵活性,使得系统可以根据不同的情况来调整执行的顺序。
在LangGraph中,边(Edges)是连接节点(Nodes)并定义图(Graph)中节点执行顺序的关键部分。边可以看作是对节点的控制和链接,它们确保了图中的任务按照预定的顺序执行。
在LangGraph中,边定义了节点之间的依赖关系和执行顺序。起始边确定了图的开始,普通边确保了任务的正确执行顺序,而条件边则根据特定的条件来决定下一步的操作。
LangGraph 实战
前面对LangGraph的设计原理以及基本组成部分有了简单的了解, 接下来,我们通过一个例子来感受一下,如何实际使用LangGraph查询北京2024年春节的旅游情况。熟悉大模型的朋友可能知道,大模型的短板就是对实时的信息一无所知,如果要摄入新的知识必须经过新数据集的训练才行。因此,我们会使用LangGraph调用网络搜索功能获取实时信息。
创建LangChain 代理
在LangChain中代理是利用大模型作为推理引擎来确定采取的行动序列,与在链中硬编码的一系列行动不同。说白了,就是执行这次任务的“关键人物”, 他作为“查询北京2024年春节的旅游情况”任务的总负责,最后给用户提供结果。
# 从langchain包中导入hub对象,该对象用于内容管理和检索from langchain import hub# 从langchain包中导入创建OpenAI函数代理的函数from langchain.agents import create_openai_functions_agent# 从langchain_openai包中导入ChatOpenAI类,用于与OpenAI聊天模型交互from langchain_openai.chat_models import ChatOpenAI# 从langchain_community包中导入TavilySearchResults类,提供搜索功能from langchain_community.tools.tavily_search import TavilySearchResults# 创建一个工具列表,其中包含TavilySearchResults实例,限制最大搜索结果为1tools = [TavilySearchResults(max_results=1)]# 通过hub对象的pull方法检索语句提示,langchain hub 维护了很多prompt,这些prompt 是针对不同应用场景而创建的# 作为用户,你也可以在hub中上传你构建的promptprompt = hub.pull("hwchase17/openai-functions-agent")# 打印获取的提示print(prompt)# 初始化一个Large Language Model(LLM)聊天实例,使用GPT-3.5 Turbo模型,并启用流模式和自定义API基础URLllm = ChatOpenAI(model="gpt-3.5-turbo-1106", streaming=True)# 使用LLM,工具和提示信息创建OpenAI函数代理,形成一个可运行的代理agent_runnable = create_openai_functions_agent(llm, tools, prompt)针对上述代码进行解释如下:
1. `from langchain import hub` - 从`langchain`包中导入`hub`对象,langchain hub 维护了很多prompt,这些prompt 是针对不同应用场景而创建的。作为用户,你也可以在hub中上传你构建的prompt。
2. `from langchain.agents import create_openai_functions_agent` - 从`langchain`包中导入`create_openai_functions_agent`函数,这个函数用来创建基于OpenAI函数的代理(agent)。
3. `from langchain_openai.chat_models import ChatOpenAI` - 从`langchain_openai`包中导入`ChatOpenAI`类,这个类用于与OpenAI聊天模型进行交互。
4. `from langchain_community.tools.tavily_search import TavilySearchResults` - 从`langchain_community`包中导入`TavilySearchResults`类,该类用于提供搜索结果的功能。
5. `tools = [TavilySearchResults(max_results=1)]` - 创建一个列表`tools`,其中包含一个`TavilySearchResults`实例,这个实例限制搜索结果的数量为最多1个。这里我们需要通过Tavily的工具实现互联网搜索。
6. `prompt = hub.pull("hwchase17/openai-functions-agent")` - 通过`hub`对象的`pull`方法检索一个名为`hwchase17/openai-functions-agent`的语句提示。
7. `print(prompt)` - 打印出获取的提示内容。
8. `llm = ChatOpenAI(model="gpt-3.5-turbo-1106", streaming=True)` - 初始化一个Large Language Model(LLM)的聊天实例,指定使用`gpt-3.5-turbo-1106`模型,并启用流模式。
9. `agent_runnable = create_openai_functions_agent(llm, tools, prompt)` - 创建一个OpenAI函数代理,它能够根据给定的LLM实例、工具列表以及提示信息运行。
这段代码的目的是初始化并配置一个与OpenAI 聊天模型进行交互的环境。首先,它导入了所需的模块和类,包括内容管理的`hub`对象、创建OpenAI 函数代理的`create_openai_functions_agent`函数、与OpenAI 聊天模型交互的`ChatOpenAI`类和提供搜索功能的`TavilySearchResults`类。然后,代码创建了工具列表,并从`langchain hub`中拉取了一个预先定义的提示。
这里我们将prompt 的打印结果,贴图如下:
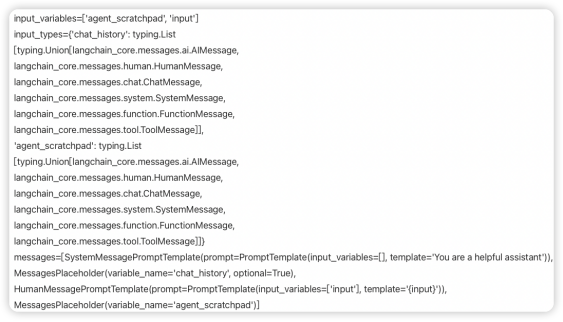
这个prompt来自于LangChain hub,用于发现、分享不同的大模型提示词。这里我们使用的就是别人定义好的提示词模版。它定义了用于生成代理(agent)操作的输入变量和信息类型(messages)。下面逐个解释显示的`prompt`内容:
1. `input_variables=['agent_scratchpad', 'input']` - 这里指定了输入变量列表,包括`agent_scratchpad`和`input`。
2. `input_types` - 这是一个定义了不同输入类型的字典,包括以下键和对应的类型:
- chat_history: 表述聊天历史记录的类型,是一个包含各种消息类型的列表。这些消息类型可能包括AI消息、人类发送的消息、聊天消息、系统消息、函数消息和工具消息。
- `agent_scratchpad`: 代表代理的“草稿本”,用来记录过程中的信息,类型与`chat_history`相同,包含多种可能的消息类型。
3. `messages` - 这是一个包含多个不同类型模板的列表:
- `SystemMessagePromptTemplate` - 包含一个`SystemMessage`类型模板,用于定义系统消息。这里的``You are a helpful assistant``是指示agent的角色和期望行为的提醒。
- `MessagesPlaceholder` - 是一个占位符,与 `chat_history` 变量相关联,并且它是可选的,这意味着在输入中不一定需要提供聊天历史。
- `HumanMessagePromptTemplate` - 包含一个`HumanMessage`类型的模板,用来定义来自用户的输入。这里的模板`{input}`将会被用户输入的实际文本替换。
- `MessagesPlaceholder` - 另一个占位符,与 `agent_scratchpad` 变量相关联。
它定义了代理(agent)如何处理消息和交互。当使用代理执行任务时,这个模板将被用来生成符合预设格式的输入,从而促进代理的正确响应和操作。
而当你使用`langchain hub.pull("hwchase17/openai-functions-agent")`从`langchain hub`中拉取这个prompt template时,你可以使用这个模板来配置你的代理(agent),使其理解并处理定义好的输入类型和消息格式,以充当一个有效和有用的助手。用户也可以根据自己的需求创造新的prompt并上传至`hub`,以适应不同的场景。
创建图状态
在创建完代理之后,接着就是定义图状态。传统LangChain代理的状态具有如下属性:
- 输入:这是代表用户主要请求的输入字符串,作为输入传递。
- 聊天历史:这是任何先前的对话消息,也作为输入传递。
- 中间步骤:代理采取的行动和相应的观察。每次代理迭代时都会更新这个列表。
- 代理结果:代理的响应,可以是AgentAction或AgentFinish。当这是AgentFinish时,AgentExecutor应该结束,否则应该调用请求的工具。
代码如下:
from typing import TypedDict, Annotated, List, Unionfrom langchain_core.agents import AgentAction, AgentFinishfrom langchain_core.messages import BaseMessageimport operator# 定义一个类型字典,用于表示代理的状态信息class AgentState(TypedDict):# 输入字符串input: str# 对话中之前消息的列表chat_history: list[BaseMessage]# 代理调用产生的结果,可能为None表示开始时没有结果agent_outcome: Union[AgentAction, AgentFinish, None]# 动作和对应观察结果的列表,使用operator.add注释说明这些状态应该被添加到现有值上intermediate_steps: Annotated[list[tuple[AgentAction, str]], operator.add]
上面代码需要说明的是:
- agent_outcome: Union[AgentAction, AgentFinish, None]:这个字段存储代理在某次调用后的结果状态。说明我们需要关注AgentAction对象(代表代理执行了某个动作)和AgentFinish对象(表明代理完成了其任务),以及None(表示代理尚未开始处理任务或没有需要返回的结果)。
- intermediate_steps: Annotated[list[tuple[AgentAction, str]], operator.add]:这是动作和观察结果组成的元组列表,通过Annotated和operator.add进行了注释。这表明要更新intermediate_steps这个字段时,应该是将新的动作和观察结果加到列表中,而不是覆盖现有的列表。operator.add用于提示这个字段的更新操作是添加性质的。
定义节点
在介绍了如何创建图状态之后,接下来要关注的是如何定义节点。在LangGraph中,节点可以是函数或可运行实体。针对我们的任务,我们需要定义两个主要节点:
- 代理节点:负责决定要采取什么行动。
- 调用工具的函数:如果代理决定采取行动,那么这个节点将执行该行动。这里的行动可以理解为通过Tavily进行网络搜索,获取“北京2024年春节的旅游情况”。
除了定义节点,我们还需要定义一些边。其中一些边可能是有条件的。这些边之所以有条件,是因为根据节点的输出,可能会采取几条不同的路径。而具体路径需要在运行节点时由大模型来确定。
有条件边:确定在调用代理后,如何动作。如果代理需要行动,那么应该调用工具;如果代理认为已经完成任务,那么它就应该结束。
普通边:在调用工具后,它应该始终返回到代理,以决定接下来要做什么。
现在,让我们定义节点,以及函数来决定采取哪种有条件边。函数将根据代理节点的输出,决定是调用工具还是结束流程。通过这种方式,可以构建一个灵活的图,能够根据不同的情况选择合适的路径。
# 导入AgentFinish类,用于标识代理执行完成状态from langchain_core.agents import AgentFinish# 导入ToolExecutor类,用于执行工具和处理代理动作from langgraph.prebuilt.tool_executor import ToolExecutor# 实例化ToolExecutor,它是一个辅助类,能够基于代理动作调用相应的工具并返回结果tool_executor = ToolExecutor(tools)# 定义代理执行逻辑的函数def run_agent(data):# 调用代理的可执行对象,传入数据data,执行代理逻辑并得到结果agent_outcome = agent_runnable.invoke(data)# 将代理的执行结果封装成字典形式返回return {"agent_outcome": agent_outcome}# 定义执行工具的函数def execute_tools(data):# 从数据中获取最新的代理执行结果(agent_outcome)agent_action = data["agent_outcome"]# 调用工具执行器,并基于代理动作执行工具,得到输出结果output = tool_executor.invoke(agent_action)# 将执行的工具及其输出结果作为中间步骤打包成元组,然后封装成字典格式返回return {"intermediate_steps": [(agent_action, str(output))]}# 定义逻辑函数,用于根据数据决定流程是否继续或结束def should_continue(data):# 如果代理的执行结果是AgentFinish,表示结果满意,代表流程结束if isinstance(data["agent_outcome"], AgentFinish):# 返回字符串'end',在设置流程图时用于标识流程的终点return "end"# 如果代理的执行结果不是AgentFinish类的实例,则代表代理流程应继续执行else:# 返回字符串'continue',在设置流程图时用于标识流程的继续点return "continue"从上面的代码可以看出,定义了三个函数。
- run_agent:用来接收数据并且执行代理。
- execute_tools:接收数据执行具体操作,在本例中用来通过搜索引擎搜索2024年春节与北京旅游相关的信息。同时,还通过intermediate_steps 记录执行的结果。由于在实际工作环境中,agent 都是发号施令的一方,而具体干活的是tools。每次tools 完成工作(本例是网络搜索)之后,都会返回信息,此时agent都会对返回的信息进行判断,如果不满意tools还要继续“工作”。基于这样的情况,每次tools 工作完毕都将结果记录到intermediate_steps中,做为存档或者是依据。
- should_continue:用来判断工作流是否继续,如果得到了结果data["agent_outcome"],那么就结束工作,否则继续工作,直到拿到结果。
定义工作流(图和边)
到这里我们有了代理、图状态、节点等信息了。为了把上述信息串联起来,需要构建一个基于状态的工作流(workflow)。工作流中包含的是有条件的和线性的节点转换,用于根据某些条件决定程序的下一步执行哪个操作。这个过程模拟了一个基于事件的系统,其中不同的状态(或称为节点)可以根据特定逻辑进行转换。代码如下:
from langgraph.graph import END, StateGraph#通过stategraph 初始化工作流workflow = StateGraph(AgentState)# 定义两个节点,在实际场景中agent下命令,action完成任务返回结果。# 结果如果不满意,agent 会继续要action完成新任务。# 看上去它们的交互式不断循环切换的workflow.add_node("agent", run_agent)# 添加节点"agent",其运行函数为 run_agentworkflow.add_node("action", execute_tools)# 添加节点"action",其运行函数为 execute_tools# 设置入口节点为 `agent`# 这意味着首先调用的节点是`agent`workflow.set_entry_point("agent")# 接下来添加有条件的边workflow.add_conditional_edges(# 定义起始节点,这里使用`agent`"agent",# 判断是否继续的函数节点,用于决定下一个节点是哪个的函数should_continue,# 定义映射字典# 键为字符串,值为其他节点# END 是结束节点# 调用`should_continue`后,输出将根据这个映射找到匹配的键# 根据匹配结果,接下来会调用相应的节点{# 如果是`continue`,则调用工具节点`action`"continue": "action",# 否则结束流程"end": END,},)# 添加普通边从`action`到`agent`# 这意味着在`action`被调用后,下一个调用的节点是`agent`workflow.add_edge("action", "agent")# 对工作流进行编译# 编译成 LangChain 可运行对象# 可以这个对象app = workflow.compile()代码比较长,我们对其进行拆解并解释如下:
- 定义工作流:使用StateGraph创建了一个名为workflow的新工作流实例,这个工作流将要基于一种名为AgentState的状态。
- 添加节点:向工作流中添加了两个节点("agent"和"action"),它们分别关联了各自的处理函数run_agent和execute_tools。
- 设置入口点:"agent"被设置为工作流的入口点,这意味着它是工作流开始执行时第一个被调用的节点。
- 添加有条件的边:通过add_conditional_edges方法,为从"agent"节点出发的边添加了条件。
- 使用should_continue函数来评估条件,根据返回值决定下一个执行哪个节点。
- 如果should_continue返回"continue",流程将移动到"action"节点;如果返回"end",则工作流将结束。
- 添加普通边:通过add_edge方法添加了一个从"action"到"agent"的单向边。这个边代表在"action"节点执行后,下一步将回到"agent"节点继续执行。
- 编译工作流:最后,通过调用compile方法,将之前定义的工作流编译成一个可执行的对象app。
这段代码定义了工作流,加入了节点,并且设计了边,我们通过下面这张图来理解其原理。Agent作为整个工作流进入的节点,在最左侧。Agent和Action组成了一个普通边,这个很好理解,由Agent发起搜索任务,而Action是来完成这个任务的。接着,Agent 与should_continue 函数,通过设置条件创建了一个条件边。Should_continue函数本身不是节点,只是一个判断条件,从函数内容中可以看出,如果Action得到结果就结束工作流(End),否则就继续执行搜索任务(continue)。为了便于理解,我们用棱形来表示,当Action执行之后通过should_continue 进行判断,然后选择正确的分支。如果选择continue这条,就意味着整个工作流形成了一个环,如果Action的工作一直无法should_cointnue ,也就是一直不能让Agent满意的话,就需要不断重复执行搜索工作,直到超过执行次数从而退出。
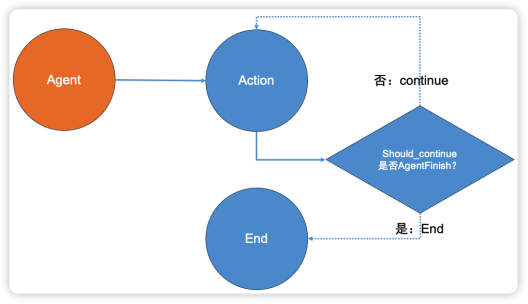
执行搜索任务
通过上面一顿操作,工作流已经创建完毕,接着就可以执行它了。上代码:
inputs = {"input": "2024年春节北京的旅游情况如何", "chat_history": []}for s in app.stream(inputs):print(list(s.values())[0])print("----")我们询问“2024年春节北京的旅游情况如何”,通过工作流实例输出结果如下图所示:
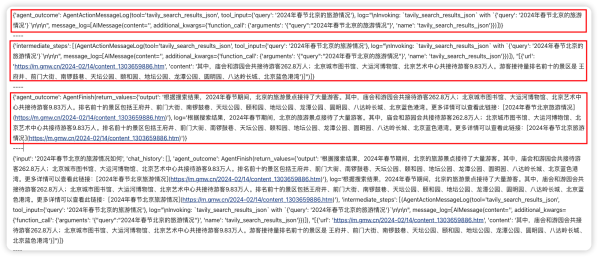
第一个agent_outcome,很明显在agent发出命令的时候,tavily搜索工具开始工作。
接着,tavily 搜索工具记录搜索的中间步骤,包括从什么网站地址获取了相关信息。此时第二个agent_outcome 的内容标志为AgentFinish,意思是Agent对结果是满意的,因此可以结束任务了,同时给出了搜索的最终结果,和我们的预期保持一致。
总结
LangGraph技术在处理复杂任务方面具有明显优势,通过循环图的方式,使大模型和外部工具协同工作,实现多轮对话和调整,从而更好地逼近最终答案。该技术具有广阔的应用前景,能够显著提高工作效率和解决问题的能力。不过,创建LangGraph应用也需要一定的技术门槛,需要理解状态图、节点和边的概念,并编写相应的代码实现。未来,LangGraph有望成为处理复杂任务的重要技术手段。
作者介绍
崔皓,51CTO社区编辑,资深架构师,拥有18年的软件开发和架构经验,10年分布式架构经验。







Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Xcode 是苹果面向 Mac 提供的官方集成开发环境,将代码编辑、项目构建、SwiftUI 实时预览、设备模拟、自动化测试、断点调试、性能分析和应用分发整合在同一套工作流中,适合开发与维护 iPhone、iPad、Mac、Apple Wa

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

PhpStorm 是 JetBrains 推出的专业 PHP 集成开发环境,可在 Mac 上完成代码编写、智能检查、重构、调试、测试和数据库管理。它支持主流 PHP 框架、Composer、Git、Docker 与远程解释器。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

Visual Studio Code 是微软提供的免费代码编辑器,支持 macOS,并为 Intel 与 Apple 芯片 Mac 提供适配版本。软件集代码编辑、调试、Git 源代码管理、集成终端和扩展市场于一体。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

Adobe Audition 是面向播客、影视后期、音乐制作及内容创作者的专业音频工作站,提供波形精修、多轨录制与混音、频谱编辑、降噪修复、响度匹配和效果处理工具,并可与 Adobe Premiere 协同完成视频声音制作。

Pro Tools 是 Avid 推出的专业数字音频工作站,覆盖多轨录音、无损剪辑、MIDI 编曲、插件处理、自动化混音及声音与画面同步等工作。它拥有 Intro、Artist、Studio 和 Ultimate 等方案。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,

WebStorm 是 JetBrains 面向 JavaScript、TypeScript 和现代 Web 技术打造的集成开发环境。它提供项目级代码分析、智能补全、安全重构、导航搜索,并集成调试、测试、终端、Git 与常用前端工具,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

Visual Studio Code 是微软推出的免费代码编辑器,Windows 版集成智能补全、代码导航、调试、终端和版本控制,并可通过扩展添加语言、格式化及远程开发能力。它启动较快、配置灵活,

REAPER 是 Cockos 推出的数字音频工作站,适用于录音、MIDI 编曲、音频编辑、混音、母带制作及声音设计。软件安装包小巧,支持多轨录制、灵活路由、自动化、第三方插件和脚本扩展,并提供完整功能的 60 天免费评估期。

Adobe Audition 是面向播客、影视后期、广播与音乐制作的专业音频工作站,提供波形编辑、多轨混音、频谱分析、录音、降噪修复和效果处理等功能。Windows 版通过 Adobe Creative Cloud 安装和管理,

Pro Tools 是 Avid 推出的专业数字音频工作站,提供多轨录音、音频剪辑、MIDI编曲、插件处理、自动化混音及影视声音制作能力。它适合音乐人、录音师、制作人和音频后期团队使用,并提供免费入门版、订阅方案及永久授权选择。