


DeepSeek-V4-Pro思考模式怎么调推理强度
DeepSeek-V4-Pro的推理强度可通过API的reasoning_effort设置为low、high或max,并配合thinking启用思考模式;网页和App通常只提供模式切换,不一定开放细粒度强度。本文给出参数、代码和无效配置排查方法。
DeepSeek-V4-Pro的推理强度可通过API的reasoning_effort设置为low、high或max,并配合thinking启用思考模式;网页和App通常只提供模式切换,不一定开放细粒度强度。本文给出参数、代码和无效配置排查方法。
DeepSeek-V4-Pro思考模式在哪里调推理强度?
API用户可以用reasoning_effort调节推理强度,网页和App用户通常只能选择普通或专家模式,是否显示细分强度以当前界面为准。
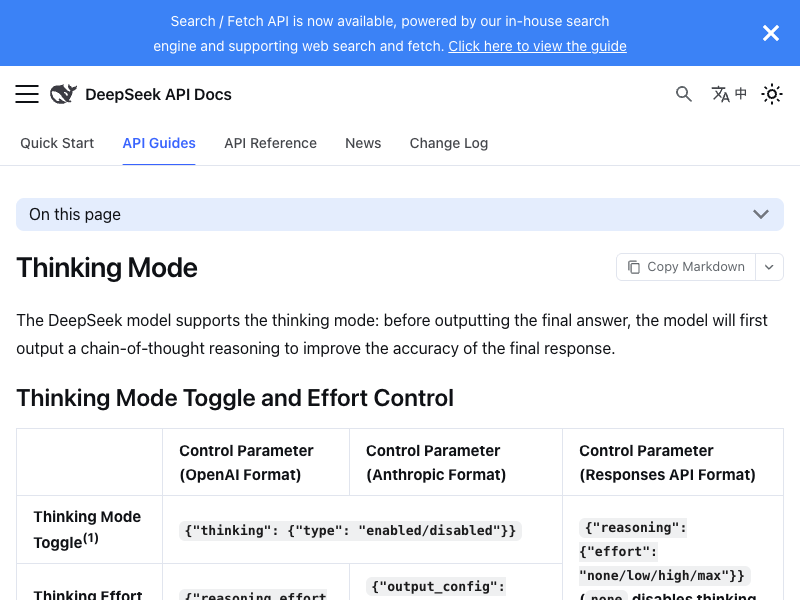
官方文档列出的主要强度为 low、high、max。其中high是默认的常用复杂任务档位,max适合最难的推理和Agent任务;简单任务选择low可以减少等待。
OpenAI兼容接口如何设置reasoning_effort?
在OpenAI兼容的Chat Completions接口中,需要同时指定deepseek-v4-pro、reasoning_effort和thinking开关。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[{"role": "user", "content": "比较两套数据库迁移方案并给出风险清单"}],
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}},
)

print(response.choices[0].message.content)
不要把API密钥直接写入代码或截图,示例使用环境变量读取。首次测试建议先用high,只有结果仍缺少必要分析时再提高到max。
low、high和max分别适合哪些任务?
low适合简单且时效优先的任务,high适合日常复杂分析,max适合错误成本高、需要多轮工具调用的难题。
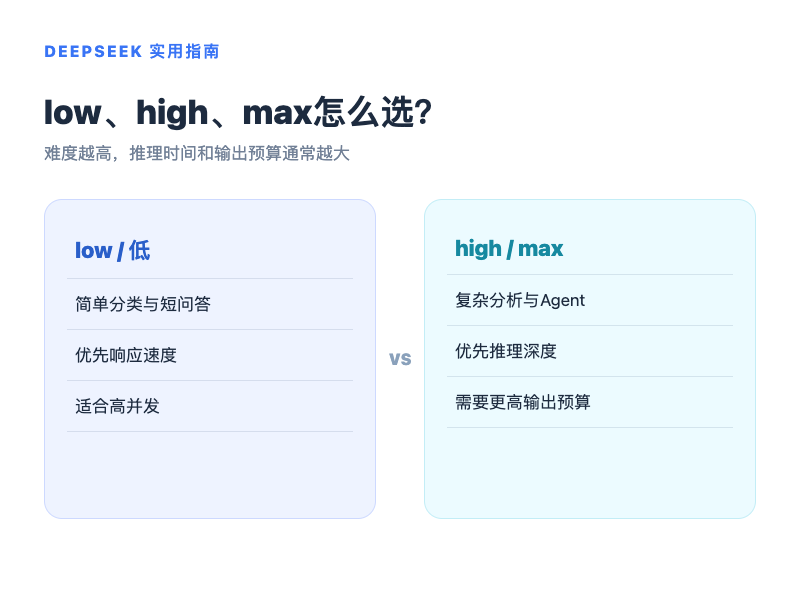
| 强度 | 适合任务 | 不建议使用的情况 |
|---|---|---|
| low | 分类、改写、短摘要、简单抽取 | 复杂证明、长链Agent任务 |
| high | 代码分析、方案比较、日常Agent工作 | 只需一句话结果的高并发任务 |
| max | 复杂规划、疑难调试、关键推理 | 预算敏感或低延迟接口 |
设置推理强度后没有变化怎么检查?
没有变化时先确认实际调用模型和thinking状态,再检查是否错误地只读取了reasoning_content或content其中一个字段。
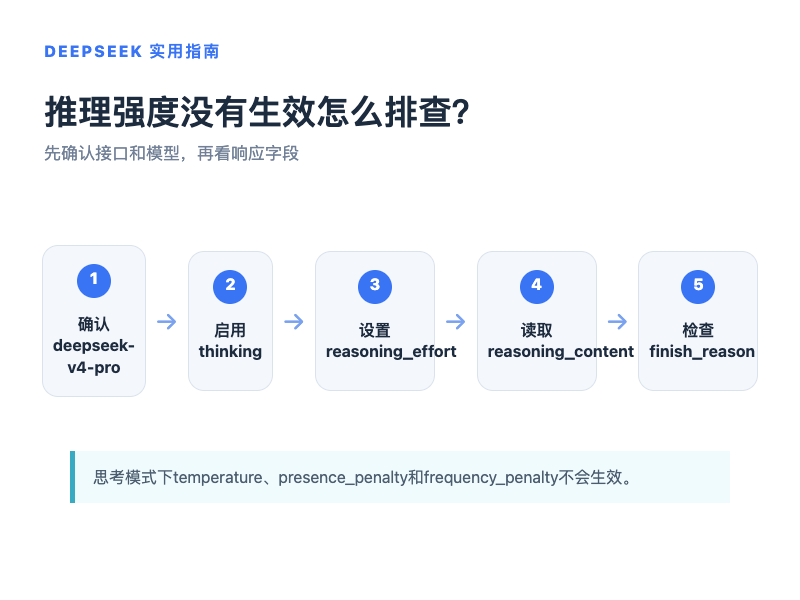
- 打印响应中的model,确认请求没有被代理层改写。
- 确认thinking为enabled,关闭思考时reasoning_effort没有相同含义。
- 思考过程在reasoning_content,最终答案在content,不要把两者混为一项。
- 检查finish_reason和输出预算,避免推理占用预算后最终答案被截断。
- 思考模式下temperature等参数可能被忽略,不要用温度判断强度是否生效。
推理强度越高回答效果一定越好吗?
推理强度越高不代表所有任务都会更好,简单任务可能只增加延迟和消耗,复杂任务才更可能从额外推理预算中受益。
选择强度时应固定提示词和验收标准,用low、high、max分别测试同一组样本,比较正确率、响应时间和成本。若high已经稳定达到要求,就没有必要长期使用max。
推理强度也不能弥补缺失输入。资料不完整、目标冲突或工具结果错误时,应先修正上下文,再考虑提高强度。
推理强度设置还有哪些常见误区?
把temperature调低能代替提高推理强度吗?
不能。官方文档说明思考模式下temperature不会生效,推理深度应通过reasoning_effort控制。
只读取reasoning_content为什么没有最终答案?
reasoning_content是思考内容,最终可展示答案仍在content,应用需要分别处理两个字段。
max输出被截断应该继续提高强度吗?
不应该先提高强度。应检查输出预算、上下文长度和任务拆分,给最终答案保留足够Token。
不同任务可以在一次请求中使用不同强度吗?
一次请求只能使用该次提交的强度设置。需要分阶段处理时,可以先用low分类和整理,再用high或max处理筛选出的复杂部分,同时保存每阶段输入输出和耗时,便于确认提高强度是否真的带来收益。
工具调用失败是否应该直接改成max?
不应该。先检查工具Schema、参数、权限和reasoning_content回传是否正确;只有工具链配置无误但任务推理仍不足时,才值得提高强度继续测试,并记录调整前后的结果差异。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,