


EndNote导入文献教程:RIS题录与PDF批量导入设置指南
EndNote是一款跨平台的知名文献管理工具。文献管理、引用整理和学术写作之间的衔接会更顺,适合论文撰写和研究资料长期积累这类场景。
掌握 EndNote 导入文献的核心步骤。本文介绍如何在 Windows 环境下正确导入 RIS、EndNote 标记格式及 PDF 文件,解决过滤器选择、字符编码及重复记录处理问题,确保元数据准确入库。
在 EndNote 中建立文献库时,最基础也最关键的一步是将外部文献数据准确导入。直接拖拽文件往往只能添加附件而无法生成完整的题录信息,导致后续引用时缺少作者、年份等关键元数据。通过规范的导入流程,可以确保 RIS 等结构化数据进入正确字段,或利用 PDF 自动识别功能补充全文附件。
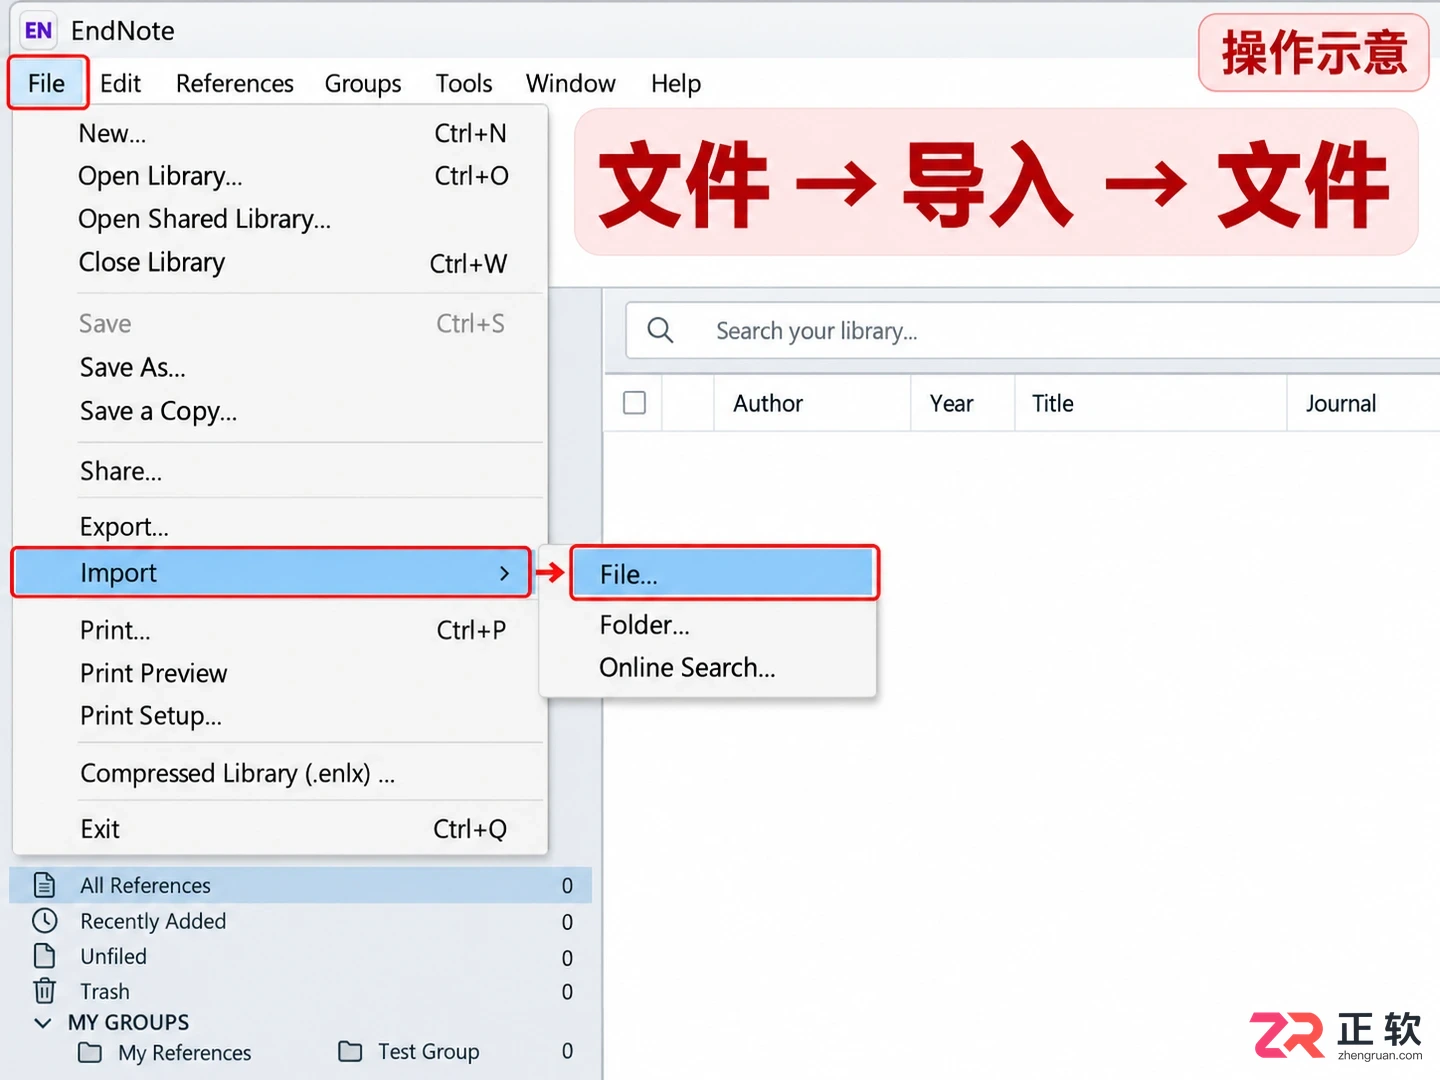
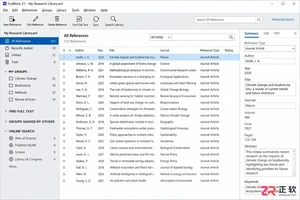
EndNote 主界面及 File 导入入口
导入前需明确一点:题录文件(如 .ris, .txt)与全文 PDF 的处理逻辑不同。前者包含结构化的 bibliographic data,后者主要依靠软件从文本层提取 DOI 进行匹配。以下操作基于 Windows 桌面版 EndNote,按实际工作流顺序展开。
1. 准备文献库和导出的题录文件
首先打开目标 EndNote 库,建议对重要数据进行备份。从 Web of Science、PubMed 或知网等数据库导出文献时,请选择 EndNote 支持的格式。常见的有 RIS 格式(通用性强)或 EndNote 专用导出格式。
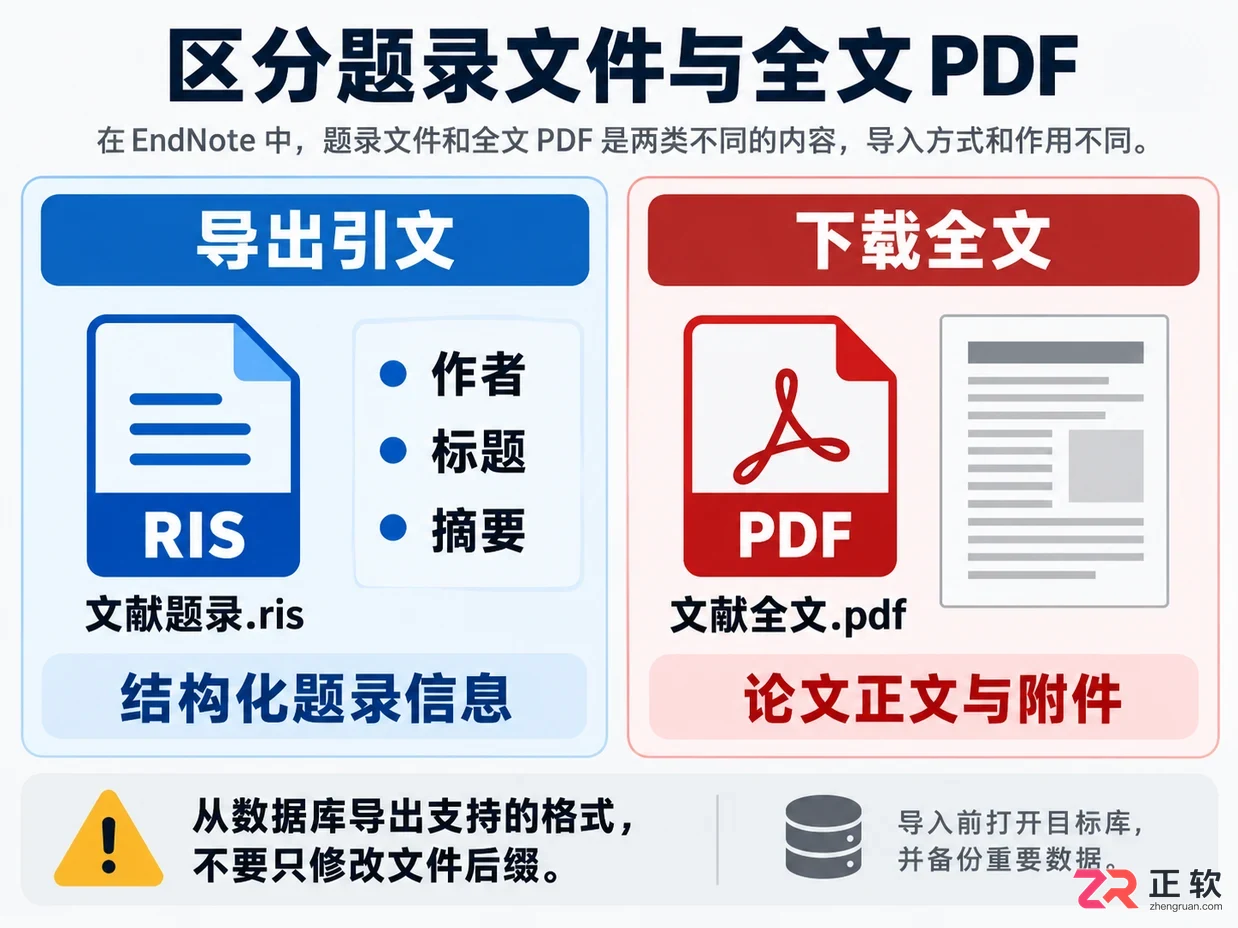
注意区分“下载全文”和“导出引文”。导出的文件通常是几 KB 的文本文件,包含了作者、标题、摘要等信息;而 PDF 是几 MB 的全文文档。不要手动将网页复制的内容保存为 .ris 后缀,这种文件内部缺乏标准标记,无法被软件正确解析。
1. 准备文献库和导出的题录文件
2. 通过文件导入 RIS 或其他题录
在 EndNote 主界面,点击菜单栏的【File】→【Import】→【File】。在弹出的对话框中,点击【Choose】选中刚才下载的题录文件。
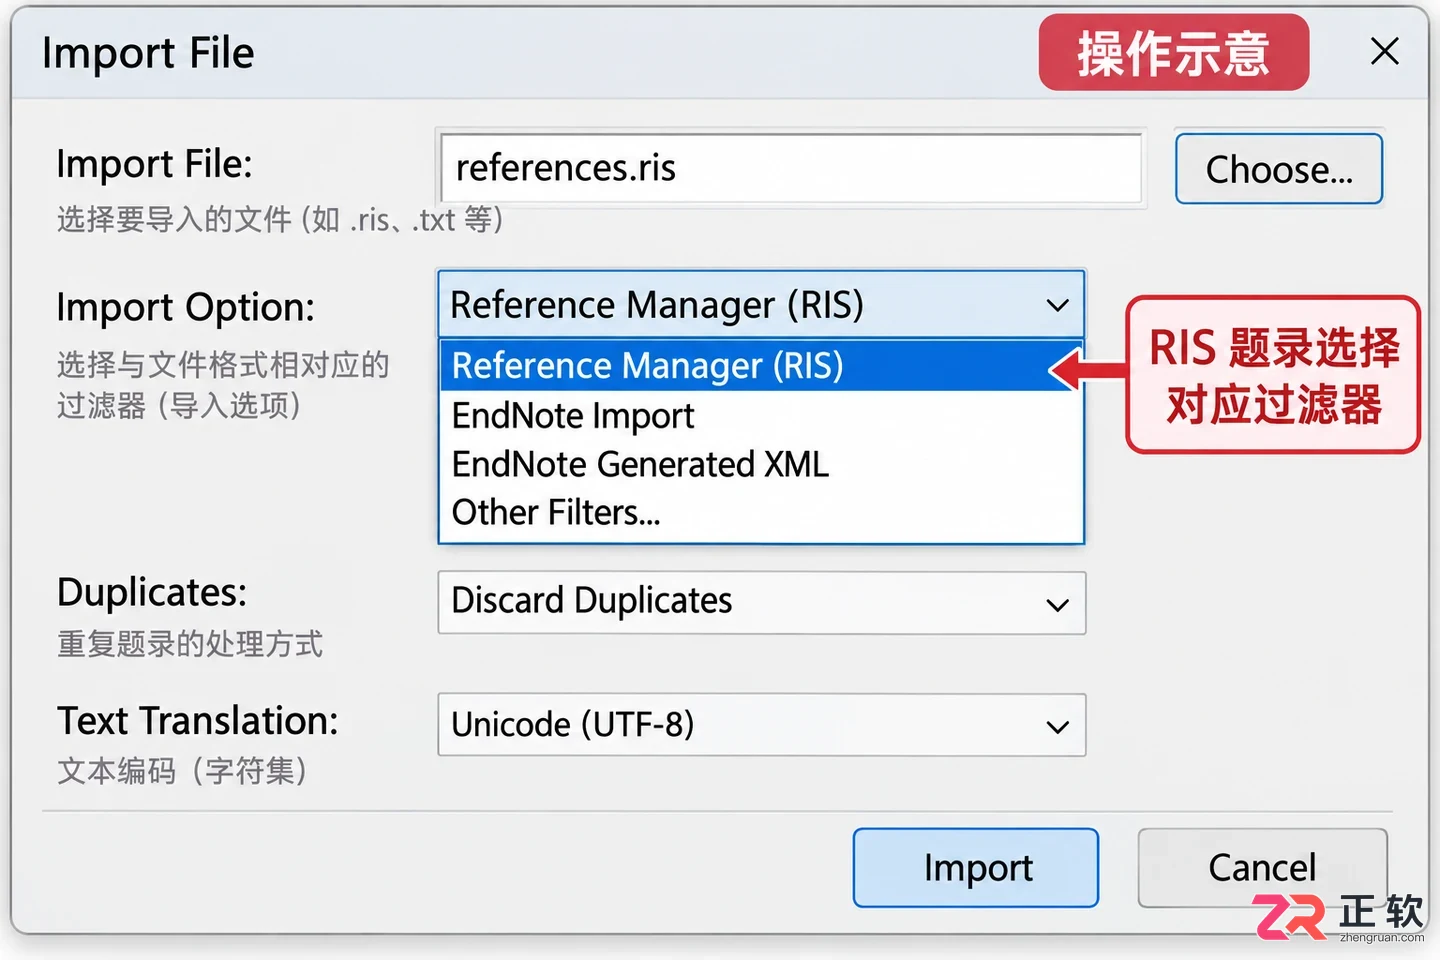
导入文件对话框中的过滤器选择
关键步骤在于【Import Option】的选择:
- RIS 文件:通常选择 Reference Manager (RIS)。这是最通用的过滤器,适用于大多数数据库导出的 .ris 文件。
- EndNote 导出文件:如果来源是其他 EndNote 库或支持该格式的数据库,选择 EndNote Import。
- XML 文件:部分现代数据库提供 XML 格式,需选择 EndNote Generated XML。
如果下拉列表中没有合适的选项,点击【Other Filters】查找与来源数据库名称匹配的过滤器。切勿因为文件扩展名是 .txt 就随意选择 Text File 或 EndNote Import,这会导致所有信息挤在一个字段中。
在【Duplicates】选项中,若希望避免重复录入,选择 Discard Duplicates;若需保留所有记录以便后续去重,选择 Import All。【Text Translation】通常保持默认 Unicode (UTF-8),若导入后出现中文乱码,可尝试改为 GBK 或重新检查源文件编码。
点击【Import】开始导入。进度条结束后,左侧分组栏会出现一个名为 Imported References 的临时分组,其中包含了本次导入的所有记录。
3. 检查 Imported References 中的字段
导入完成后,务必进入 Imported References 分组抽查数据质量。随机点击几条记录,检查右侧预览窗格或编辑窗格中的 Author、Year、Title、Journal 等字段是否分离正确。
如果发现作者名和标题混在一起,或者年份缺失,说明【Import Option】选择错误。此时应删除这些记录,重新执行导入步骤并更换过滤器。确认无误后,可以将这些记录移动到你建立的特定主题分组中。Imported References 是一个动态分组,下次导入新文献时,它会自动更新为新导入的记录,因此不要依赖它来长期管理文献。
4. 使用 PDF 生成记录或附带全文
如果你手头只有 PDF 文件而没有题录文件,可以尝试让 EndNote 自动创建记录。同样进入【File】→【Import】→【File】,选中 PDF 文件,但在【Import Option】中选择 PDF。
软件会扫描 PDF 的第一页或元数据,尝试提取 DOI 或标题,并联网检索以补全作者、期刊等信息。如果成功,你会看到一条带有附件的新记录;如果失败,可能只生成一个以文件名命名的空记录,或者提示未找到匹配项。
注意:扫描件、图片型 PDF 或缺少 DOI 的预印本,自动识别成功率较低。对于已通过 RIS 导入的文献,建议直接将 PDF 拖拽到对应记录上作为附件,而不是再次导入 PDF 生成重复记录。
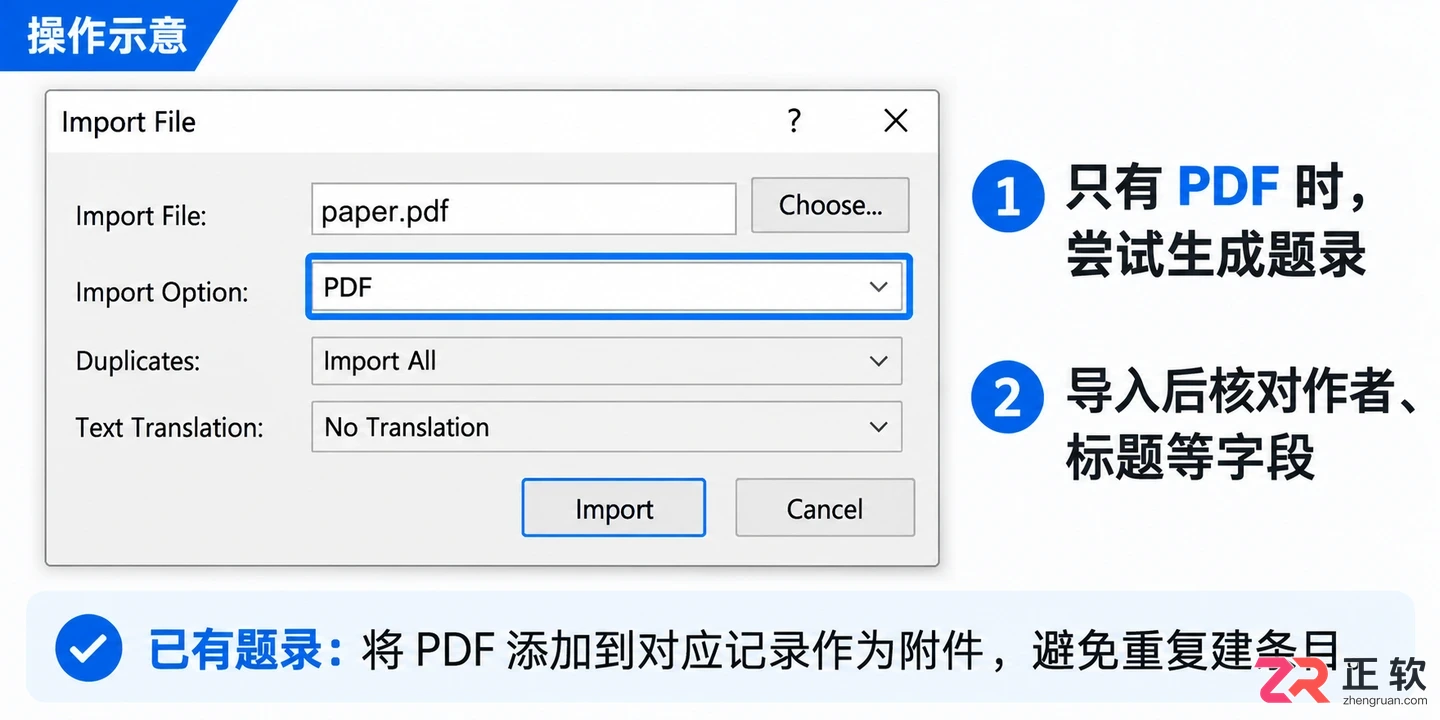
4. 使用 PDF 生成记录或附带全文
5. 批量导入 PDF 文件夹并保存结果
当需要处理大量已下载的 PDF 时,使用文件夹导入更高效。点击【File】→【Import】→【Folder】。
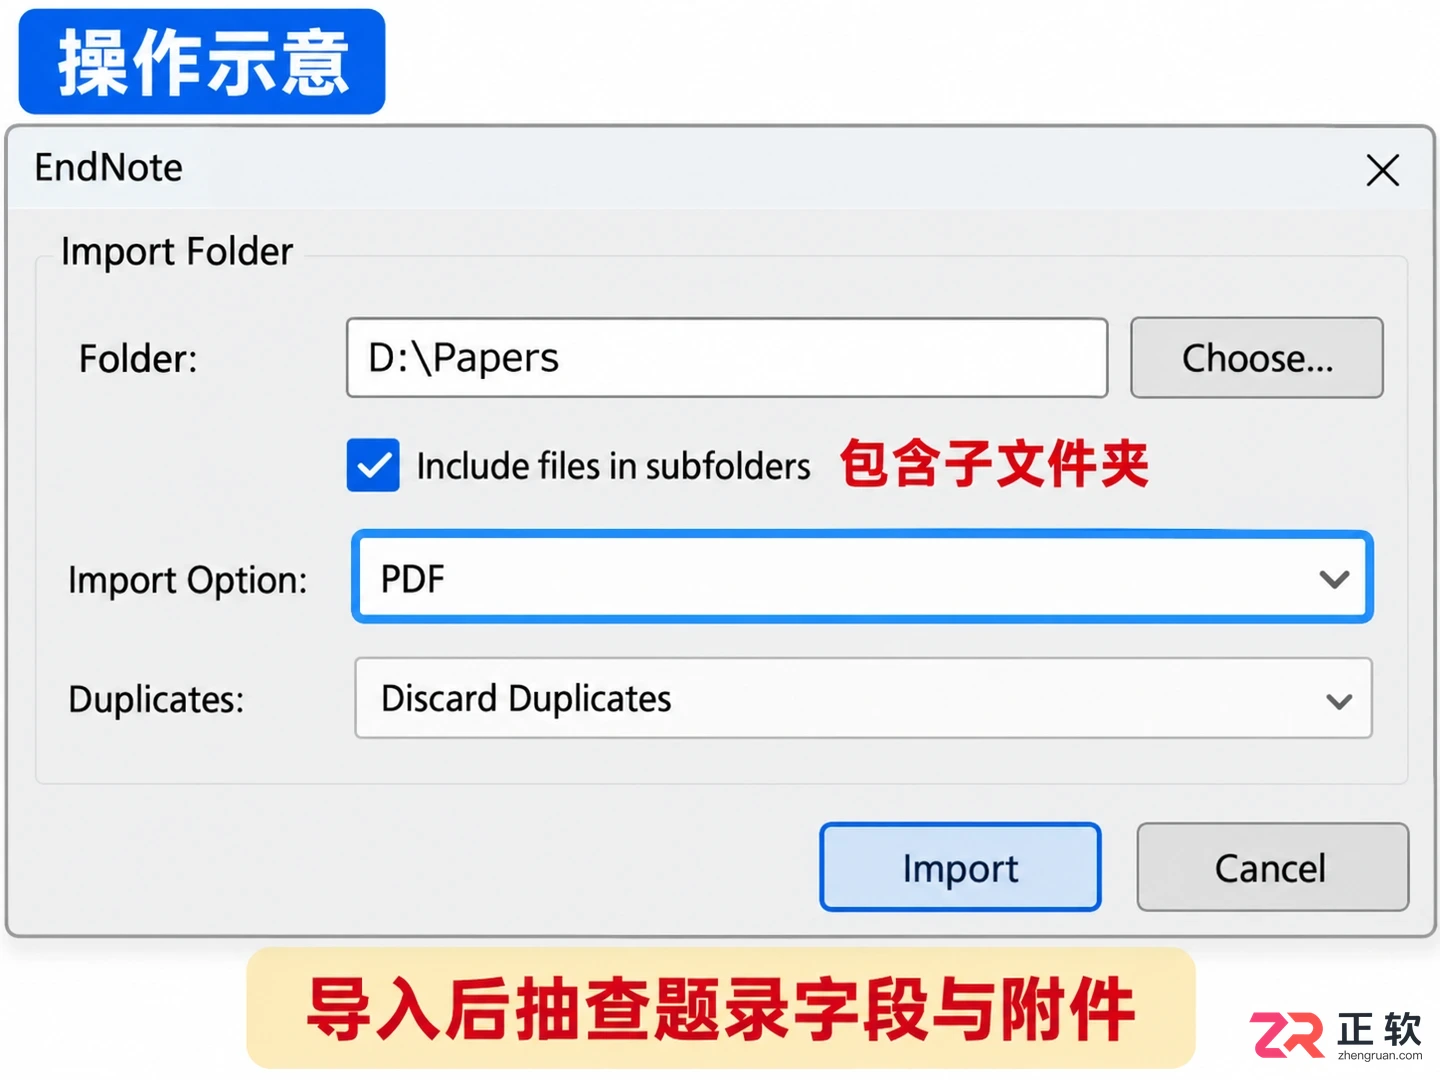
批量导入文件夹设置界面
在对话框中指定包含 PDF 的文件夹路径。勾选 Include files in subfolders 可递归导入子目录中的文件。【Import Option】依然选择 PDF。设置好重复记录处理方式后点击【Import】。
导入过程可能需要较长时间,取决于文件数量和网速(用于在线匹配元数据)。完成后,同样需要进入 Imported References 分组进行抽检。重点检查那些识别失败的记录,手动补充缺失的元数据。对于无法自动匹配的 PDF,可能需要人工检索题录后合并。
最后,确认文献库中的记录均可正常打开附件,且关键字段完整。定期清理 Imported References 分组中的无效记录,保持库的整洁。导入只是第一步,后续的分组管理和去重同样重要。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。