


WPS怎么把PDF转成TXT?PDF转TXT乱码怎么处理
本文围绕WPS怎么把PDF转成TXT,分别介绍PDF.cn在线转换、汇帮PDF转换器本地导出,以及WPS转图片后配合OCR识别三条路线,并说明扫描件、复杂排版和字体映射导致乱码时,如何判断文本层、切换UTF-8编码、核对段落顺序与抽查关键数据,帮助完成PDF转TXT后的结果验收。
WPS中的PDF既可以直接尝试提取文字,也可以换用在线工具或本地转换器。普通文字型文件可先打开PDF转TXT上传转换;如果结果出现乱码,应先判断PDF有没有可选中的文本层,再检查TXT编码、原文件字体映射和多栏阅读顺序。扫描件通常需要先做OCR,不能只靠格式转换。
方法一:使用PDF.cn在线提取文字
适合场景:文件能够正常打开、页面文字可以选中,希望快速得到纯文本内容。它不适合直接恢复图片、表格线和复杂排版;带密码的PDF也应先由文件所有者正常解锁。
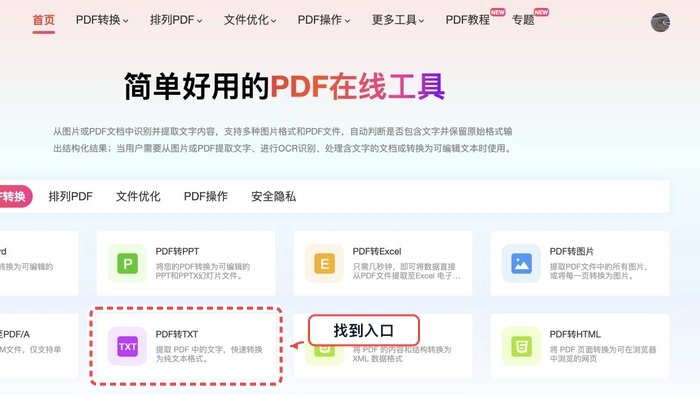
第1步:进入极轻PDF网站,在工具列表中找到PDF转TXT入口。先核对转换方向,避免误入PDF转Word、PDF转图片等其他功能。
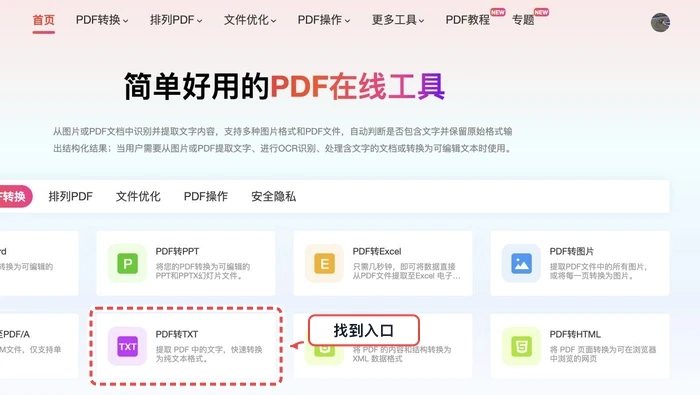
找到工具入口
第2步:在上传区域点击“选择PDF文件”,加入需要转换的文档。上传前可先确认文件名和内容,避免把相似文件选错。
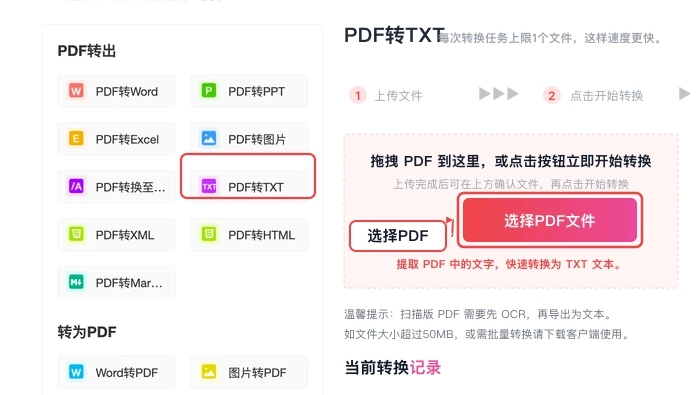
选择并上传文件
第3步:等待文件出现在任务区,重点核对文件名、大小和“上传成功”状态。状态未确认前不要急着开始转换,以免处理到不完整的文件。
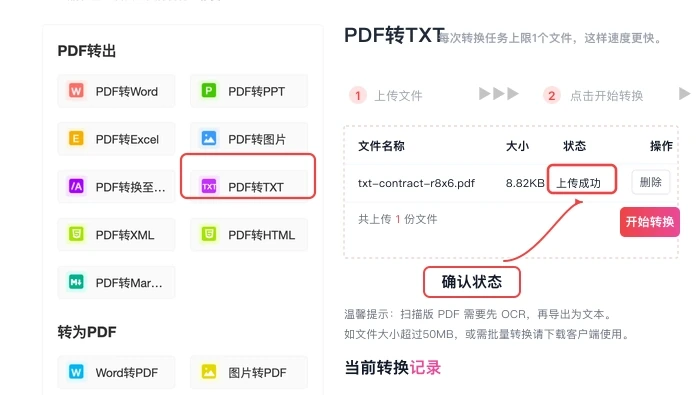
核对上传状态
第4步:上传完成后点击“开始转换”。当前页面没有显示额外选项时,不必自行虚构参数或反复改动文件,按页面提供的流程处理即可。
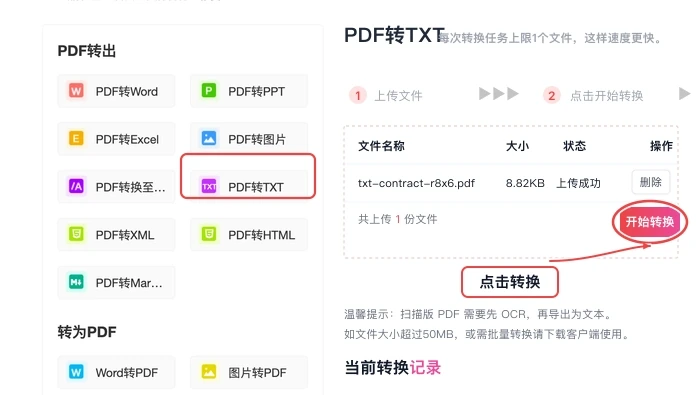
设置参数并开始处理
第5步:任务显示转换完成后下载TXT文件。不要只看进度达到100%,还要实际打开结果,检查首段、末段、数字、标点和换行是否正常。
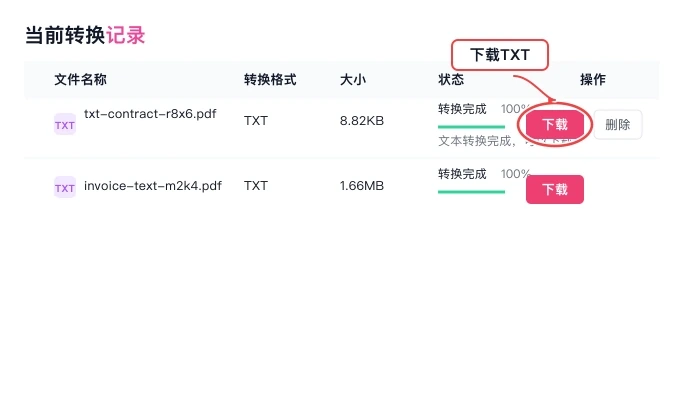
下载结果并检查
完成后检查:用支持编码切换的文本编辑器打开TXT。如果中文显示成问号、方框或无规律字符,可分别尝试UTF-8、GB18030等编码;若切换编码仍无效,回到在线PDF转TXT重新处理一份,并判断原PDF是否缺少可用文本层。
方法二:用本地PDF转换器批量导出TXT
适合场景:需要在本机连续处理多个文件,或在线上传不方便。以下图片展示汇帮PDF转换器的本地操作界面;不同安装环境的栏目位置可能变化,应以当前软件实际显示为准。
第1步:启动转换器,在首页进入“PDF转文件”分类,再选择与TXT输出相符的功能。此处只确认入口和转换方向,不根据截图推断价格、速度或版本能力。
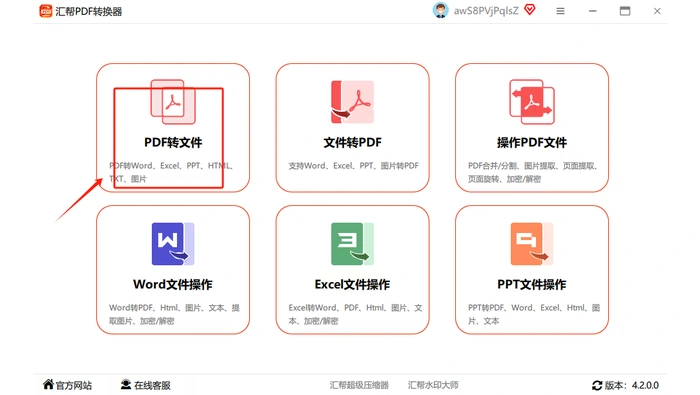
PDF转TXT替代方法操作示意
第2步:添加PDF后执行转换,并查看成功与失败数量。任务完成后打开输出目录,确认已生成对应的TXT文件;若批量任务中存在失败项,应单独重试该文件,而不是默认整批都已成功。
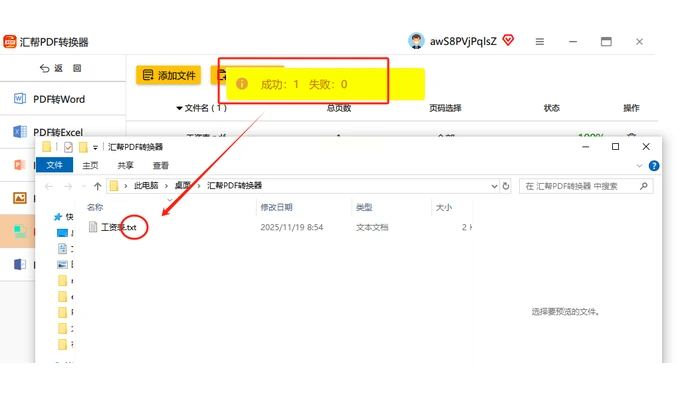
PDF转TXT替代方法操作示意
限制与验收:本地转换器仍依赖PDF内部的文字编码。建议随机抽查每个文件的标题、日期、金额和页尾,并比较输出文件数与输入文件数。多栏页面可能出现阅读顺序错乱,表格也可能变成按行拆开的纯文本,不能承诺完整保留原排版。
方法三:WPS先转图片,再用OCR保存TXT
适合场景:PDF中的文字无法选中、直接转换后为空,或者字体映射异常导致持续乱码。此路线把每页内容先变成清晰图片,再利用当前设备已有的OCR功能识别文字,步骤比直接转换多,但更适合扫描件。
第1步:在WPS的PDF界面中使用可见的PDF转图片功能,选择需要处理的页面和输出位置。图片格式以界面实际提供的选项为准,导出后先检查页面是否完整、文字是否清楚。
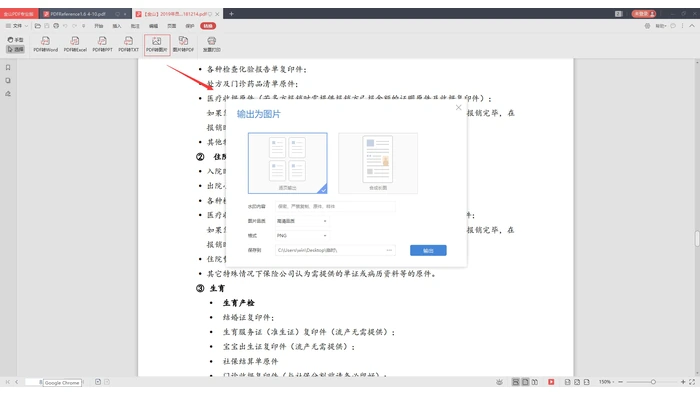
PDF转TXT替代方法操作示意
第2步:进入WPS PDF Tools页面确认当前环境可用的PDF处理入口。导出图片本身不等于得到TXT;接下来需用WPS或系统已有的图片文字识别功能逐页OCR,把识别结果粘贴到纯文本编辑器中,并以UTF-8编码保存为TXT。
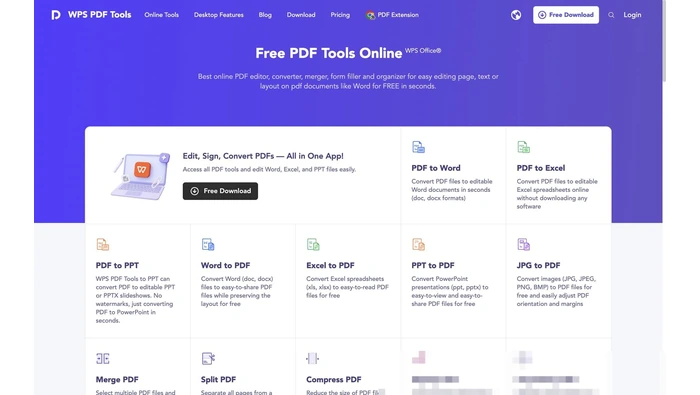
PDF转TXT替代方法操作示意
限制与验收:OCR效果受分辨率、倾斜、阴影、印章和生僻字影响。完成后应逐页检查姓名、编号、金额、小数点及相似字符,例如“0”和“O”、“1”和“l”。原文件是双栏或含大量表格时,还要重新整理段落顺序。
PDF转TXT乱码排查表
| 现象 | 常见原因 | 处理方法 |
|---|---|---|
| 中文变成问号或方框 | 打开TXT时编码识别错误 | 切换UTF-8或GB18030后重新打开 |
| 字符无规律错乱 | PDF字体映射或字符表异常 | 改用OCR路线,并与原页逐段核对 |
| TXT为空 | 页面只有扫描图片,没有文本层 | 先转为清晰图片,再执行OCR |
| 段落顺序混乱 | 双栏、文本框或复杂版面影响读取顺序 | 按原PDF页面人工重排,重点核对跨页内容 |
| 部分字缺失 | 原页模糊、字体未嵌入或OCR误识别 | 提高页面清晰度,局部重新识别并人工校正 |
怎么选择更省事
- 少量文字型PDF:优先使用在线转换,完成后检查编码和段落。
- 多个文件连续处理:选择本地转换器,重点核对成功数量和输出文件数。
- 扫描件或持续乱码:直接转入WPS导出图片加OCR路线,避免反复做无效转换。
- 表格、多栏和复杂版面:把TXT作为文字提取结果使用,不要期待完整恢复原有排版。
常见问题
转换完成后为什么看起来仍是乱码?
先用其他文本编辑器打开同一文件并切换编码。如果多种编码下字符都无规律,问题通常来自PDF内部字体映射,应改用OCR重新识别。
WPS能不能保留PDF里的表格格式?
TXT只保存纯文本,无法保留单元格、图片和复杂样式。需要继续编辑表格时,应考虑其他目标格式,并在转换后逐项核对。
扫描PDF为什么不能直接提取文字?
扫描PDF的页面通常是图片,没有可直接读取的字符层,因此要先OCR。识别完成后仍需人工检查数字、专有名词和标点。
相关工具与参考来源
需要再次转换时,可从PDF转TXT工具重新进入,并优先使用原文件做测试,避免拿已经损坏的中间文件反复转换。
- 极轻PDF在线工具首页
- PDF转TXT相关操作参考
转换结果是否可靠,最终要看文字层、编码和抽查结果,而不是只看“转换完成”。后续遇到其他PDF提取、转换或排版问题,可以继续关注极轻PDF网站的实用工具与操作内容。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。