


navicatformysql导入sql文件错误
Navicat for MySQL 12是一款具备多项改进和新功能,能满足你对数据库开发的需求。过百种增强的功能和耳目一新的界面,让你以崭新的方式创建、管理和维护数据库。Navicat for MySQL 是管理和开发 MySQL 或 MariaDB 的理想解决方案。它是一套单一的应用程序,能
遇到Navicat for MySQL导入SQL文件错误?本教程详解如何记录关键报错、正确选择运行SQL文件入口、处理UTF-8编码及MySQL版本兼容性问题(如utf8mb4_0900_ai_ci),并在测试环境中安全验证导入结果。
在 Navicat for MySQL 中导入 SQL 文件时出现错误,往往是因为编码不匹配、目标数据库版本差异或脚本中包含不兼容的语法。直接勾选“遇到错误继续”可能会掩盖建表失败等关键问题,导致后续数据插入连锁报错。正确的做法是先保留第一条错误信息,核对文件编码与服务器兼容性,并在独立的测试数据库中完成完整导入验证,确保数据结构与内容准确无误后再进行正式恢复。
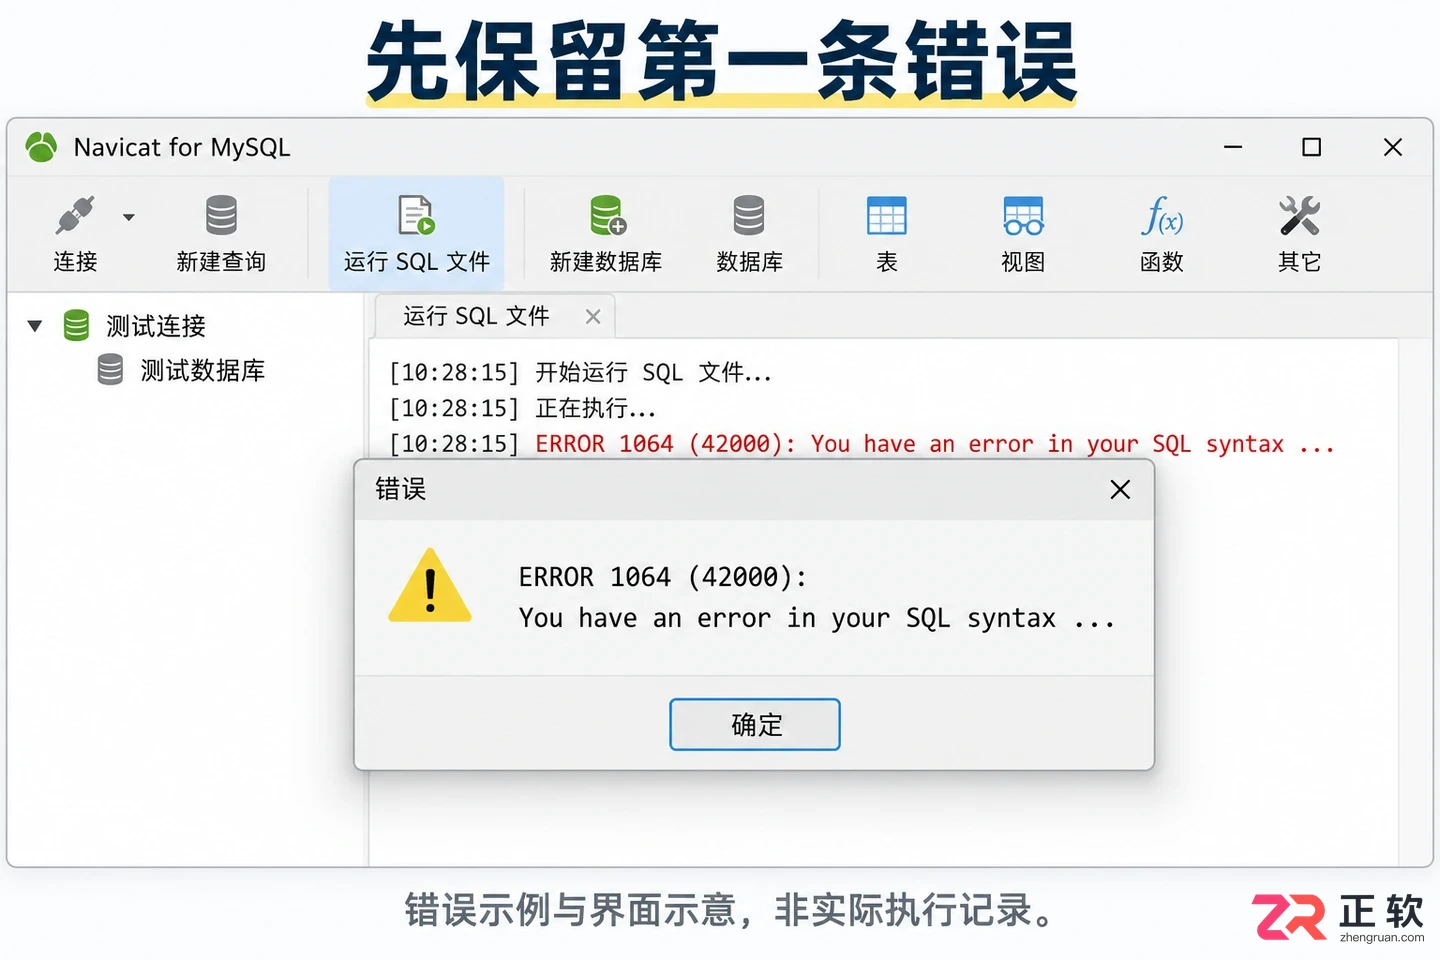
Navicat 导入 SQL 文件时的错误提示窗口,显示第一条关键报错信息
1. 记录首条错误和已经执行的范围
当导入过程中断或弹出错误提示时,不要立即关闭窗口或重新点击开始。首先查看错误日志窗口,找到第一条报错信息。这条信息通常揭示了根本原因,例如建表语句语法错误或权限不足,而随后的“表不存在”或“插入失败”往往是由此引发的连锁反应。
同时,记下当前的连接名称、服务器地址、数据库名以及导入开始的时间。核对这些信息以确认没有误连到生产环境。如果之前已经部分执行了脚本,可能已经创建了部分表或插入了少量数据。此时不应直接重试,而应先评估当前数据库的状态,必要时联系数据库管理员协助清理残留对象或回滚事务。
务必保留原始的 SQL 文件副本,所有的调整和修改都在副本上进行。SQL 脚本中可能包含 DROP TABLE、CREATE DATABASE 或 USE 语句,这些操作具有破坏性或指向性,不能仅凭文件扩展名就假设它只会增加数据。
2. 选对数据库和执行入口
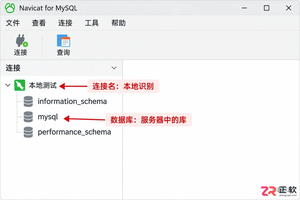
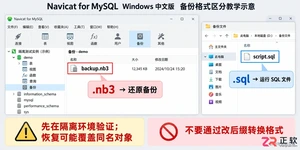
在 Navicat 左侧导航栏中,展开目标连接,选中预先准备好的独立测试数据库。右键点击该数据库,在菜单中选择【运行 SQL 文件】。这是执行完整 SQL 脚本的正确入口,切勿将其当作 CSV 或 Excel 文件使用“导入向导”,后者无法处理建表等 DDL 语句。
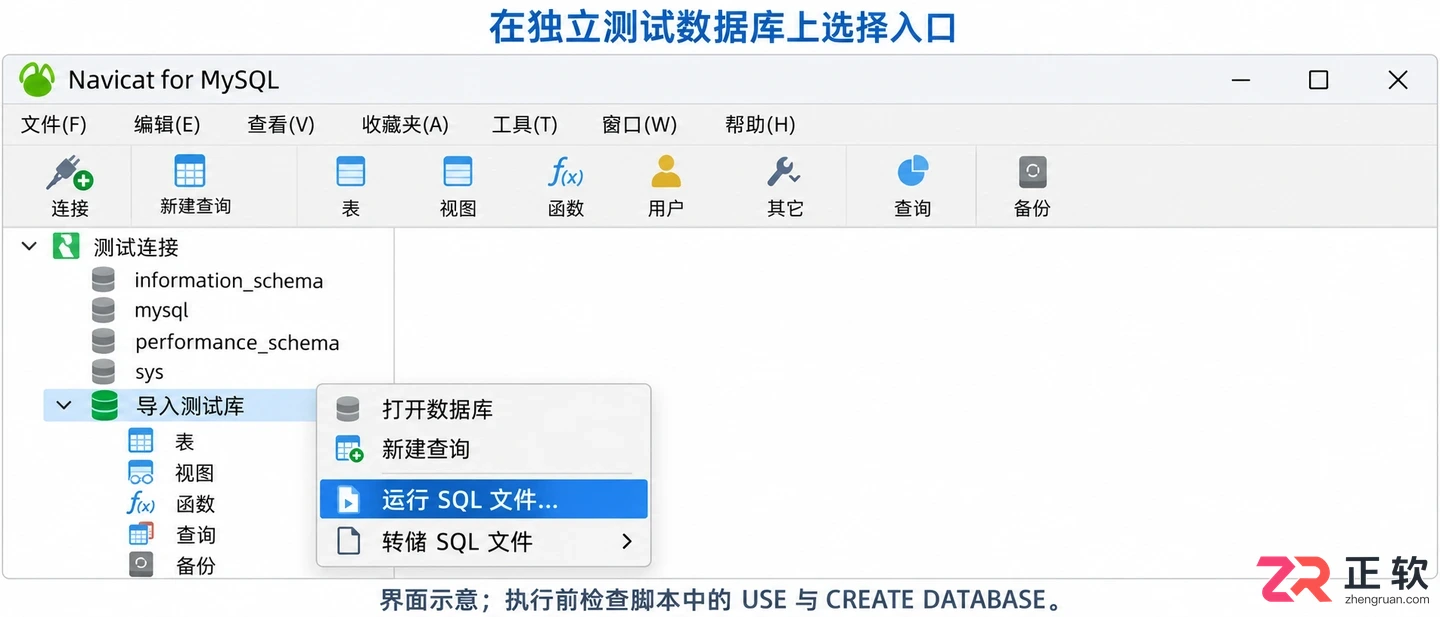
在目标数据库上右键选择【运行 SQL 文件】入口
在选择文件之前,建议先用文本编辑器打开 SQL 脚本,检查开头是否包含 CREATE DATABASE 或 USE 语句。如果脚本内部硬编码了特定的数据库名称,即使在 Navicat 中选中了测试库,脚本中的 USE 语句仍可能将上下文切换到其他数据库,甚至尝试创建新库。若发现此类情况,需在副本中注释掉或修改这些语句,确保所有操作都落在预期的测试库中。
如果执行时提示“No database selected”,请检查是否在右键菜单中正确指定了数据库,或者脚本中是否缺少有效的数据库选择语句。不要为了消除提示而随意选择一个包含重要业务数据的库作为目标。
3. 按文件真实编码选择读取方式
在【运行 SQL 文件】对话框中,点击“...”按钮选择 SQL 副本文件。关键在于【编码】下拉菜单的选择。这里的编码指的是 Navicat 读取文件字节流的方式,必须与文件实际保存的编码一致,否则会导致中文乱码或语法解析错误。
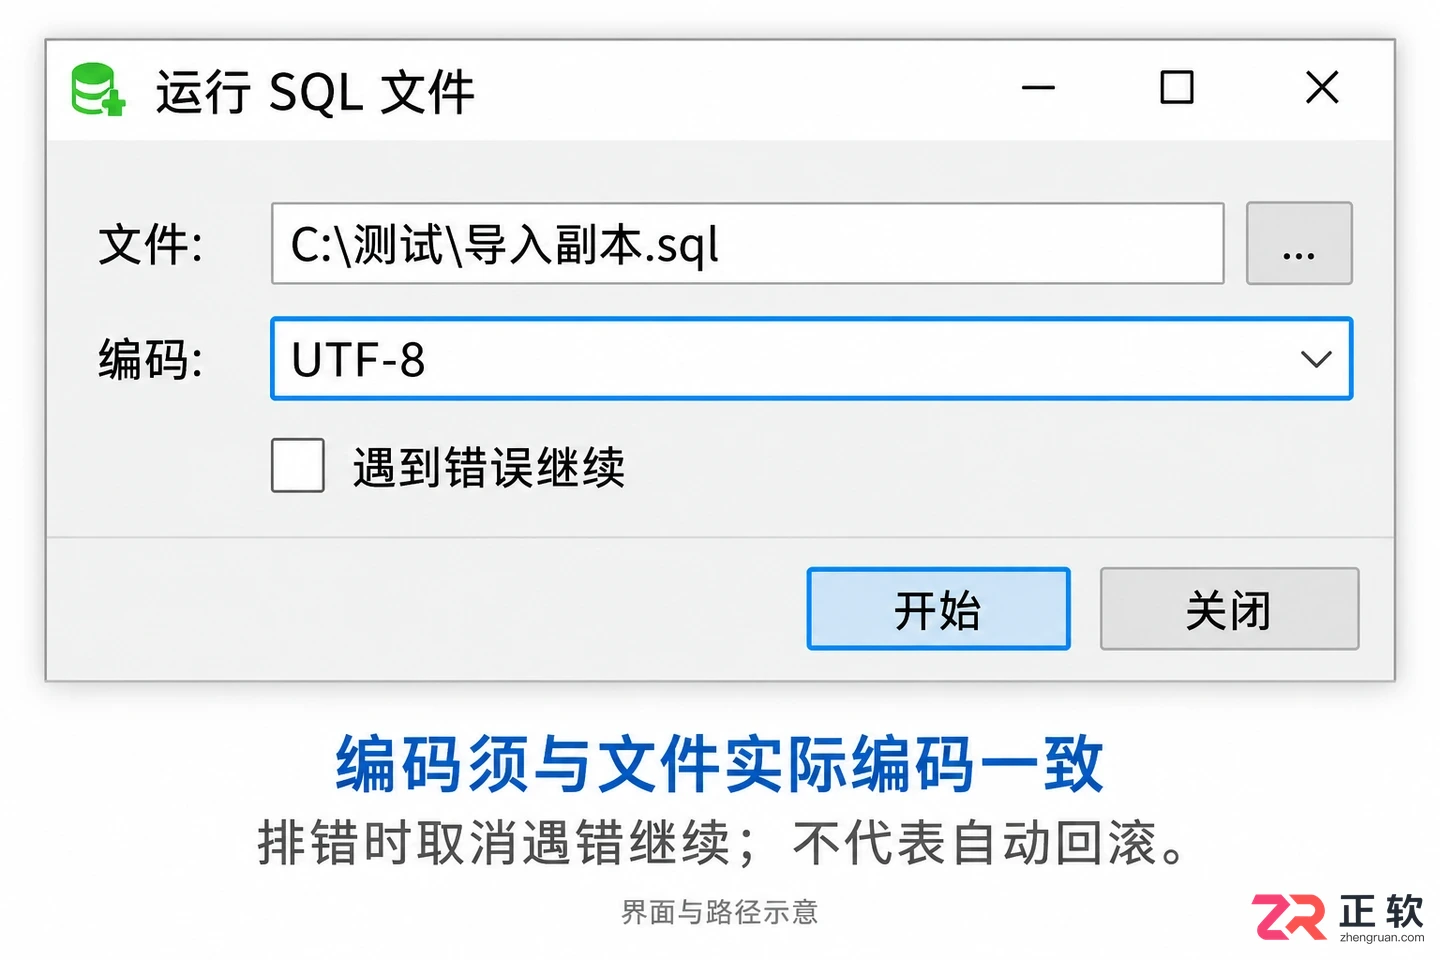
【运行 SQL 文件】对话框中设置文件路径与编码
如果不确定文件编码,可先用支持编码显示的文本编辑器(如 Notepad++ 或 VS Code)打开文件,查看含中文的注释或数据是否正常显示。若确认为 UTF-8 无 BOM 格式,则在 Navicat 中选择 UTF-8;若为 GBK,则选择 GBK。不要盲目尝试所有编码选项,错误的编码选择会导致字符串截断或非法字符错误。
在排错阶段,务必取消勾选【遇到错误继续】。这样当脚本执行到第一个错误时会立即停止,便于精确定位问题行。该选项仅控制错误发生后的行为,不会修复已损坏的字符,也不能保证失败前的语句自动回滚。
4. 根据错误文字修正副本
针对常见的几类错误,采取相应的修正策略:
如果是语法错误(Syntax Error),检查报错行附近的语句是否完整,引号是否成对,以及是否存在特殊字符转义问题。不要简单删除报错行,因为该行可能定义了后续语句依赖的表结构或变量。
若提示“Unknown collation”或类似的排序规则错误,通常是因为导出源和目标服务器的 MySQL 版本不一致。例如,MySQL 8.0 默认使用的 utf8mb4_0900_ai_ci 排序规则在 MySQL 5.7 中不被支持。此时应优先联系导出方生成兼容低版本的脚本,或在测试环境中使用相同的高版本 MySQL。严禁对全文件进行不加区分的批量替换,因为不同的排序规则会影响数据的比较、排序和唯一性约束。
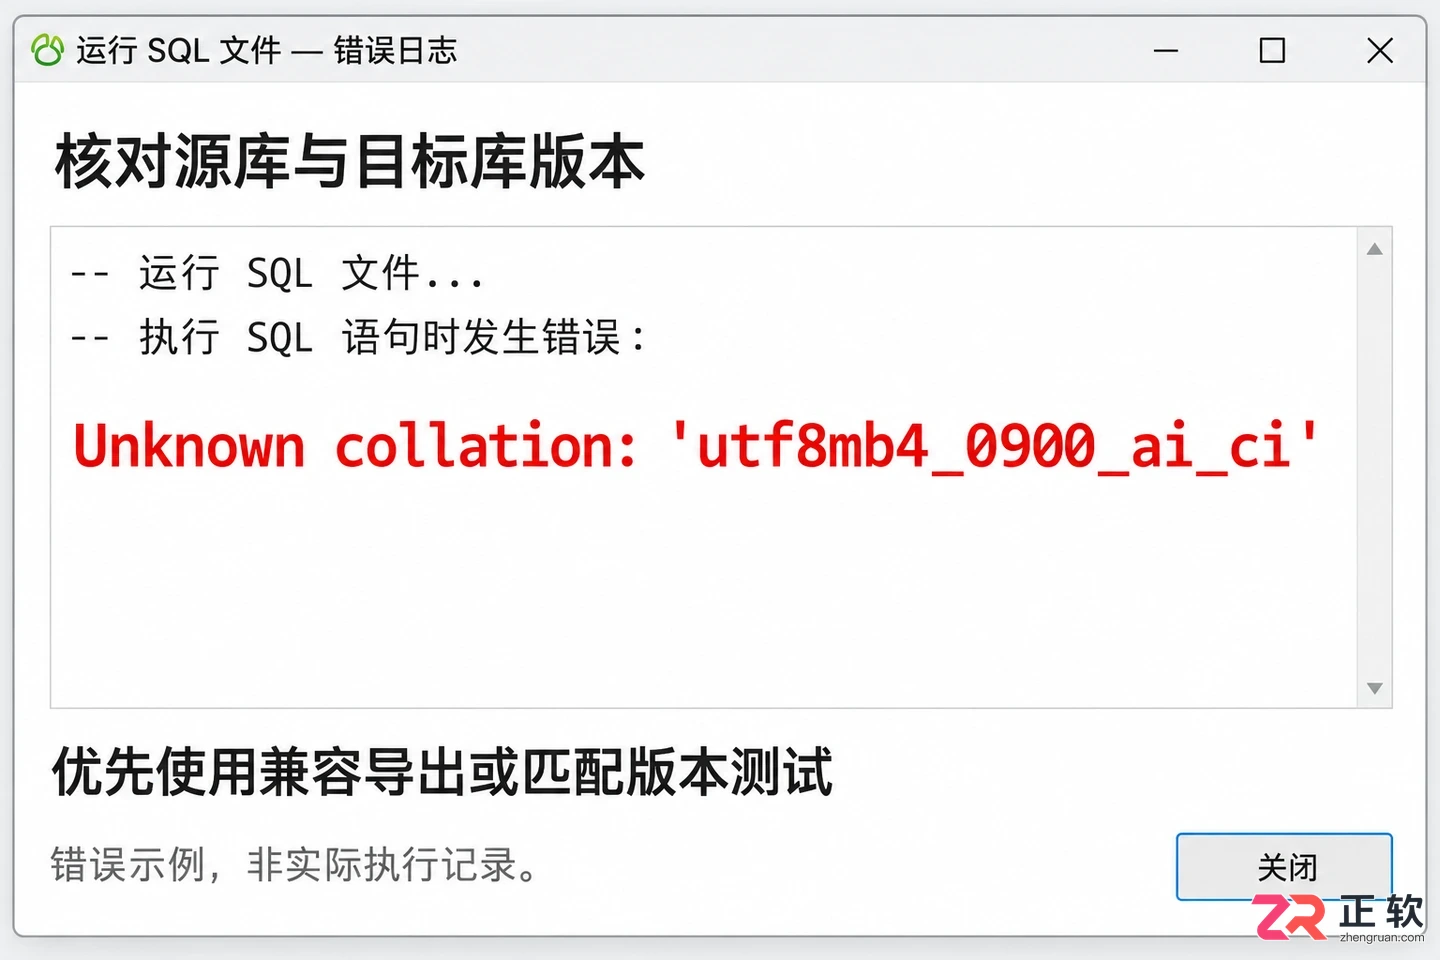
因MySQL版本差异导致的排序规则未知错误
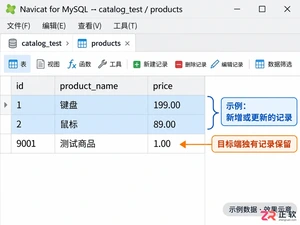
若提示“Table already exists”或主键重复,说明测试库中可能残留了上次部分导入的数据,或者脚本本身与现有数据冲突。对于测试库,最稳妥的方式是删除该库并重新创建一个干净的数据库,然后再次执行导入。在生产环境中,严禁直接删除表或忽略重复键错误,必须由专业人员评估数据一致性风险。
5. 在干净测试环境重新执行
在完成编码确认、脚本修正并准备好干净的测试数据库后,再次通过【运行 SQL 文件】入口执行导入。保留此次执行的完整日志。如果仍然失败,重复步骤 1,分析新的首条错误,直到导入成功。
导入显示“Finished”并不代表万事大吉。刷新测试数据库的对象列表,检查应有的表、视图、存储过程是否全部存在。随机抽取几张关键表,核对记录数量是否与预期一致,重点检查中文字段、日期格式以及外键关联数据是否正确。特别是对于包含复杂逻辑的脚本,需验证业务语义是否完整保留。
需要注意的是,对于包含大量 DDL(建表、改表)的脚本,MySQL 的隐式提交机制可能导致无法通过简单的 ROLLBACK 回滚所有操作。因此,每次重试前确保环境干净至关重要。
6. 保存验证记录再安排正式恢复
将原始 SQL 文件、修正后的副本、首条错误截图以及成功的测试导入日志归档保存。注明来源数据库版本、目标数据库版本以及所做的具体修改原因。如果在测试环境中仍存在编码乱码、排序规则警告或数据量不符的问题,不得将该结果用于替换生产库。
正式恢复操作应在业务低峰期进行,并提前确认全量备份可用。使用经过测试验证的文件和步骤执行导入,并在完成后进行同样的业务数据抽检。通过这种严谨的流程,解决的是导致导入失败的具体技术条件,而不是用“忽略错误”换取一个看似完成的进度条,从而保障数据的安全与完整。
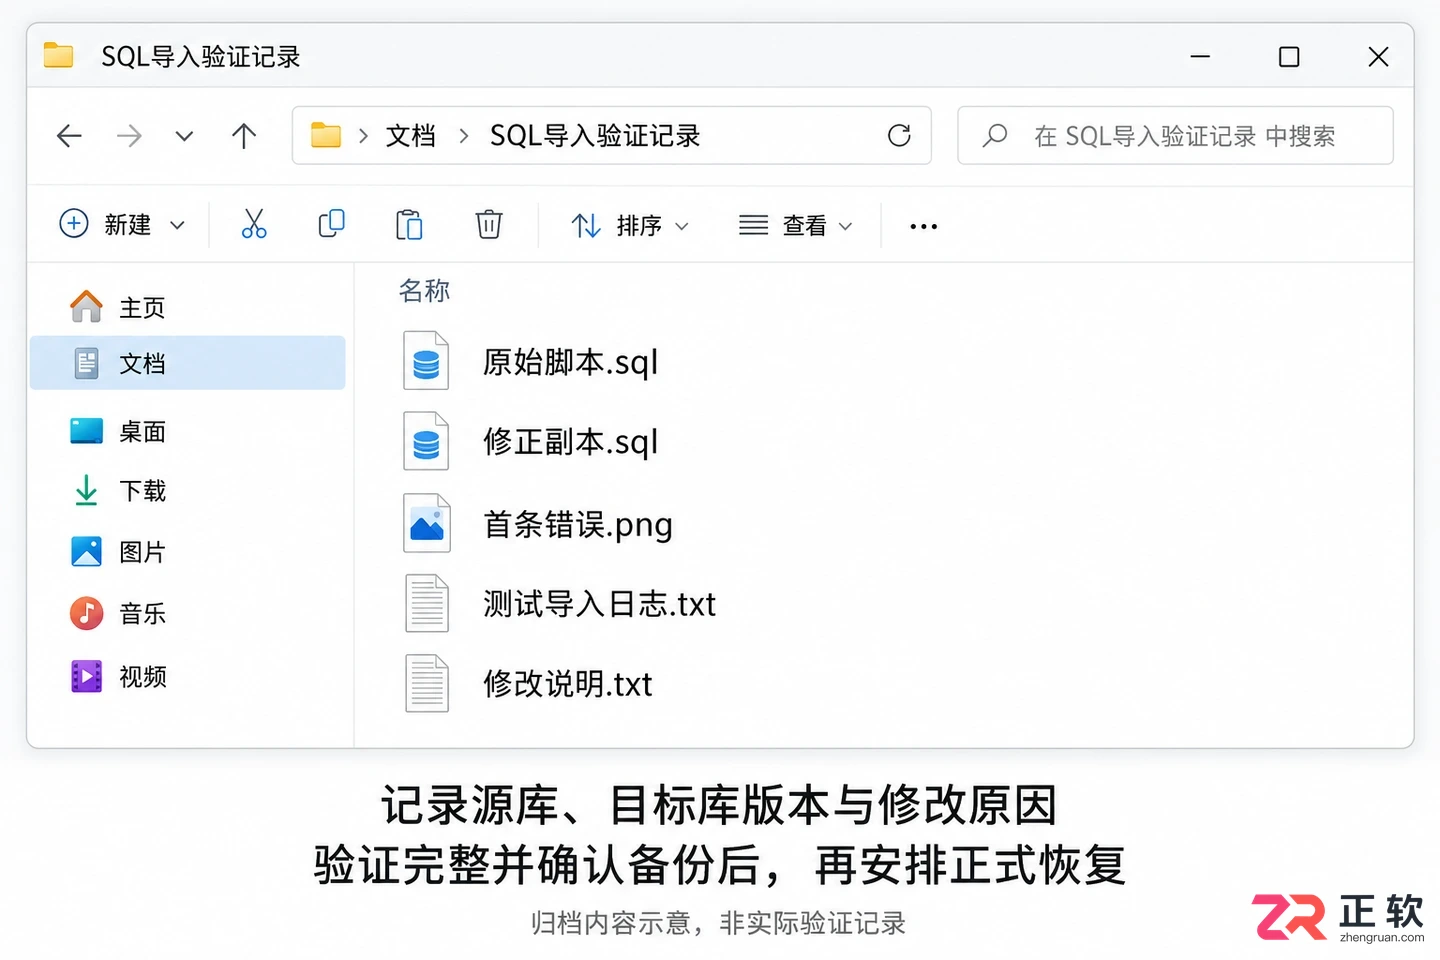
6. 保存验证记录再安排正式恢复








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,
火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。