


音述AI创作说唱歌曲设置技巧

学习如何在音述AI中创作中文说唱歌曲。通过具体案例展示如何设置主题情绪、编写分段歌词、调整人声与伴奏平衡,以及生成后的优化与导出步骤,帮助创作者获得更精准的音乐生成结果。
在音述AI中创作说唱歌曲,关键不在于简单勾选“说唱”标签,而在于将主题、情绪、节奏和人声结构清晰地传达给系统。通过精确的文字描述和结构化的歌词输入,可以显著提升生成结果的可用度。以下以一首“夜晚城市通勤”主题的中文说唱为例,展示从设置到优化的完整流程。
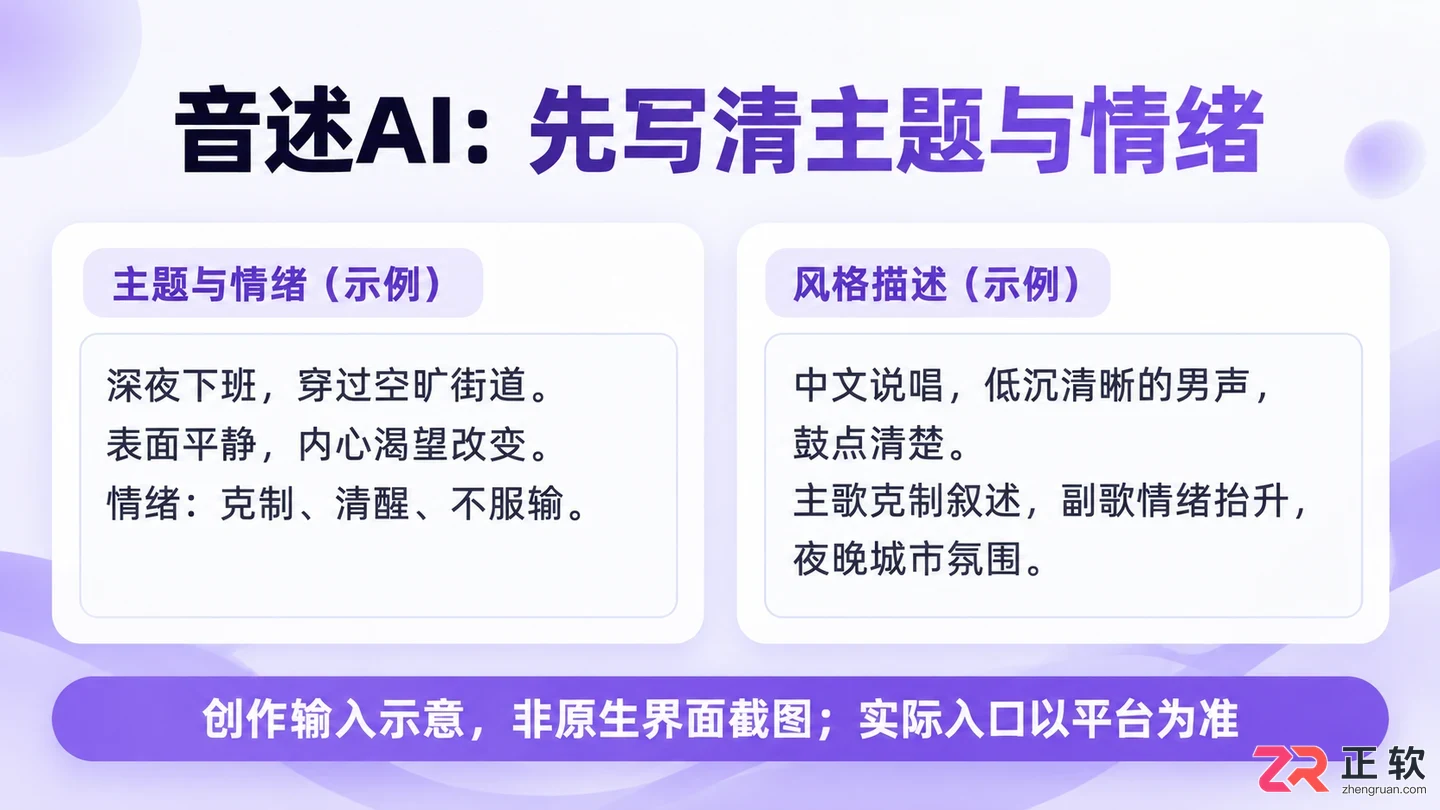
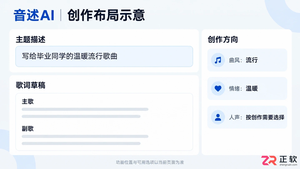
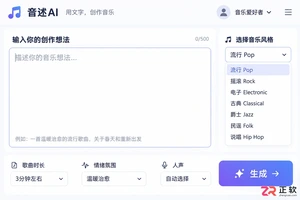
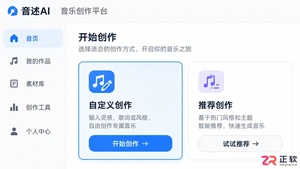
音述AI创作页面,显示主题与情绪输入区域
1. 明确主题与情绪描述
进入音述AI创作页面后,首先避免使用“帮我写一首说唱”这类宽泛指令。应将主题具体化,例如设定为“深夜下班的人穿过空旷街道,表面平静,内心渴望改变”。同时补充情绪关键词,如“克制、清醒、带一点不服输”。主题决定歌词内容走向,而情绪则引导人声演绎和伴奏氛围。
在风格描述栏中,建议采用“曲风+速度感+人声状态+氛围”的组合方式。例如输入:“中文说唱,偏低沉男声,鼓点清晰,主歌部分克制叙述,副歌部分有情绪抬升,整体营造夜晚城市氛围”。这种描述比单一的“高级”或“燃”更能让系统理解需求。注意避免互相冲突的指令,如同时要求“慵懒慢歌”和“高速密集吐字”;若需反差效果,应明确标注不同段落的要求。
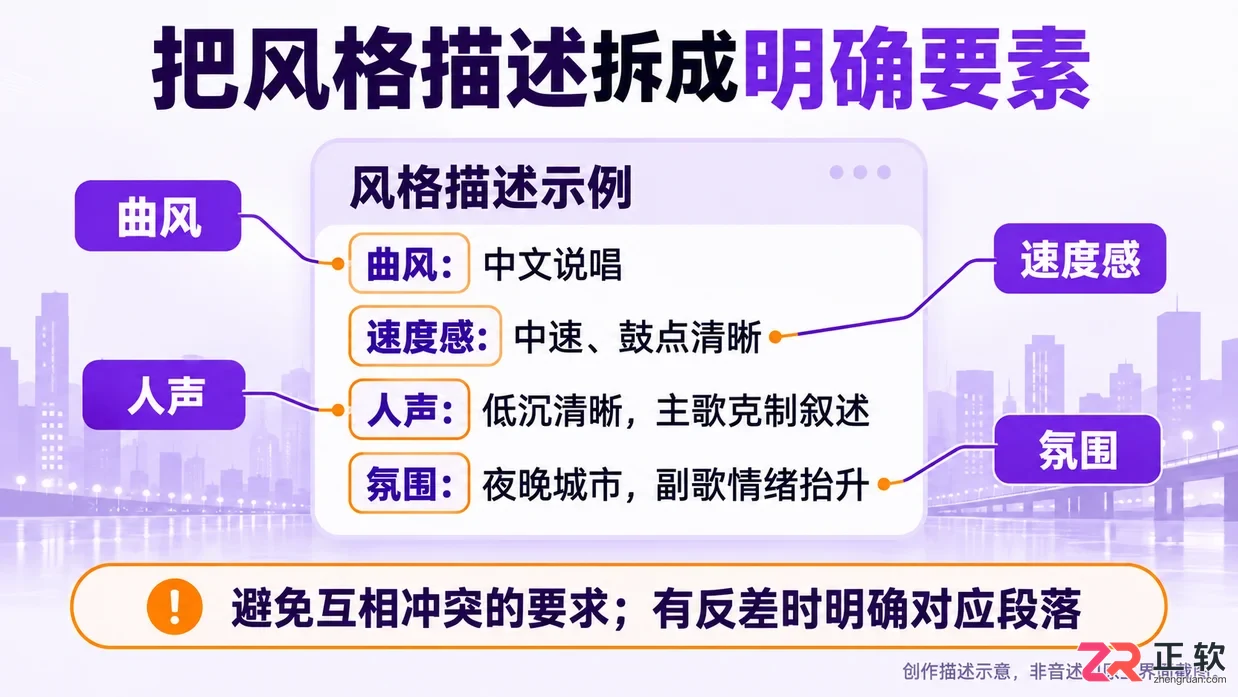
1. 明确主题与情绪描述
2. 结构化输入歌词
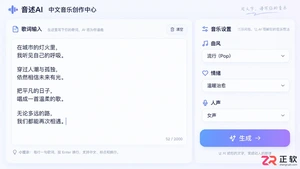
若已有歌词草稿,应在创作页面选择自定义歌词输入模式,并按段落进行分隔。避免将所有文字连成一大段,否则系统难以识别重复段落或转折句。建议使用标准标签区分结构:
[主歌]
夜班灯光落在车窗上
我把没说完的话写在手掌

[副歌]
向前走,不回头
城市再大也有出口
说唱歌词需注意每行长度与断句。主歌部分可使用较短句子以形成清晰律动,副歌则适当重复核心句以增强记忆点。中文押韵应优先保证语义连贯,再通过结尾韵脚调整节奏。若处于灵感探索阶段,可使用系统的自动生成歌词功能获取草稿;若主题明确,优先使用自定义歌词以确保内容准确性。
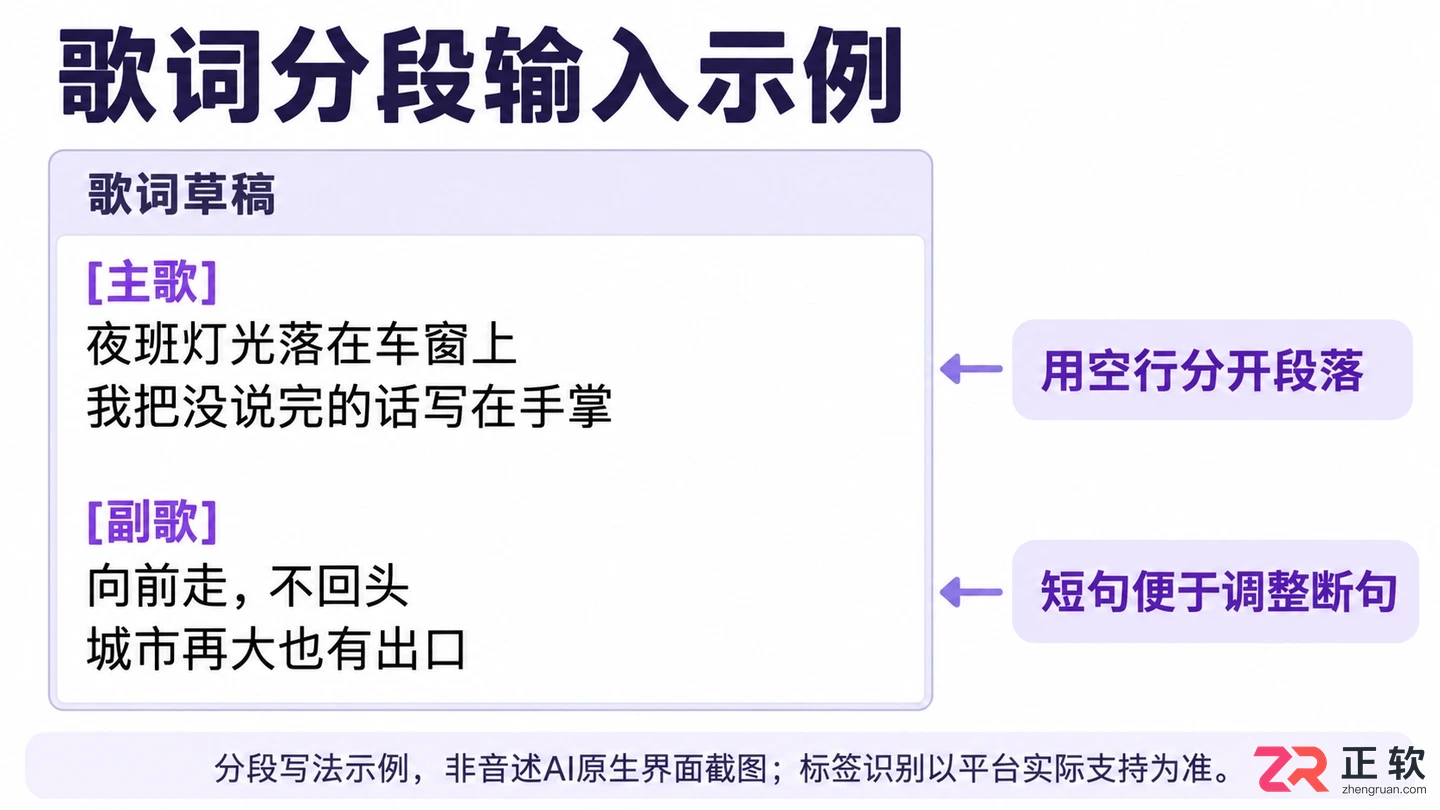
歌词编辑区显示主歌与副歌的分段结构
3. 调整人声与伴奏平衡
在风格或人声设置中,先确认选择说唱或Hip-Hop相关选项,再根据歌词内容挑选声线。叙事性较强的内容适合低沉、清晰的单人声线;情绪激烈的歌曲则可尝试在副歌部分增加抬升感或合唱效果。避免堆叠过多声线标签,以免生成结果主次不分。
伴奏描述应服务于人声表现。例如,强调吐字清晰度时,可描述为“简洁鼓组、低频贝斯、留出人声空间”;若需外放情绪,则可描述为“密集电子音色、强烈鼓点、快速推进”。初次生成时,建议只调整一个主要变量,如固定歌词和主题,仅调整人声设置;待听辨结果后,再逐步调整伴奏或速度,以便准确定位问题来源。
若使用参考音频功能,需明确其仅用于提供风格方向,而非直接复制受版权保护的素材。参考内容越具体,越应避免照搬原曲旋律或独特表达,而是将其转化为对速度、情绪、配器及人声关系的描述。
4. 针对性回改与优化
首次生成后,重点检查四个维度:主歌吐字是否清晰、副歌是否有明显区别、鼓点是否掩盖人声、段落衔接是否自然。若仅个别句子节奏不顺,只需修改对应歌词行或调整断句,无需重写整首歌。若人声方向正确但伴奏过于嘈杂,可保留歌词和声线设置,将伴奏描述调整为“编曲简洁、低频收紧、给人声留出空间”。
若整体结果偏离主题,应回到初始创作描述,删减无关形容词,重新突出故事核心、情绪基调及曲风特征。避免一次性修改主题、歌词、人声和伴奏所有设置,否则即使结果改善,也难以复盘有效参数。
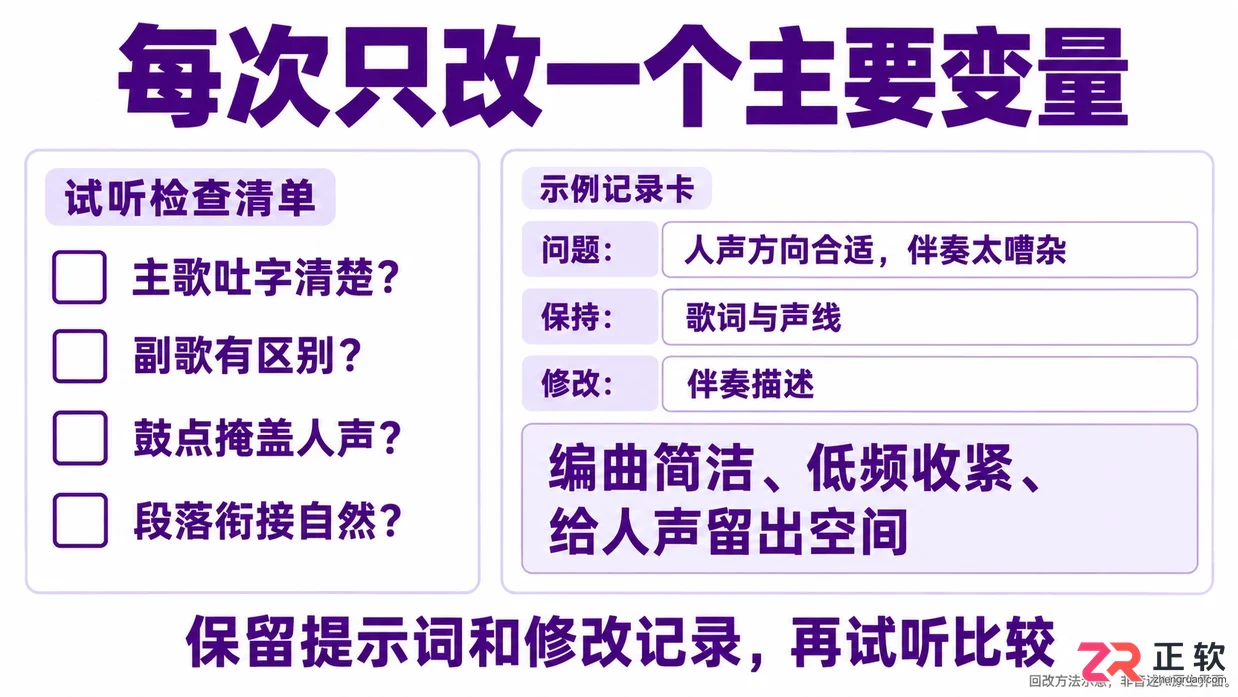
4. 针对性回改与优化
5. 保存版本与导出验证
对满意的版本,先保存作品工程及歌词文本,再查看平台提供的导出选项。音述AI支持生成匹配逐句歌词动画的MV并导出分享,但具体导出格式、权限及入口可能随账号类型或版本更新而变化。下载文件后,务必试听开头、主歌、副歌及结尾部分,检查人声完整性、歌词同步情况以及文件在目标播放器中的兼容性。
说唱创作的高效路径在于先固定故事内核与歌词结构,再逐项微调声线、节奏与伴奏。保留每次生成的提示词与修改记录,有助于积累有效组合,减少后续创作的试错成本。
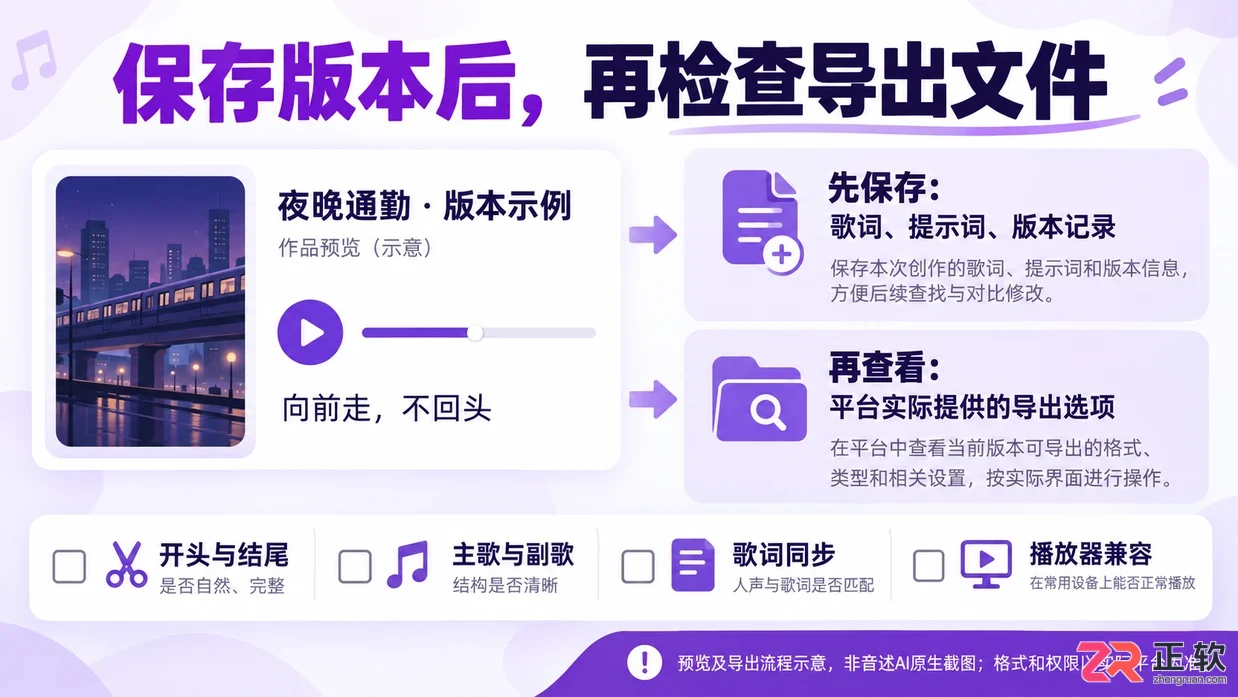
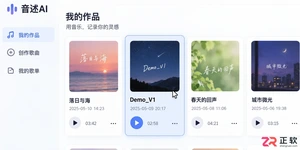
作品播放预览及导出选项







火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。







AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

Beamer 4是面向macOS的本地视频投屏工具,可将Mac中的影片投放到Apple TV、Chromecast及兼容设备,支持常见格式、多类字幕、环绕声、播放列表和电视遥控操作。
火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。
AnyDesk Windows版是一款轻量化远程桌面与技术支持工具,可用于控制异地电脑、传输文件、远程打印及无人值守访问。它兼顾连接响应、安全权限和部署灵活性,适合个人远程办公、企业设备维护与客服支持。