


PDF OCR识别乱码或失败?图像清晰度与语言包设置
处理PDF OCR识别乱码或失败,需先OCR识别效果主要受图像质量、页面方向和识别语言影响。本文结合真实步骤图说明放大检查原扫描页的清晰度、倾斜、阴影与背景噪点、先旋正、裁剪边缘并提高对比度,避免过度锐化、选择中文、英文或混合语言包,繁简体要与原文匹配,并补充先识别代表页,检查数字、标点、表格。
OCR识别准不准,主要受图像质量、页面朝向和识别语言这三点影响。操作前先把原文件单独备份好,后面不管是修图、转格式、解锁还是压缩,全都在副本上改动,别碰原件。
识别引擎之前先接触的是图像,页面倾斜、小字发糊或语言包选错,后面换什么导出格式都救不回来。
方法一:用 PDF.cn 在线处理
如果只是临时处理单份文件、文件也允许上传,直接从 PDF OCR 入口进就行。下面五步我们用本地保存的真实中文扫描页演示,动手前先把原文件备份好。
1. 找到工具入口
从PDF.cn首页找到PDF OCR功能,先核对工具名称和你要做的处理方向,别进错其他功能页面。
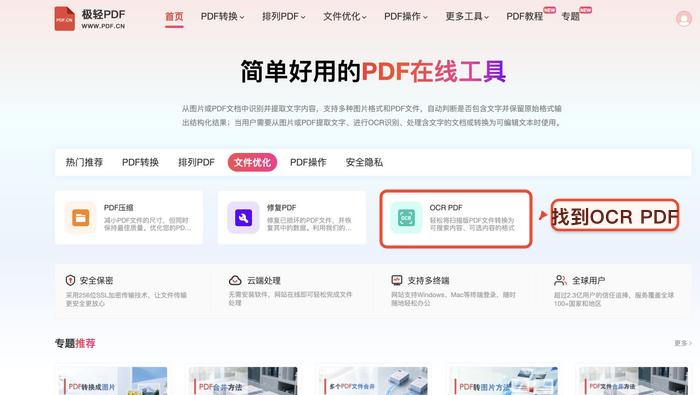
找到对应工具入口
2. 选择并上传 PDF
上传的时候用你提前存好的副本就行,要是好几个文件名字相近,先确认好版本再传,上传过程中不要反复点按钮。
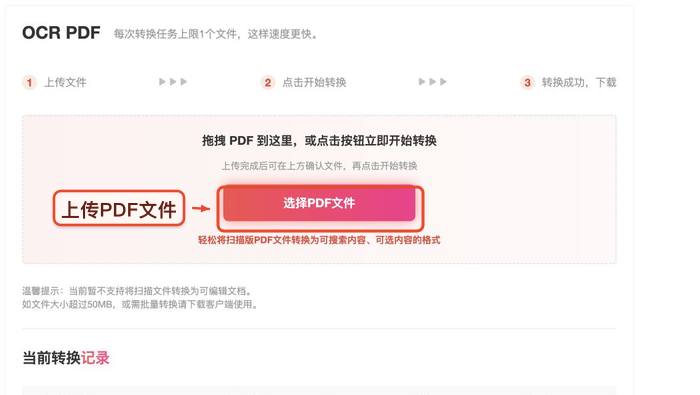
选择并上传 PDF 副本
3. 核对文件状态
检查上传后的文件名、大小和处理状态,要是识别到页数不对或者名称异常,直接停手别往下处理。
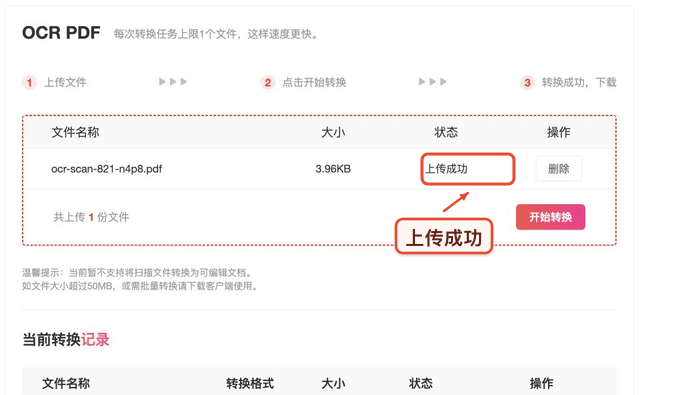
核对文件状态和名称
4. 设置参数并开始处理
根据你的实际使用需求调整PDF OCR的各项参数,最好先拿代表性文件或者几页样页测试效果。
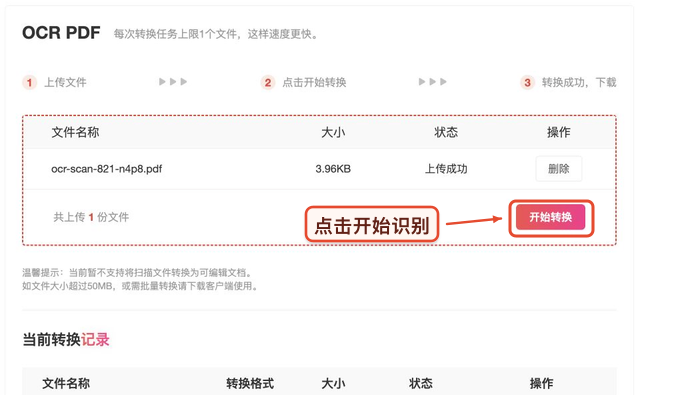
确认设置后开始处理
5. 下载后立即验收
别光看页面提示“处理成功”就完事,下载完立刻打开结果文件,对着页数、内容和版式逐项核对。
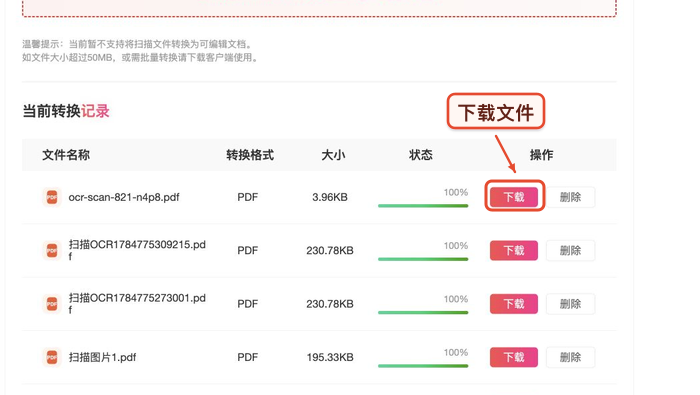
下载结果并重新打开
方法二:桌面 OCR 软件按区域识别
这种方式适合敏感文件、批量扫描任务和带复杂表格的文件。先把图片旋转纠偏,再手动框选文字或者表格区域,能大幅减少跨栏识别错位、表格乱版的问题。
先拿副本里的1页样页测试效果,没问题再处理整份文件;全部处理完之后,把文件关了重新打开查看结果,别把软件临时预览的效果当成最终导出的版本。
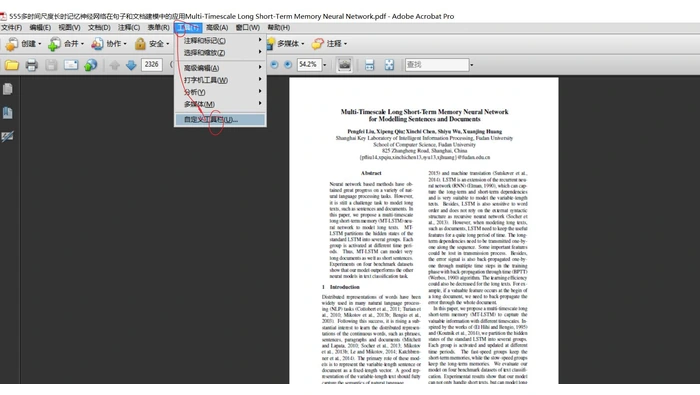
Adobe Acrobat按区域OCR识别
上一步做完之后,接着对照界面提示选OCR识别语言、设置输出格式就行,全程都用刚才操作的那份副本,别选错文件,也别把导出结果存错位置。
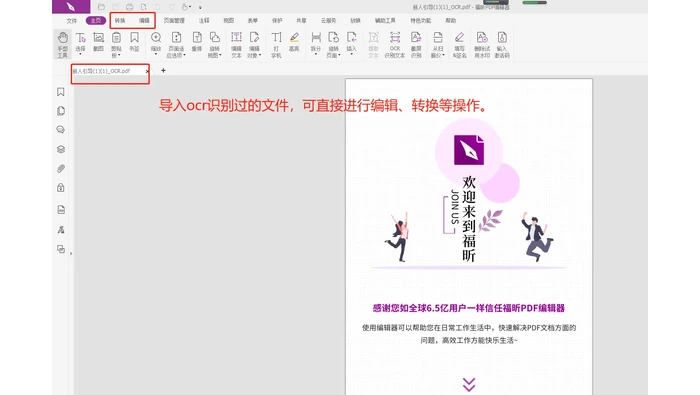
Acrobat选择OCR语言和输出
方法三:手机扫描应用重新拍摄并识别
要是纸质原件还在手里,重新拍一遍往往比修复低清扫描文件更省心。拍的时候保持光线均匀,页面铺平放平整,关掉相机的过度美颜滤镜。
先拿副本里的1页样页测试效果,没问题再处理整份文件;全部处理完之后,把文件关了重新打开查看结果,别把软件临时预览的效果当成最终导出的版本。
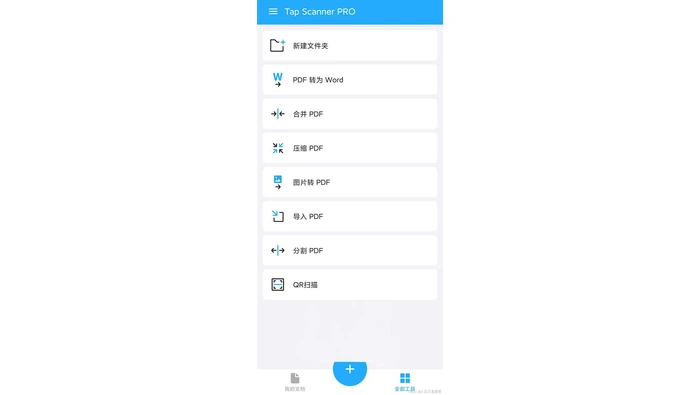
手机扫描应用拍摄并OCR
拍完识别完,接着对照界面提示把可编辑文字导出来就行,全程保持处理的是当前这份文件,别选错之前的旧版本或者存错输出位置。
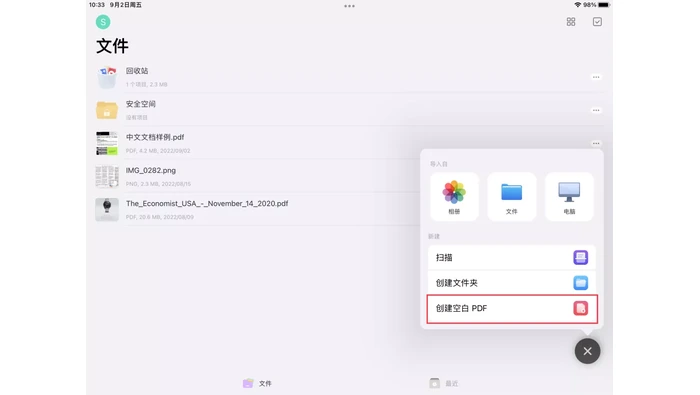
手机OCR导出可编辑文字
常见问题
1、PDF OCR识别乱码或失败?
识别乱码或者直接失败,基本都是图像质量差、页面歪了、语言包选错这几个原因。先拿其他同类型文件做交叉测试,确认是工具问题还是文件问题,之后再拿副本按前面的步骤调整,别直接改原件。
2、图像清晰度与语言包设置?
先抽几页样页试识别,确认数字、标点、表格和分栏内容都没问题,再批量处理全部文件。一定要保留未处理的原件,导出结果之后关了重开一遍,确认没问题再发别人或者交付。
3、OCR识别前应把扫描图处理到什么状态?
文字应方向正确、对比度足够、无明显阴影与透页,小字边缘不应糊成一块;语言包还要覆盖中英文与数字。
相关工具
参考来源
常见的PDF操作根本不用反复瞎试错,直接去极轻PDF网站,根据手里文件的实际情况选对应的方法就行。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。