


在EMR onVKE集群使用AI助手诊断核心要点梳理
掌握在火山引擎 EMR onVKE 集群中使用 AI 助手诊断问题的核心技巧。涵盖集群选择、时间范围设定、问题描述结构、三层资源核对及验证方法,提升大数据集群运维效率。
在 EMR onVKE 集群里使用 AI 助手诊断问题,关键不是把一段报错原样贴进去,而是先选准集群、对象和时间范围,再让助手围绕同一份运行上下文分析。这样得到的建议更容易回到节点、工作负载和监控指标中验证,避免被泛泛而谈的建议误导。
不同控制台版本的入口名称可能不同,以下步骤按当前页面实际显示的集群详情、任务或 AI 助手入口操作。
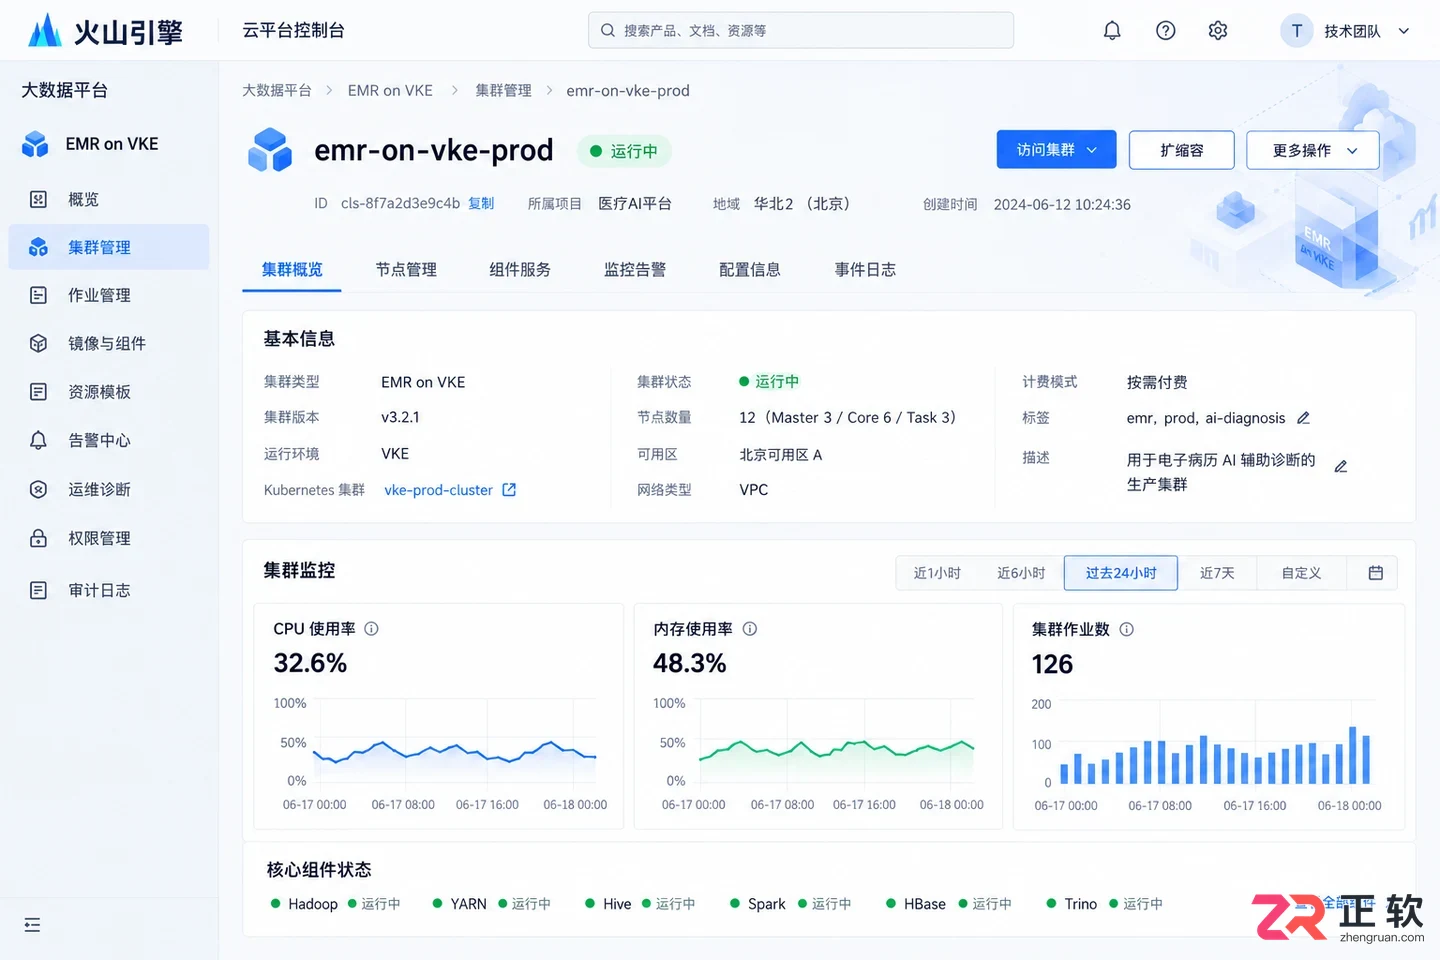
集群详情页展示集群状态与时间范围选择
1. 先选对 EMR onVKE 集群和时间范围
打开目标 EMR onVKE 集群的详情页面,先确认集群名称、当前状态和最近一次异常发生的时间。诊断前把时间范围覆盖到异常前后,不要只截取报错出现的几分钟。
如果集群列表中有多个环境,先通过集群名称、创建时间或业务标签确认对象。时间范围过窄时,助手只能看到结果,可能看不到异常出现前的资源变化;范围过宽又会混入其他任务。初次排查可以先覆盖一次完整任务运行周期,再按异常节点缩小范围。
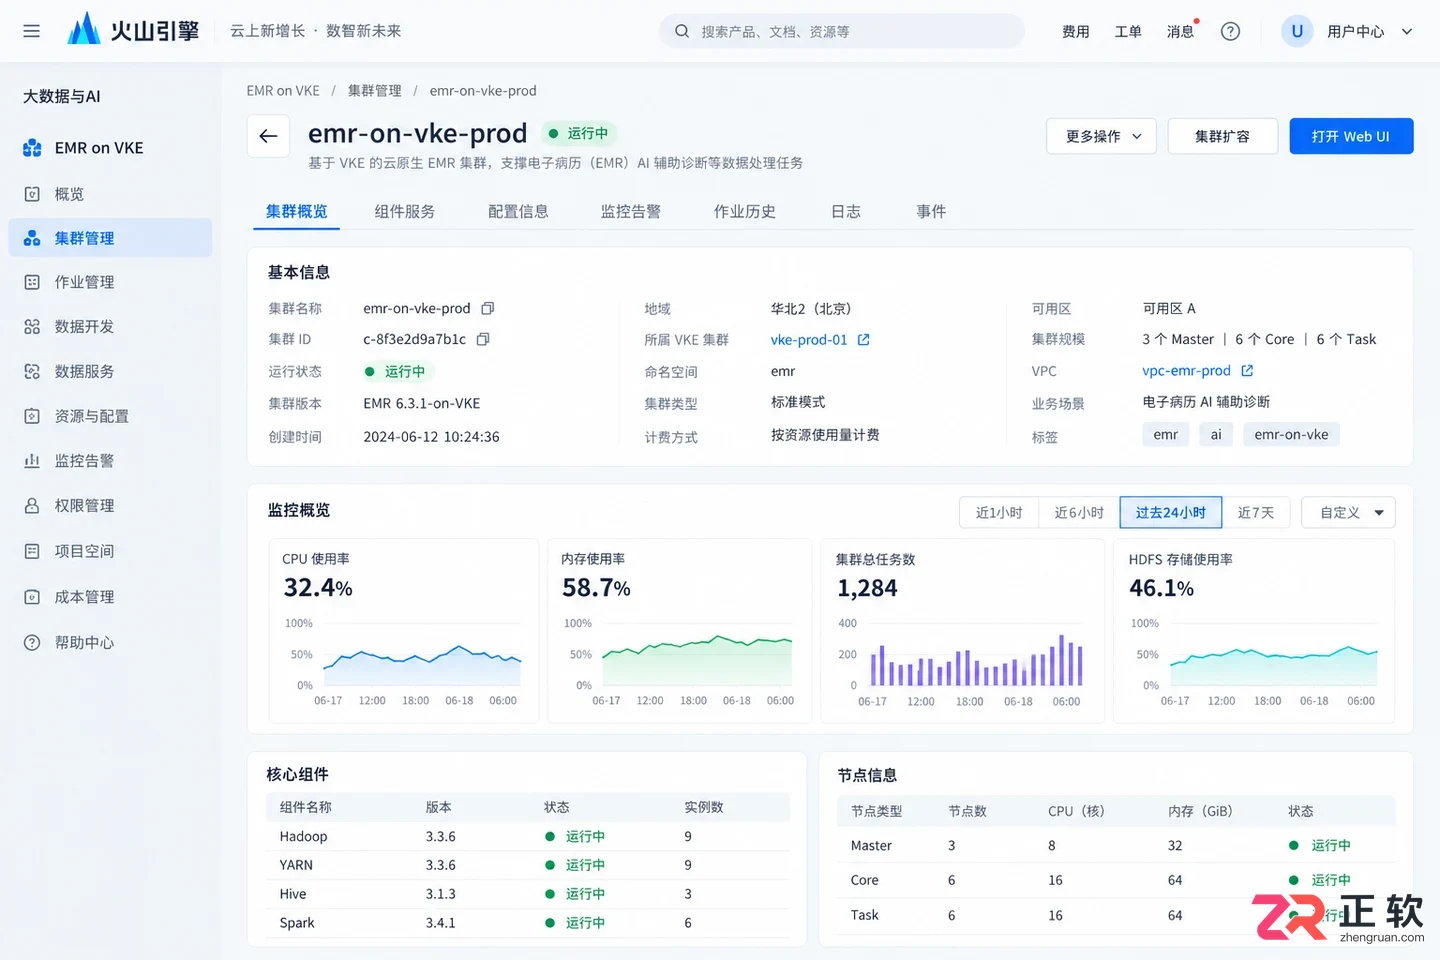
1. 先选对 EMR onVKE 集群和时间范围
2. 在 AI 助手中描述一个可定位的问题
进入当前页面提供的 AI 助手入口后,尽量同时说明对象、现象和时间。比如不要只问“为什么任务失败”,而是说明具体工作负载、失败时间、错误摘要,以及希望确认的是资源、节点还是调度问题。
可以按下面的结构整理输入:
对象:某个工作负载或任务
时间:异常开始和结束的大致时间
现象:任务失败、持续等待或运行变慢
希望确认:资源、节点状态、日志线索或调度原因
如果助手返回多个可能原因,先看它引用的是哪类数据。一个结论如果没有对应的指标、事件或任务上下文,就先当作待验证假设,不要直接修改集群配置。
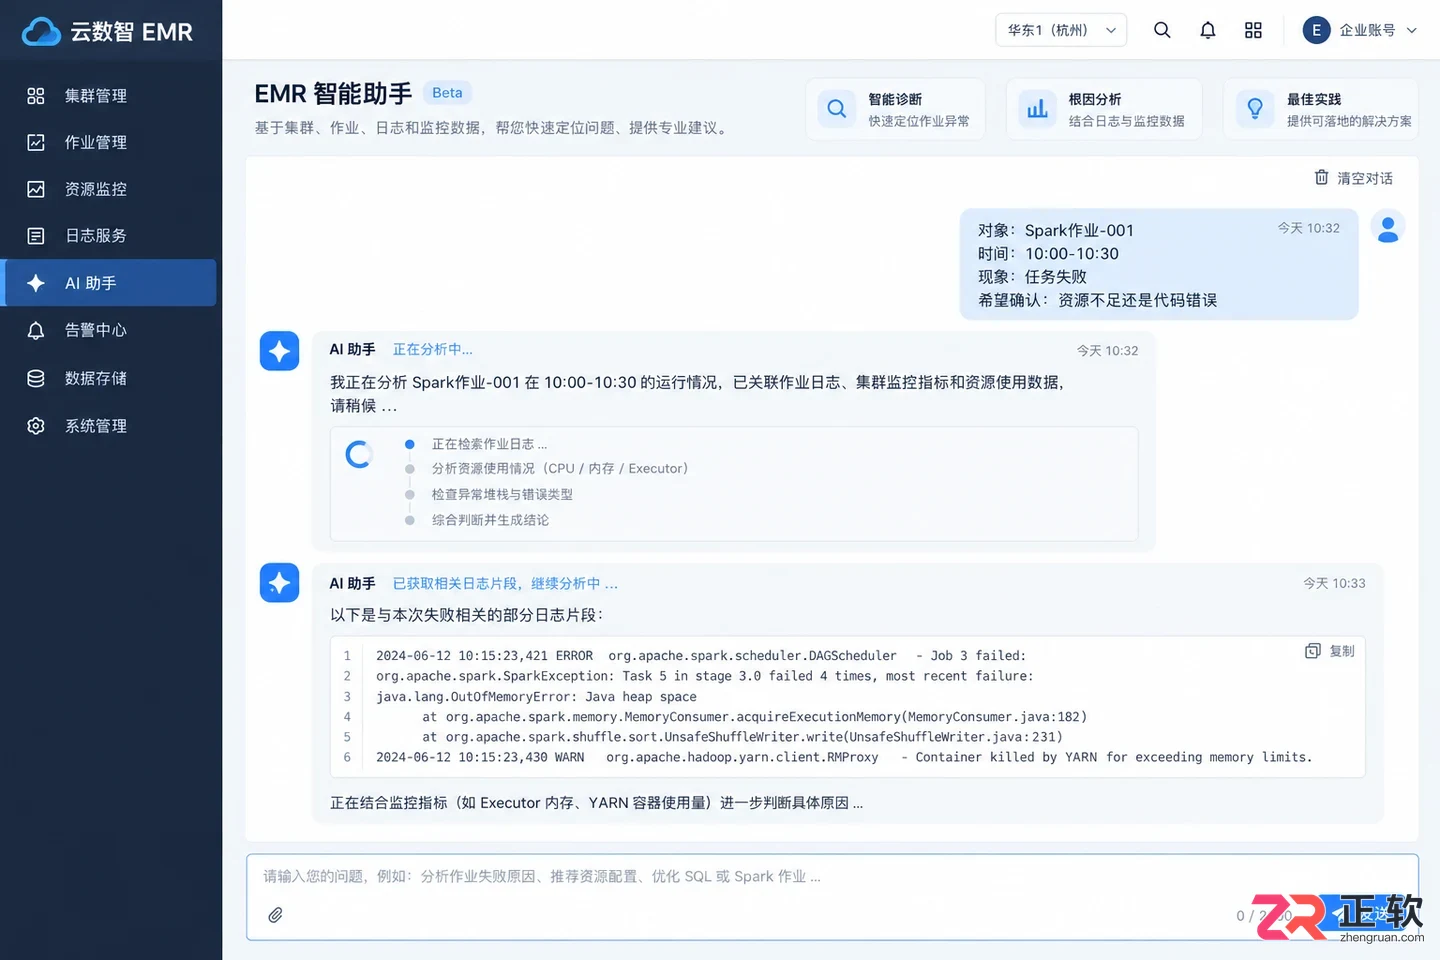
AI助手对话框中输入结构化问题描述
3. 按节点、工作负载和资源三层核对
诊断结果出来后,回到集群详情或监控区域逐层核对。先看工作负载状态,再看承载它的节点,最后看 CPU、内存、存储和网络等资源曲线。
- 工作负载反复重启,先看事件和容器状态,再判断是不是资源限制;
- 工作负载长时间等待,检查调度条件、节点可用资源和是否存在约束;
- 只有少数节点异常,比较这些节点的状态、资源和工作负载分布;
- 所有节点同时变慢,再看集群整体负载和任务并发,不要只处理单个 Pod。
如果助手提到资源不足,应确认它说的是请求值、限制值、当前使用量还是节点剩余量。四者口径不同,直接把“使用率高”理解成“必须扩容”,容易把配置问题误判成容量问题。
4. 用一次小范围验证检查建议是否有效
对诊断建议采取一个改动、一次验证的方式。先记录工作负载状态、异常时间、节点分布和关键指标,再只调整与当前假设直接相关的设置。修改后重新观察同一工作负载,比较启动时间、重启次数、等待时间和资源曲线。
如果建议指向节点资源,验证时要看工作负载是否被调度到预期节点,以及节点压力是否真的下降;如果建议指向调度或并发,重点观察等待任务数和调度耗时。结果没有变化时,先检查实际修改是否作用在当前集群和当前工作负载上,不要连续叠加多个改动。
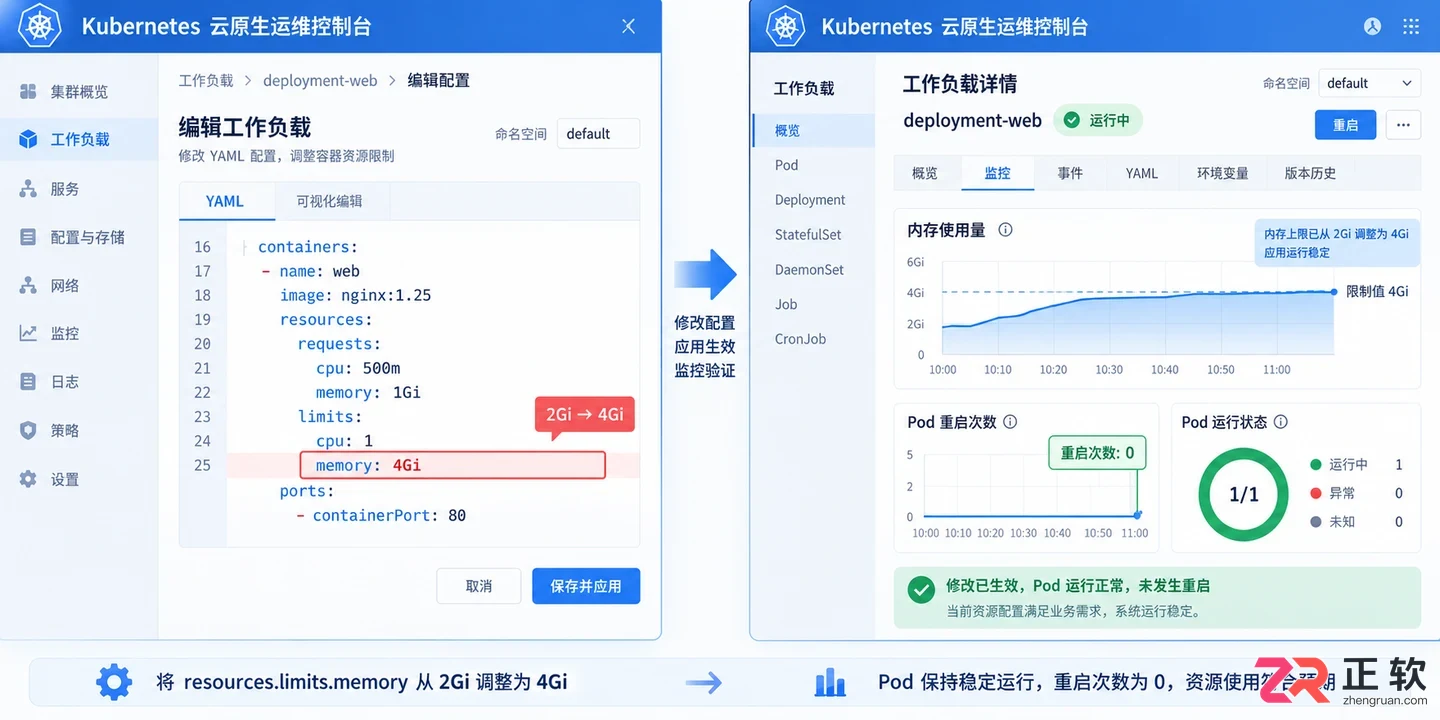
工作负载配置修改页面与验证结果对比
5. 保留诊断上下文,避免下次重新猜
确认问题后,把提问内容、助手返回的判断、实际查看的指标和最终修改分别记录下来。尤其要记住当时选择的集群、时间范围和工作负载名称。
AI 助手适合帮助整理现象、缩小范围和提出验证方向,但不能替代事件、监控和任务日志。遇到版本差异、组件状态异常或权限不足时,应以当前控制台实际显示和对应运行记录为准。这样使用 AI 助手,诊断过程会从“问一句等答案”变成“提出假设—核对证据—小范围验证”。
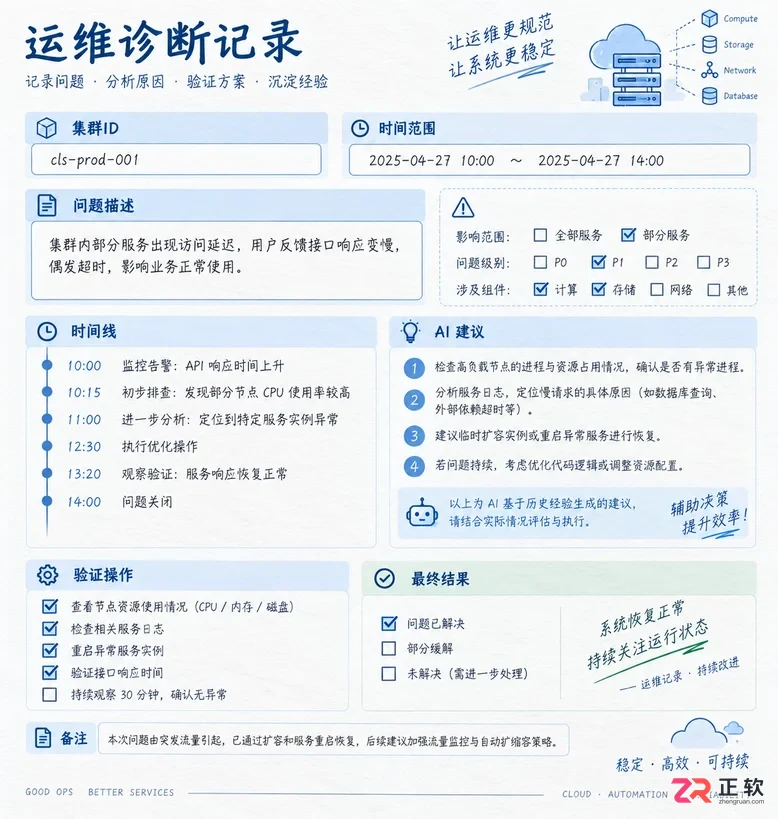
诊断记录文档示例展示关键信息留存




AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

Beamer 4是面向macOS的本地视频投屏工具,可将Mac中的影片投放到Apple TV、Chromecast及兼容设备,支持常见格式、多类字幕、环绕声、播放列表和电视遥控操作。
Boom 3D macOS版是一款系统级音效增强工具,可为音乐、电影、游戏和流媒体提供3D虚拟环绕声、31段均衡器、音量增强及应用独立音量控制,并支持本地播放器与多种音频输出设备。
Boris FX macOS版是一套面向剪辑、合成、调色及动态图形工作的专业后期工具,涵盖视觉特效、平面与三维跟踪、转描、画面修复、粒子动画和音频清理,可配合多种主流宿主软件使用。
Capto 是面向 macOS 的屏幕截图、高清录屏与媒体编辑工具,支持区域及整屏捕获、网页长截图、双音轨处理、图片和视频标注、素材分类与多渠道分享,适合教师、学生、内容创作者及需要制作演示教程的用户。
Cursor Crane 是一款仅面向 macOS 的键盘操控效率工具,可通过提示标签、网格、文字查找和窗口模式完成点击、滚动、定位与切换,并支持屏幕内容提取、脚本及工作流扩展。
Deep Freeze 冰点还原 macOS版通过冻结系统配置,让受保护的Mac在重新启动后回到预设状态,并提供解冻空间、维护计划、密码保护及Apple Remote Desktop管理能力。
Focusky macOS版是一款面向教学课件、商务汇报、产品展示和动画宣传内容的演示制作工具。它通过无限画布、路径编排、缩放旋转转场及多媒体编辑,将传统逐页幻灯片转化为更具空间感的动态演示。
Folder Colorizer 2 macOS版是一款直观的文件夹外观定制工具,可更换颜色,添加表情、贴纸及图片背景,并支持批量处理、智能推荐和恢复默认样式,帮助用户更快辨认工作、学习与生活资料。
AnyDesk Windows版是一款轻量化远程桌面与技术支持工具,可用于控制异地电脑、传输文件、远程打印及无人值守访问。它兼顾连接响应、安全权限和部署灵活性,适合个人远程办公、企业设备维护与客服支持。
Boom 3D Windows版是一款面向音乐、电影和游戏场景的系统级音效增强工具,支持虚拟3D环绕声、31段均衡器、预设音效、应用音量控制及本地音乐播放,可配合耳机、扬声器和蓝牙耳机使用。
Boris FX Windows版是一套服务于影视剪辑、视觉特效、运动跟踪、转描、图像修饰及音频修复的专业创作工具集合,可作为插件接入多种主流后期宿主,也包含可独立运行的应用,适合剪辑师、特效师与内容创作者使用。
ChemDraw Windows版是一款面向化学研究、药物研发、材料科学和教学工作的专业结构绘图工具,可快速绘制分子、反应式及生物聚合物,并提供结构整理、格式转换、性质计算和科研文档协作能力。
CODESOFT Windows版是一套企业级条码与RFID标签设计打印工具,可连接Excel、Access、SQL及云端数据源,支持变量、表单、GS1条码、数据库记录和多种工业打印机,适合制造、仓储、物流及合规标识场景。
Deep Freeze 冰点还原 Windows版通过重启恢复技术保护系统盘及指定分区,自动撤销恶意程序、误操作和配置漂移造成的改动,并支持密码保护、解冻空间与多硬盘管理,适合学校机房、公共电脑、办公终端及家庭电脑使用。
EDIUS 11 Windows版是一款面向影视制作、广播电视、纪录片、短视频及教育机构的专业非线性编辑工具,支持4K/8K、多格式混编、HDR调色、字幕、音频处理和后台渲染,并提供素材管理及丰富的导出预设。
FastStone Capture Windows版是一款轻量级屏幕捕捉、录屏与图像编辑工具,可截取窗口、区域、菜单和滚动页面,并提供标注、模糊、取色、OCR、录音录像及多格式导出能力,适合办公说明、教程制作和问题反馈。
Focusky Windows版是一款动画演示与交互课件制作工具,通过无限画布、缩放旋转镜头、模板素材和对象动画组织内容,可导入PPTX,并输出视频、EXE、PDF、网页等格式,适用于课堂教学、微课、商务汇报及产品展示。
Folder Colorizer 2 是面向 Windows 的文件夹颜色修改工具,可在资源管理器右键菜单中快速套用预设颜色,或通过 HEX 色值创建个性颜色,帮助用户直观区分项目、课程、素材与任务状态。
FumeFX Windows版是一款集成在3ds Max中的流体与多物理场特效插件,支持火焰、烟雾、液体、海洋、粒子及布料模拟,并提供GPU加速、节点化控制和缓存处理工具,适合影视、动画与游戏特效制作。
Fuzor Windows版是一套面向建筑、工程与施工团队的BIM/VDC平台,可汇集多来源模型和进度数据,完成实时可视化、4D施工推演、场地物流规划、问题检查、成果演示及团队协同。