

Blender卡顿,CPU占用过高怎么解决最有效
深入剖析Blender在建模、视口交互及渲染时卡顿与CPU占用过高的本质原因,提供从GPU硬件加速、修改器降载与全局简化、物理模拟烘焙到撤销步数优化的最有效解决方案。
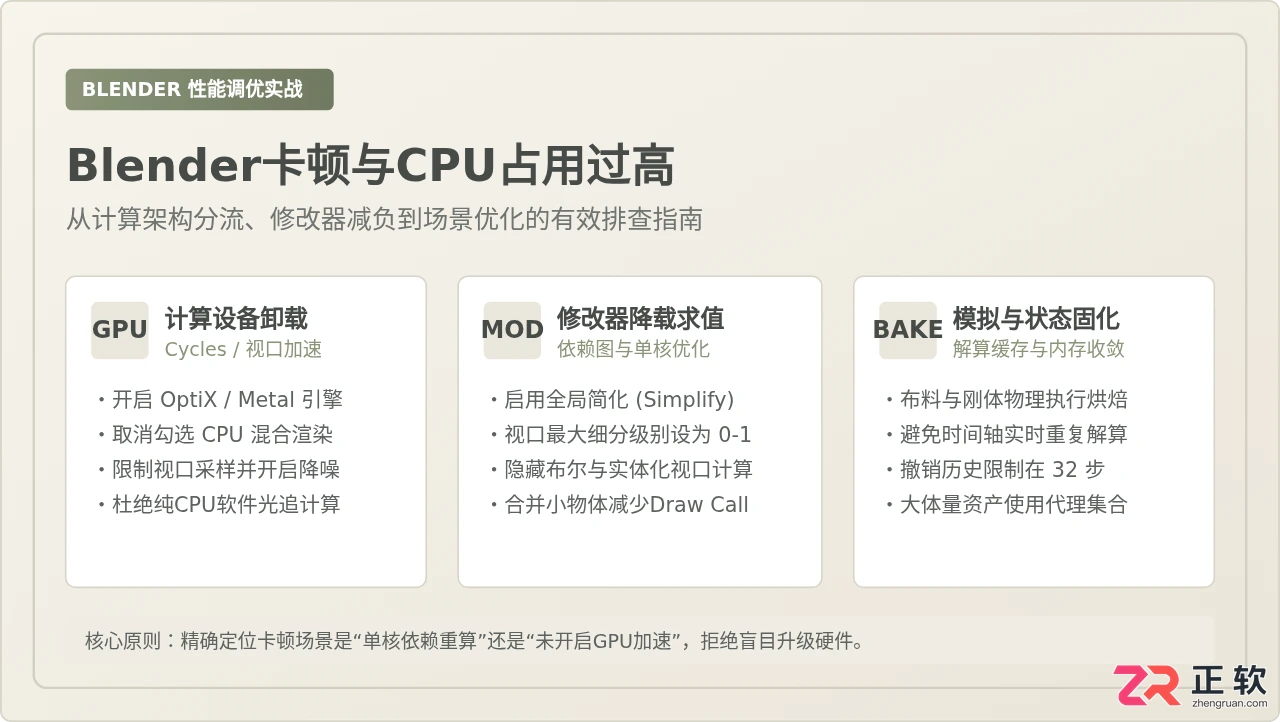
Blender 出现卡顿且 CPU 占用居高不下,最有效的解决路径不是盲目升级硬件,而是区分“单核性能瓶颈”与“多线程计算分配”:先将渲染与视口计算从 CPU 软件模式切实卸载到独立 GPU(启用 OptiX/HIP/Metal 并勾选显卡),再针对视口操作中的高耗 CPU 因素(尤其是细分曲面未应用、修改器堆叠、大体量未优化的几何体以及实时物理模拟)进行降载与代理设置。针对不同工况定位瓶颈,往往几项针对性设置就能将 CPU 占用降下来、视口帧率提升数倍。
一、先摸清卡顿形态:单核瓶颈还是多核未卸载
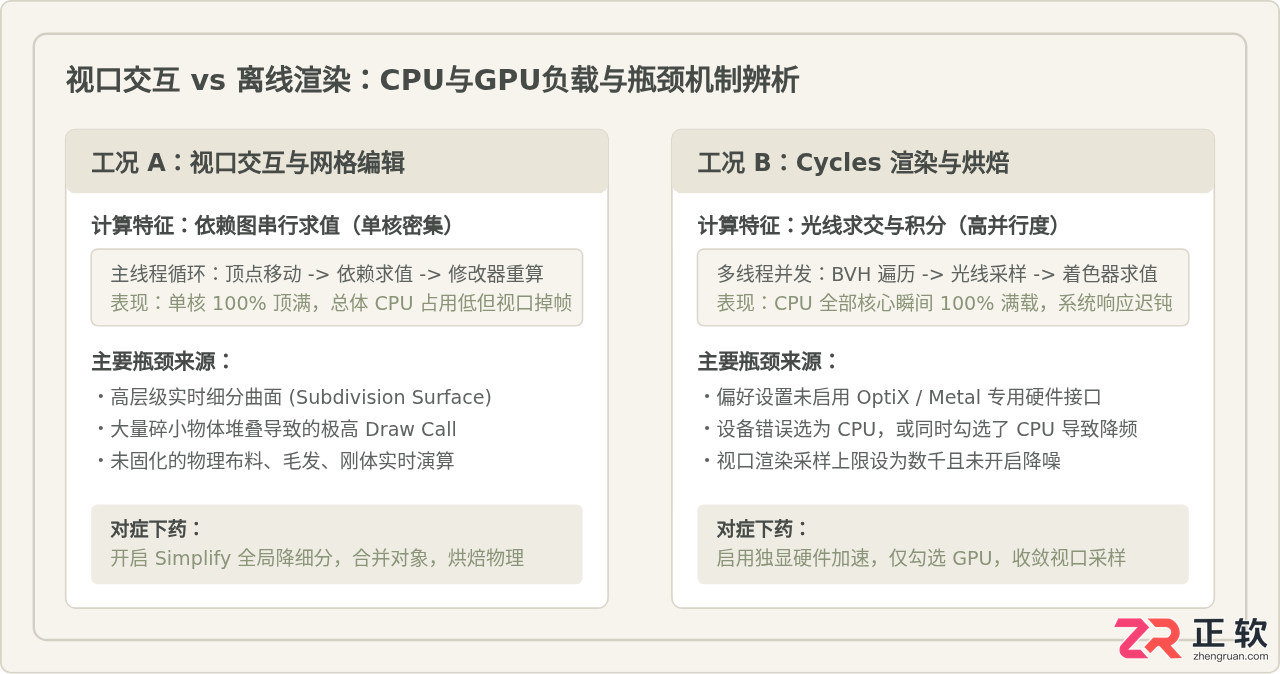
很多用户在使用 Blender 时常有疑惑:明明自己配备了高端多核处理器,为何在编辑网格或旋转视口时依然卡顿,而任务管理器中 CPU 总体占用率可能只有 10% 到 20%;又或者在渲染时 CPU 直接飙升至 100%,整机风扇狂转、系统界面僵死。这实际上对应着两类完全不同的性能瓶颈机制。
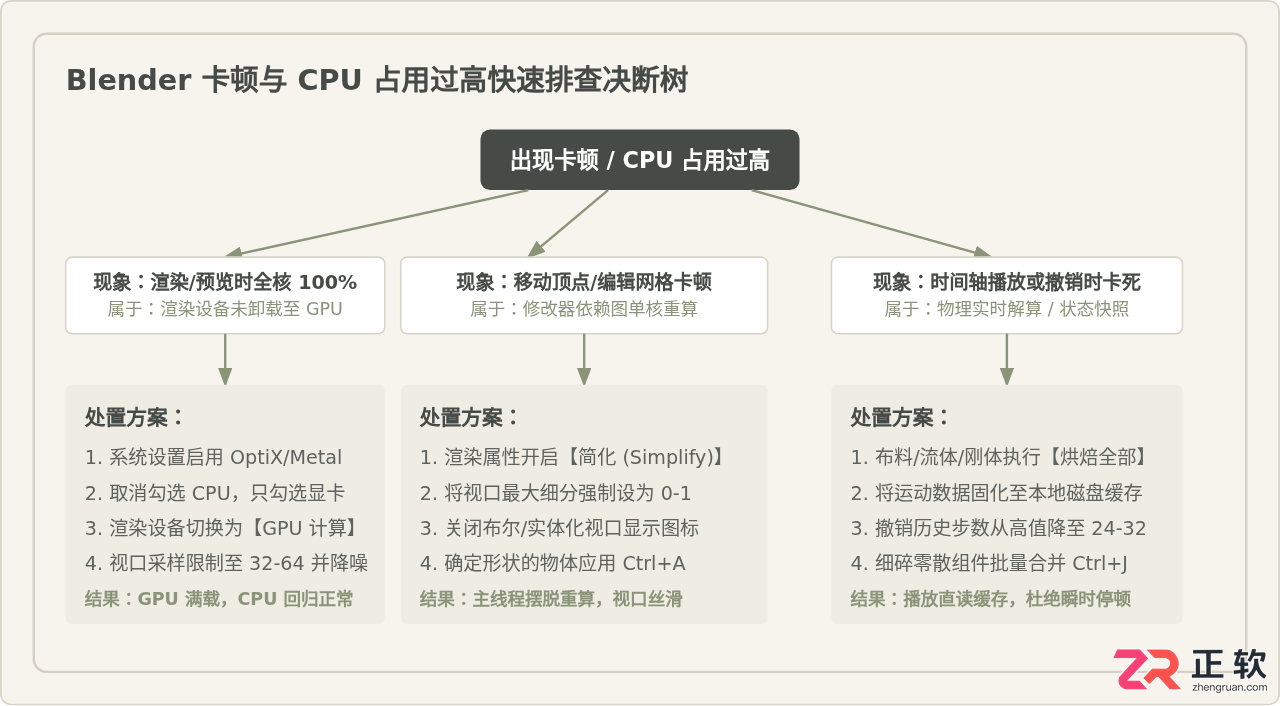
第一类是视口交互与网格求值阶段的单核瓶颈。Blender 的依赖图(Dependency Graph)在处理活动物体的拓扑变换、修改器堆栈求值、骨骼权重变形及装配约束时,绝大部分计算都是严格串行执行的。当你移动一个顶点或拖动物体时,系统必须由主线程单核重新计算所有受影响顶点的最新空间坐标,然后再将几何数据提交给显卡。如果场景中包含了复杂的细分曲面或未烘焙物理,单个 CPU 核心就会瞬间被吃满。在多核心电脑上,一个核心跑满 100% 摊算到总占用上并不起眼,但视口却已经卡成幻灯片。
第二类是渲染计算或后台解算的多核满载。Cycles 渲染器在默认未正确配置时,可能会使用 CPU 线程池来进行光线追踪采样。由于光线求交算法具有天然的并行性,CPU 的所有核心与线程会被全数调动,导致 CPU 占用达到 100%。如果本应由独立显卡承担的工作被错误地交给了 CPU,就会造成极大的计算资源浪费与系统过热。
二、立竿见影:正确配置 GPU 计算设备与视口降噪
解决高 CPU 占用的第一步,是将所有能够并行化的光线渲染工作切实行之有效地转移到 GPU 上。很多初学者即使电脑安装了独立显卡,Blender 默认安装后也往往处于未激活硬件加速的状态。
在偏好设置中激活正确的渲染后端
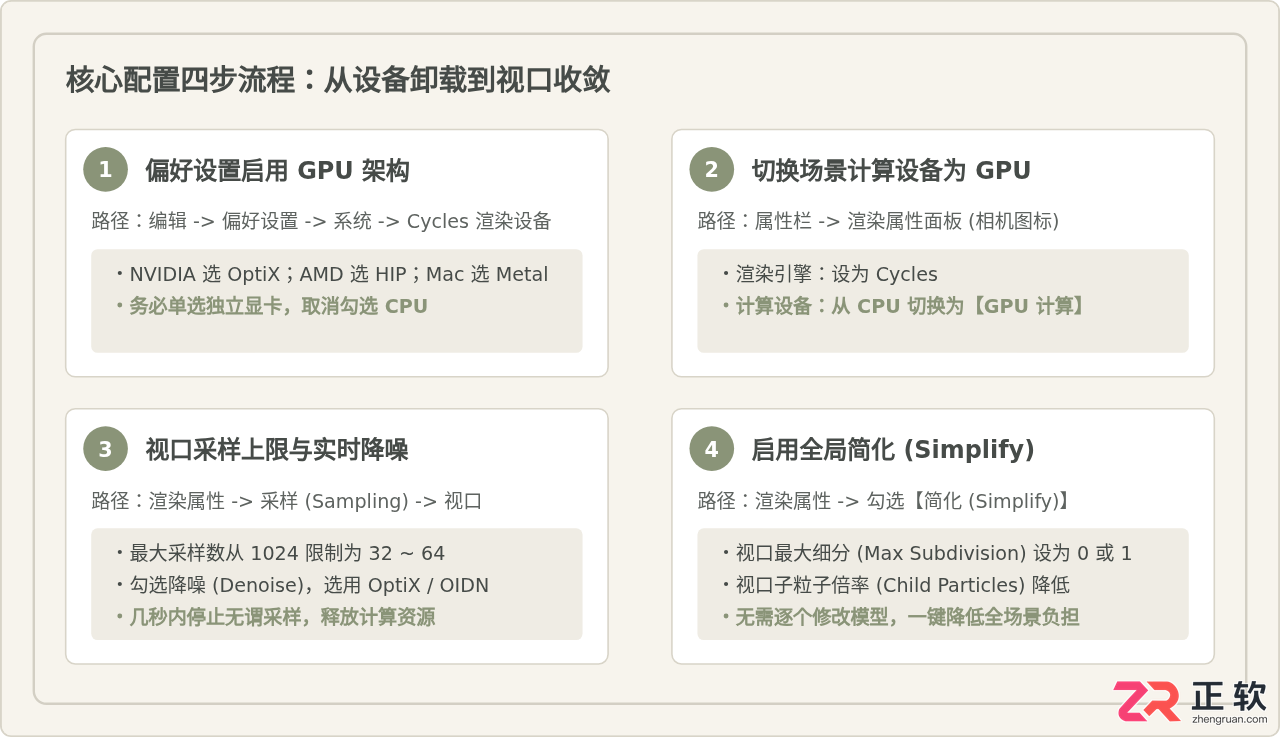
点击顶部菜单栏 编辑 (Edit) -> 偏好设置 (Preferences),在左侧切换到 系统 (System) 面板。找到顶部的“Cycles 渲染设备 (Cycles Render Devices)”:重要注意事项:不要盲目同时勾选 CPU 和 GPU在设备列表中,许多人认为“把 CPU 和显卡都勾选上速度更快”。但在绝大多数现代 PC 上,GPU 的渲染算力是 CPU 的数倍到数十倍。混合渲染时,CPU 必须以极高负载运行,不仅会抢占操作系统的响应资源,而且只要 CPU 分配到的渲染块(Bucket)尚未算完,整张渲染图就无法完成。最有效且发热最低的做法是:仅勾选独立显卡,取消勾选 CPU。
NVIDIA 显卡(RTX系列):务必选择 OptiX。OptiX 可以直接调用 RTX 显卡内置的 RT Core 光追核心,其渲染效率远高于早期的 CUDA 模式。
NVIDIA 显卡(GTX 10系列或更早):选择 CUDA。
AMD 显卡:选择 HIP。
Apple Silicon Mac(M1/M2/M3/M4 系列):选择 Metal。
将场景渲染引擎指定为 GPU 计算
回到主界面,点击右侧属性栏中的 渲染属性 (Render Properties) 面板(相机图标):将 渲染引擎 (Render Engine) 设为 Cycles。
将 设备 (Device) 从默认的 CPU 切换为 GPU 计算 (GPU Compute)。如果该选项显示为灰色不可选,说明前一步在偏好设置中尚未正确勾选显卡。
合理收敛视口最大采样并启用降噪
在渲染属性面板展开 采样 (Sampling) -> 视口 (Viewport):最大采样 (Max Samples):默认往往设置得过高(例如 1024)。在视口着色预览时,将该数值修改为 32 到 64 即可满足交互观察需求。
降噪 (Denoise):勾选该复选框,并将降噪器设为 OptiX(N卡用户)或 OpenImageDenoise。这样在低采样下画面即可迅速平滑收敛,防止视口只要一移动就持续让处理器和显卡进行无谓的重算。
三、治理视口核心元凶:动态修改器与依赖图重算
如果完成上述 GPU 配置后,渲染问题解决了,但在建模、拖动顶点、调整骨骼动画时仍然感到明显卡顿,那么问题几乎百分之百出在修改器的实时依赖求值上。
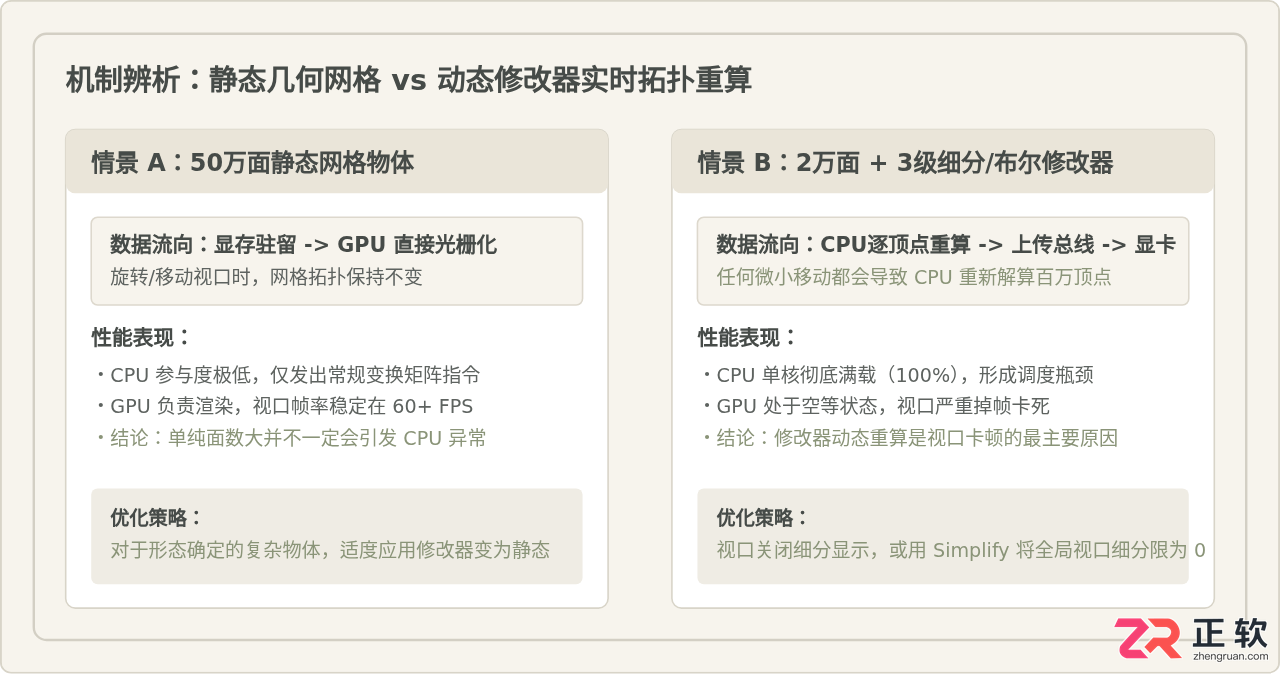
1. 认识常见误区:静态面数多与动态修改器的本质区别
很多制作者有一种直觉误区:“只要场景面数多,电脑就一定会卡,所以卡顿就必须减面”。这种说法在部分情况下成立,但并不准确。现代显卡每秒能够轻松光栅化数百万个三角面。如果一个场景拥有 50 万个面,但全都是已经塌陷好的静态网格物体,在视口中平移、旋转会非常丝滑,CPU 占用极低。
然而,假设一个基础模型仅有 2 万面,你在上面添加了一个级别为 3 的“表面细分”修改器(Subdivision Surface)。此时网格在后台被实时细分为上百万面。更致命的是:每当你移动一个基础顶点,CPU 主线程都必须把这一整套细分算法在内存中重新计算一遍,更新全部顶点的拓扑索引与法线,再重新上传到 GPU 显存。这种频繁的实时重算才是导致 CPU 单核心拉满、视口帧率骤降到个位数的真正元凶。
2. 针对修改器的四项核心减负措施
使用全局“简化 (Simplify)”功能一键降载:不要费力去挨个检查每个物体的修改器。直接前往 渲染属性 -> 勾选 简化 (Simplify)。在展开选项中,将 视口最大细分 (Max Subdivision) 改为 0 或 1。这样即使场景中有一百个开了 3 级细分的物体,在视口中也只按 0 级或 1 级计算,而最终按 F12 渲染时依然会按照原始设置输出高精度画质。
在视口中隐藏高耗修改器:在修改器属性面板中,每个修改器顶部都有一个“显示器”小图标。对于“布尔 (Boolean)”、“实体化 (Solidify)”、“表面细分 (Subdivision Surface)”以及几何节点修改器,在不需要实时预览其效果时,点击关闭该显示器图标,仅在最终渲染时保留。
为完成建模的物体应用 (Apply) 修改器:对于已经确认不再修改基础布线的模型,直接按下 Ctrl + A 应用修改器。将其转化为固定网格后,CPU 就不再需要维护动态求值关系。
按材质或区域合并碎片化物料:如果场景中存在数千个独立小物体(例如螺丝钉、树叶、散落砖块),每个物体在 Blender 中都是独立的依赖节点,每次刷新都会消耗极多 CPU Draw Call。选中同类物体按下 Ctrl + J 进行合并,或者使用集合实例(Collection Instance),可以立竿见影地释放 CPU 调度负担。
四、物理模拟、动画解算与撤销历史的深层优化
除了网格与渲染之外,物理动画与内存管理机制也是导致 CPU 持续高占用的常见潜在诱因。
1. 物理模拟必须执行“烘焙 (Bake)”
很多用户在场景中添加了布料、刚体、流体或粒子后,直接在时间轴上按下空格键循环播放。此时 Blender 会在后台尝试通过 CPU 实时逐帧解算运动轨迹。随着帧数推移,解算量几何级数上升,导致 CPU 占用顶满、视口完全卡死。
正确做法:选中物理物体,进入其 物理属性 (Physics Properties) 面板,找到“缓存 (Cache)”选项,点击 烘焙 (Bake) 或 烘焙全部动力学 (Bake All Dynamics)。将模拟结果一次性写入硬盘缓存文件。烘焙完成后,时间轴播放只会从磁盘读取现成的变形坐标,CPU 占用将直接回落到接近空闲状态。
2. 调整系统撤销历史步数
Blender 默认在内存中记录了大量的撤销步数。每当场景包含复杂模型或高面数物体时,每一次微小操作都会在内存中建立一个场景状态快照。这不仅容易耗尽内存,还会导致垃圾回收机制频繁挂起主进程,出现“每操作两下就卡顿三秒”的现象。
前往 编辑 -> 偏好设置 -> 系统 -> 内存与限制 (Memory & Limits):
将 撤销步数 (Undo Steps) 从默认的 32 或更高降至 24 ~ 32。
勾选 全局撤销 (Global Undo)。
五、如何验证问题已彻底解决
完成上述优化后,可以通过以下客观指标确认 Blender 的性能问题是否已真正排除:
开启视口统计数据 (Scene Statistics):在 3D 视图右上角点击“视图叠加层 (Viewport Overlays)”下拉箭头,勾选 统计数据 (Statistics)。你将能直接在视口左上角看到当前活动网格的面数与顶点数。开启“简化”功能后,观察视口面数是否从百万级显著回落到几十万以内。
观察任务管理器负载分配:
在进行视口旋转、平移或基础顶点移动时,CPU 占用率应维持在 5% 到 15% 的轻度区间,视口无任何肉眼可见的卡顿或黏滞感。
在启动 Cycles 渲染时,观察 GPU 专用计算核心(3D 或 Compute/OptiX)占用率升至 90% 以上,而 CPU 总体占用率回落至 30% 以下,整机系统依然能够自如响应其他前台窗口操作。
时间轴播放帧率测试:按下空格键播放动画,观察 3D 视图左上角的实时帧率(FPS)。经烘焙和细分降载后,复杂工程的视口播放通常能稳定保持在 24 到 60 FPS 满帧运行。
综上所述,Blender 的卡顿与 CPU 过高问题绝非无法解决的玄学。只要明确界定工作状态,将渲染计算扎实交予 GPU,在编辑阶段通过全局简化限制动态修改器的实时求值,并对物理模拟进行及时烘焙,即可让软件的运行性能与流畅度得到最有效的提升。
Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。
极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。
Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。
极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。
Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。