


glean知识库怎么配置教程最简单设置步骤详解
详解Glean知识库的初始化配置步骤,包括管理员设置、主流数据源(如Google Drive、Slack)的连接方法以及权限同步机制,助力企业高效构建统一知识检索中心。
Glean 是一款面向企业的 AI 驱动搜索平台,旨在将分散在不同 SaaS 应用中的信息整合到一个统一的搜索界面中。对于刚接触 Glean 的管理员来说,配置过程的核心在于“连接数据”与“设定权限”,而非复杂的代码开发。只要理清数据流向和访问控制逻辑,就能快速完成基础部署。
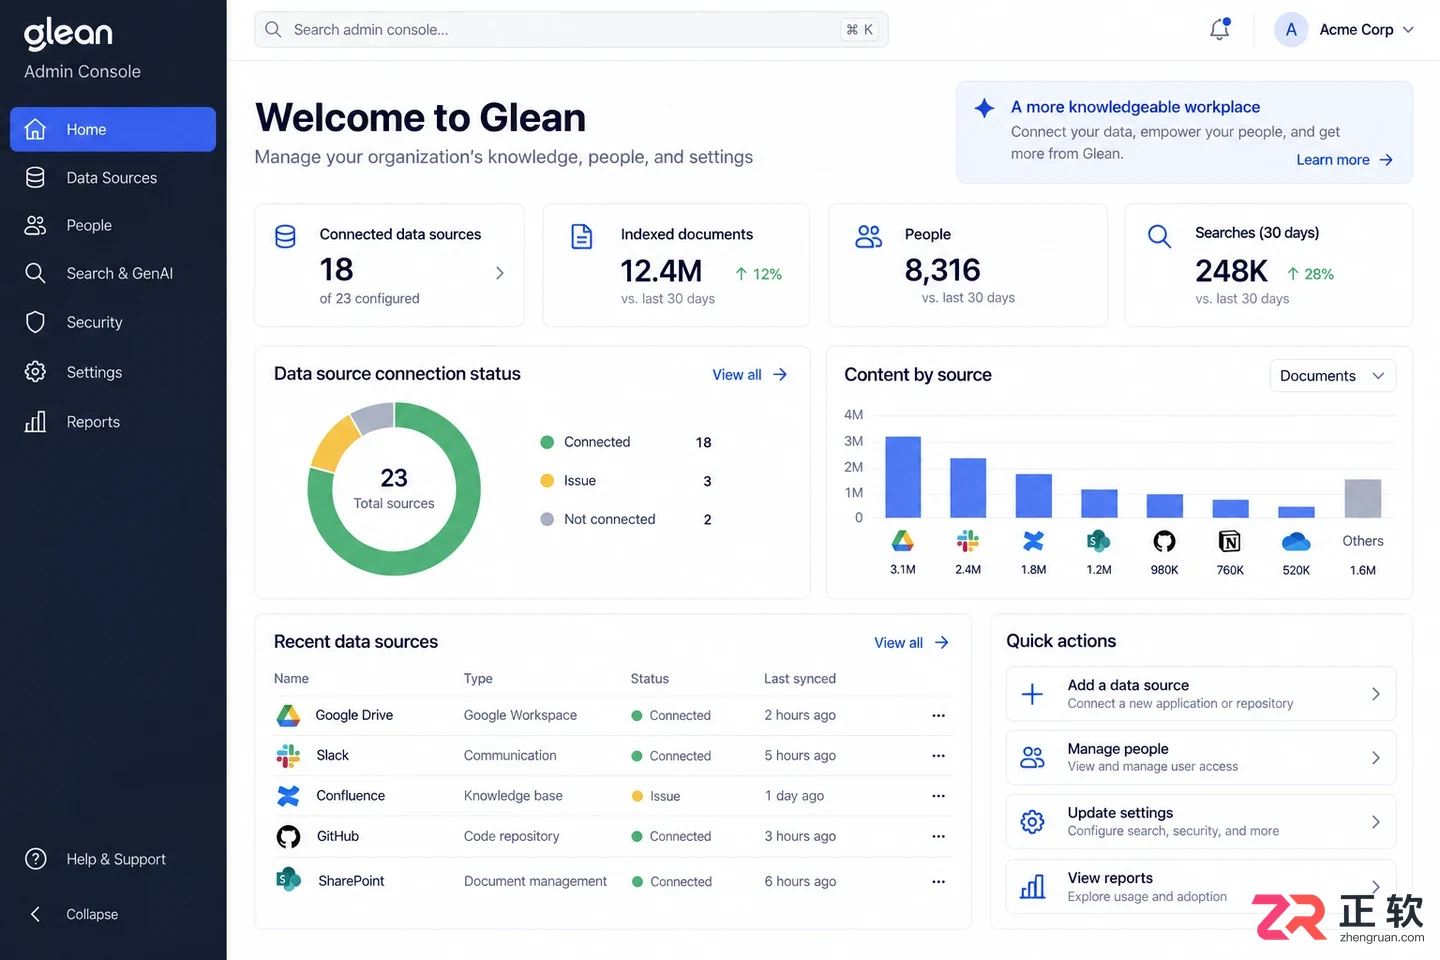
Glean 管理员控制台左侧导航栏显示了数据源、人员和设置等主要配置模块
关于【管理员控制台入口】
配置工作始于 Glean 的管理员控制台。通常,只有被指派为 Admin 角色的用户才能访问此区域。登录后,界面左侧导航栏会显示主要的配置模块,包括 Data Sources(数据源)、People(人员目录)和 Settings(设置)。
在开始具体连接之前,建议先确认 Organization Settings 中的基本信息,如公司域名和默认语言。这一步确保了后续生成的搜索结果链接能够正确指向企业内部地址,避免用户点击后出现跳转错误。
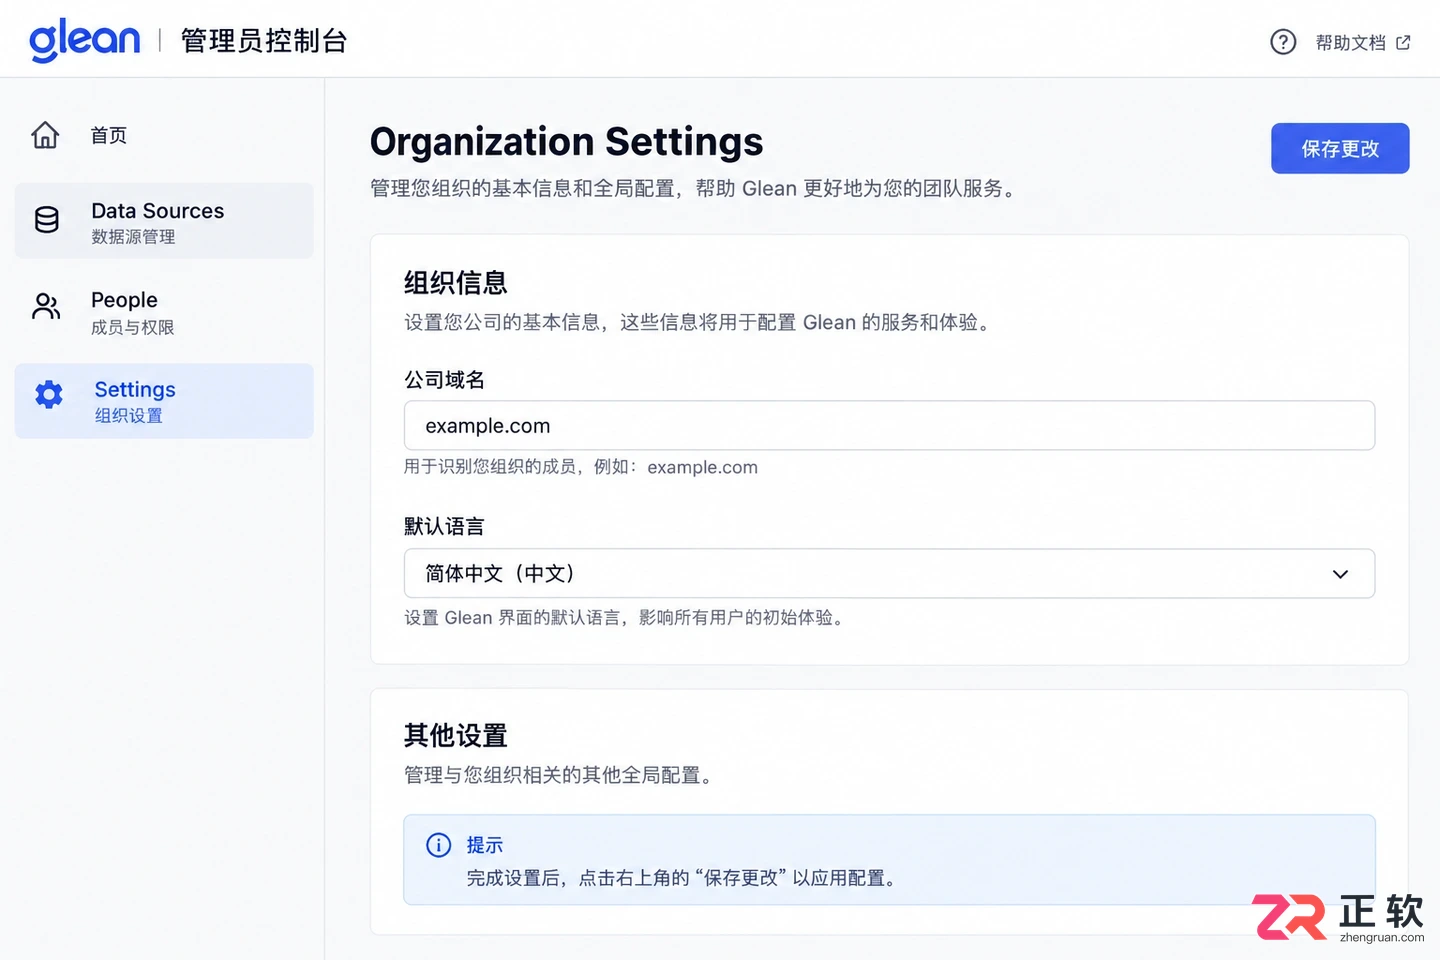
关于【管理员控制台入口】
关于【数据源连接】
数据源是 Glean 的知识基石。在 Data Sources 页面,你会看到一系列预集成的连接器,涵盖了 Google Workspace、Microsoft 365、Slack、Confluence、GitHub 等主流工具。
配置单个数据源的典型步骤如下:
- 选择目标应用,例如 Google Drive。
- 点击 Connect,系统会引导你通过 OAuth 协议进行授权。这通常需要用一个具有全局读取权限的服务账号或管理员账号登录。
- 授权完成后,返回控制台查看连接状态。状态显示为 Active 即表示连接成功。
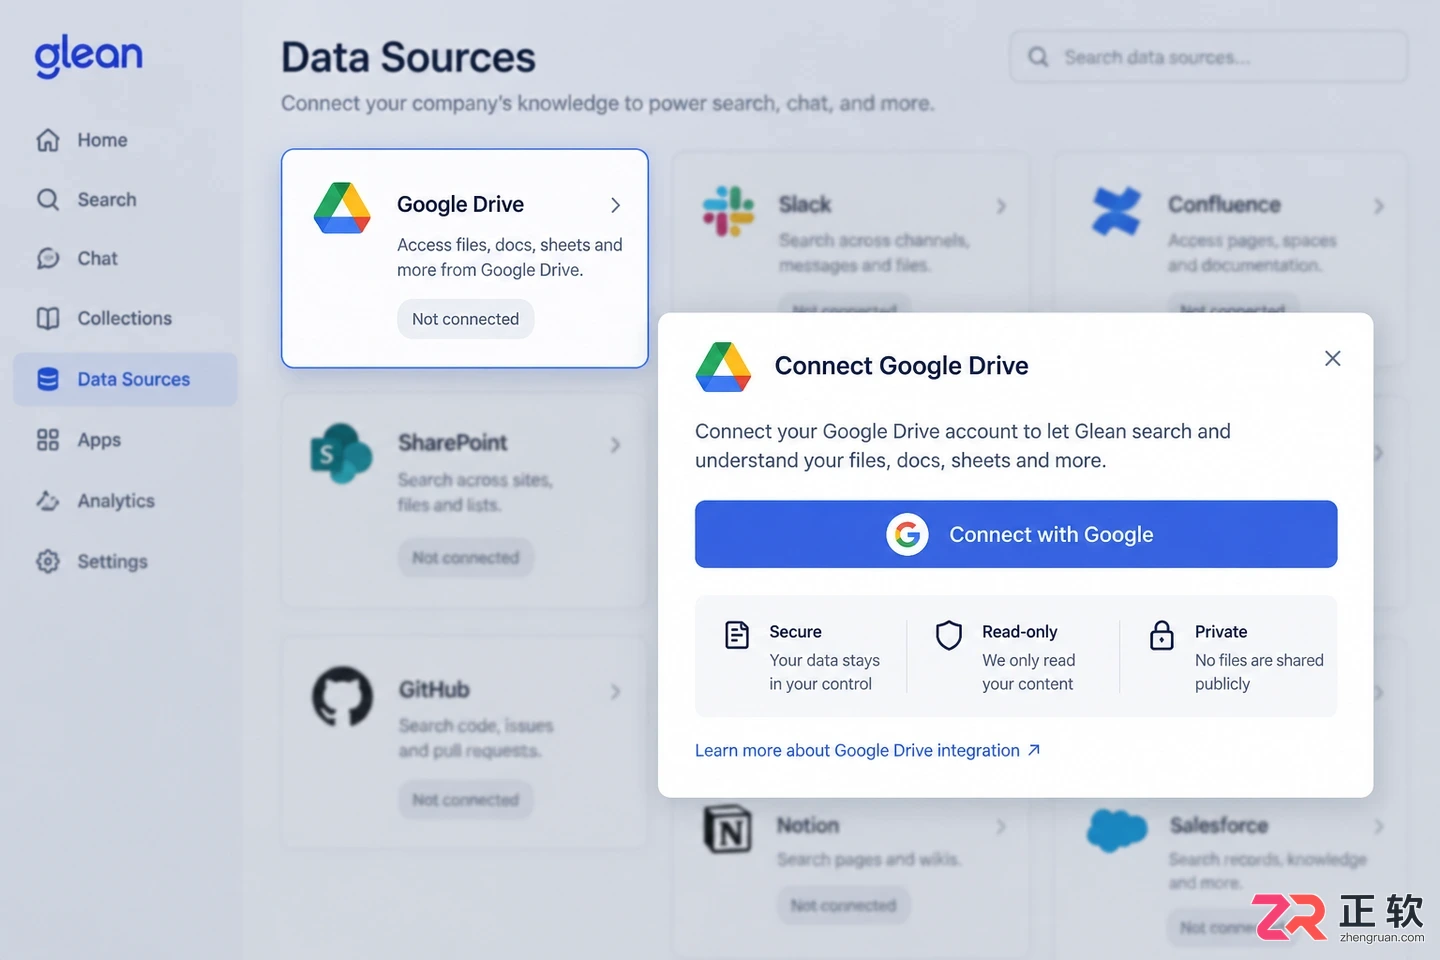
在 Data Sources 页面选择 Google Drive 并进行 OAuth 授权的示意界面
对于大多数团队,优先连接使用频率最高的两三个应用即可,无需一次性接入所有系统。这样可以缩短初始索引时间,让团队更快体验到搜索功能。
关于【权限与可见性映射】
Glean 的核心优势之一是遵循“最小权限原则”,即用户在 Glean 中只能搜到他们在原始应用中有权访问的内容。因此,权限映射是配置中不可或缺的一环。
在 People 或 Directory Sync 设置中,你需要配置用户目录同步。Glean 支持通过 SCIM 协议与 Okta、Azure AD 或 Google Directory 同步。确保用户组(Groups)和角色(Roles)正确映射,这样当员工离职或转岗时,其搜索权限会自动更新,保障信息安全。
如果在特定数据源中存在特殊的访问控制列表(ACL),Glean 通常会在索引过程中自动抓取这些元数据。管理员只需在 Data Source 的详细设置中确认“Respect Permissions”选项已开启。
关于【索引与刷新策略】
连接建立后,Glean 需要时间来抓取和索引历史数据。在 Indexing Status 面板中,你可以监控每个数据源的进度。首次全量索引可能耗时数小时至数天,取决于数据体量。
为了保持知识库的新鲜度,Glean 默认会设置增量索引计划。管理员可以在 Settings 中调整刷新频率。对于变动频繁的平台如 Slack 或 Jira,建议保持较高的刷新频率;而对于相对静态的 Confluence 文档库,可以适当降低频率以节省资源。
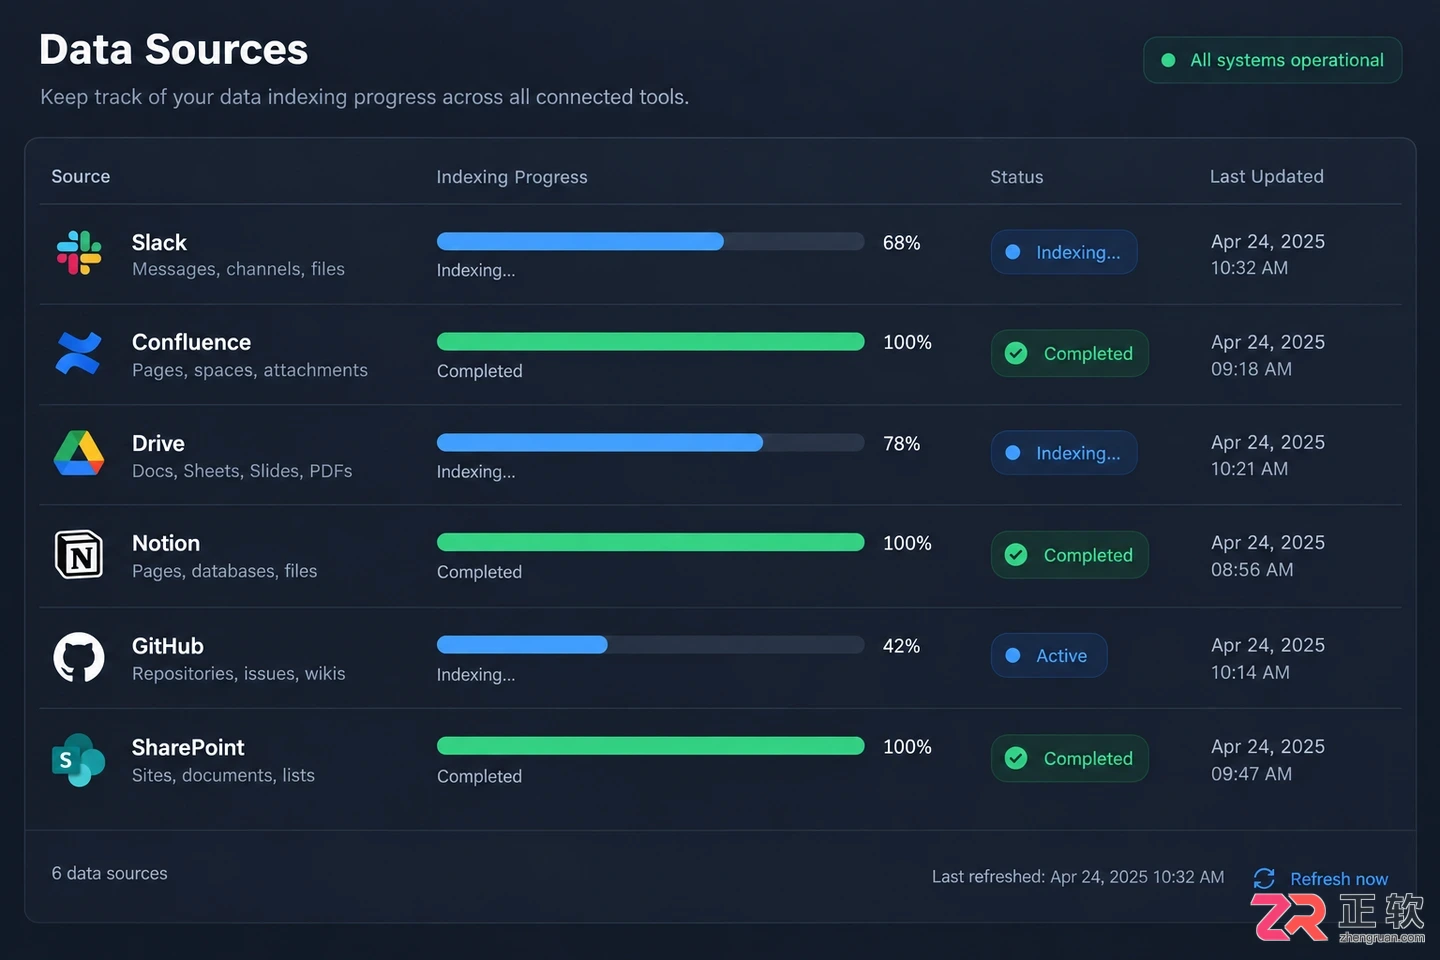
Indexing Status 面板显示各数据源的抓取进度和最后更新时间
关于【基础搜索体验优化】
当索引完成后,基础的搜索功能即可用。但为了提升体验,管理员可以配置 Synonyms(同义词)和 Boosts(权重提升)。
例如,如果公司内部习惯将“人力资源”称为“HR”,可以在 Synonyms 设置中添加这一对应关系,确保用户搜索任一词汇都能得到相同的结果。此外,对于重要的官方文档库,可以使用 Boosts 功能提高其在搜索结果中的排名,确保权威信息优先展示。
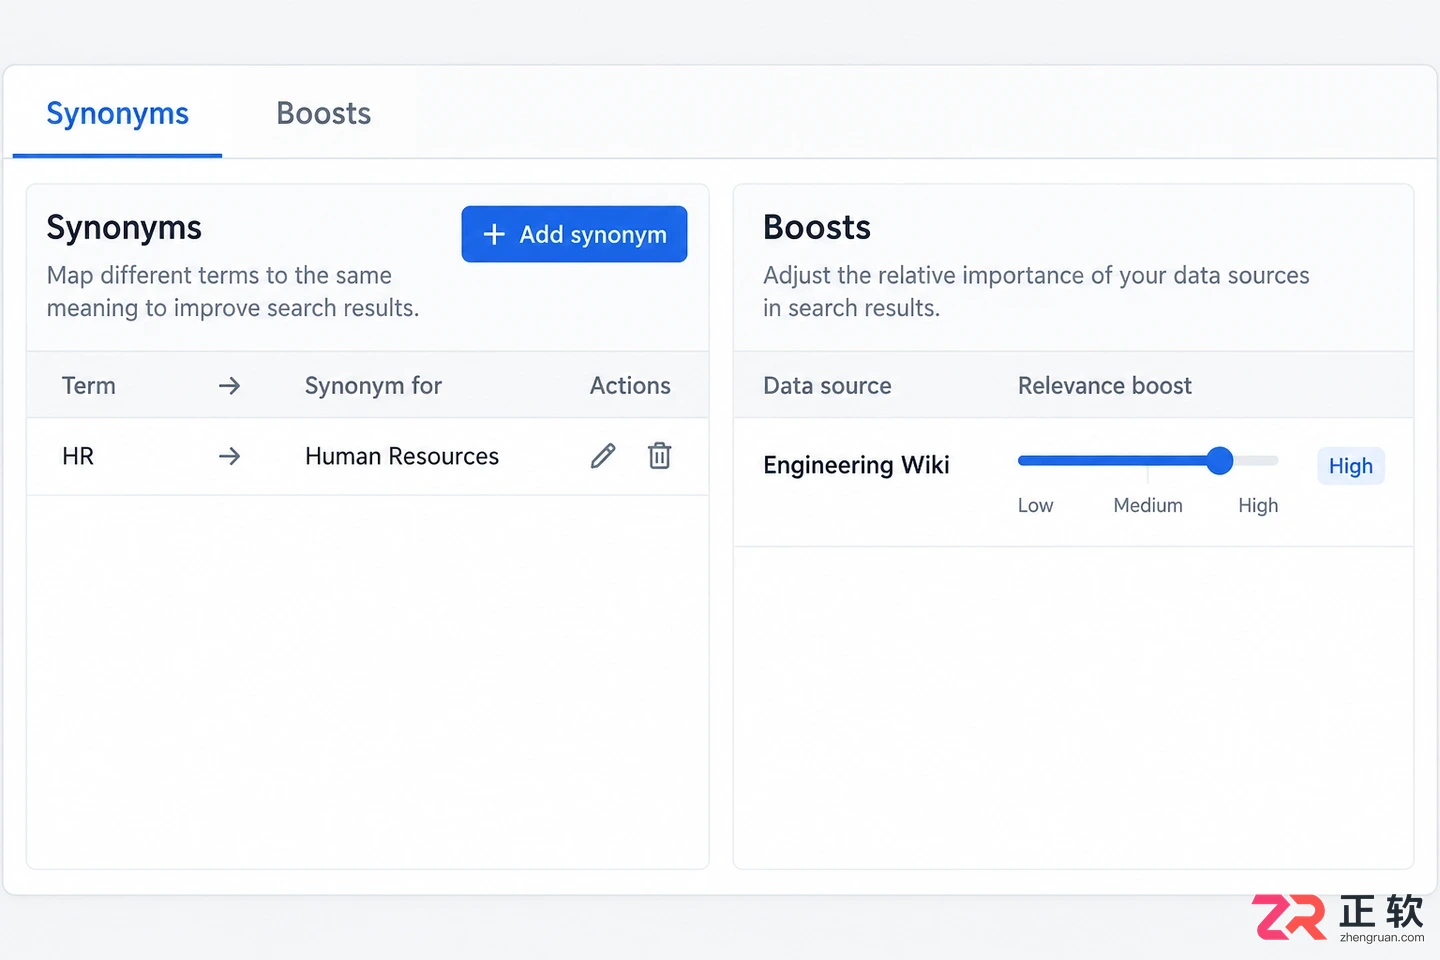
Search Experience 设置中的 Synonyms 和 Boosts 配置示例
完成上述步骤后,Glean 知识库便具备了基本的运行能力。团队成员可以通过浏览器插件、桌面应用或 Web 界面开始使用统一搜索。后续可根据实际使用反馈,逐步细化数据源范围和优化排序规则。





Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。




一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。


CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。

Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。