


格灵深瞳发布大规模中文视觉语言预训练数据集:丹青
格灵深瞳发布超大规模中文视觉语言预训练数据集“丹青”,包含1亿条2024至2025年公开图文样本,引入精细清洗与评估机制。基于SigLIP2的测试表明,其在零样本分类、跨模态检索及多模态评估中性能突出。构建时采用BERTopic算法,经UMAP降维与HDBSCAN聚类,结合类别加权TF-IDF提取关键词。
格灵深瞳最近放出了一个重磅消息:他们正式推出了一个名为“丹青”(DanQing)的超大规模中文视觉-语言预训练数据集。这个数据集的规模有多大?足足1亿条高质量的图文匹配样本,数据采集时间覆盖了2024到2025年的全网公开资源。更关键的是,它引入了一套更精细的数据清洗与质量评估机制。
从实际测试结果来看,“丹青”的表现确实亮眼。基于SigLIP2模型开展的基准测试显示,它在零样本图像分类、跨模态图文检索以及大型多模态模型综合能力评估等多项关键任务中,都展现出了相当突出的性能。
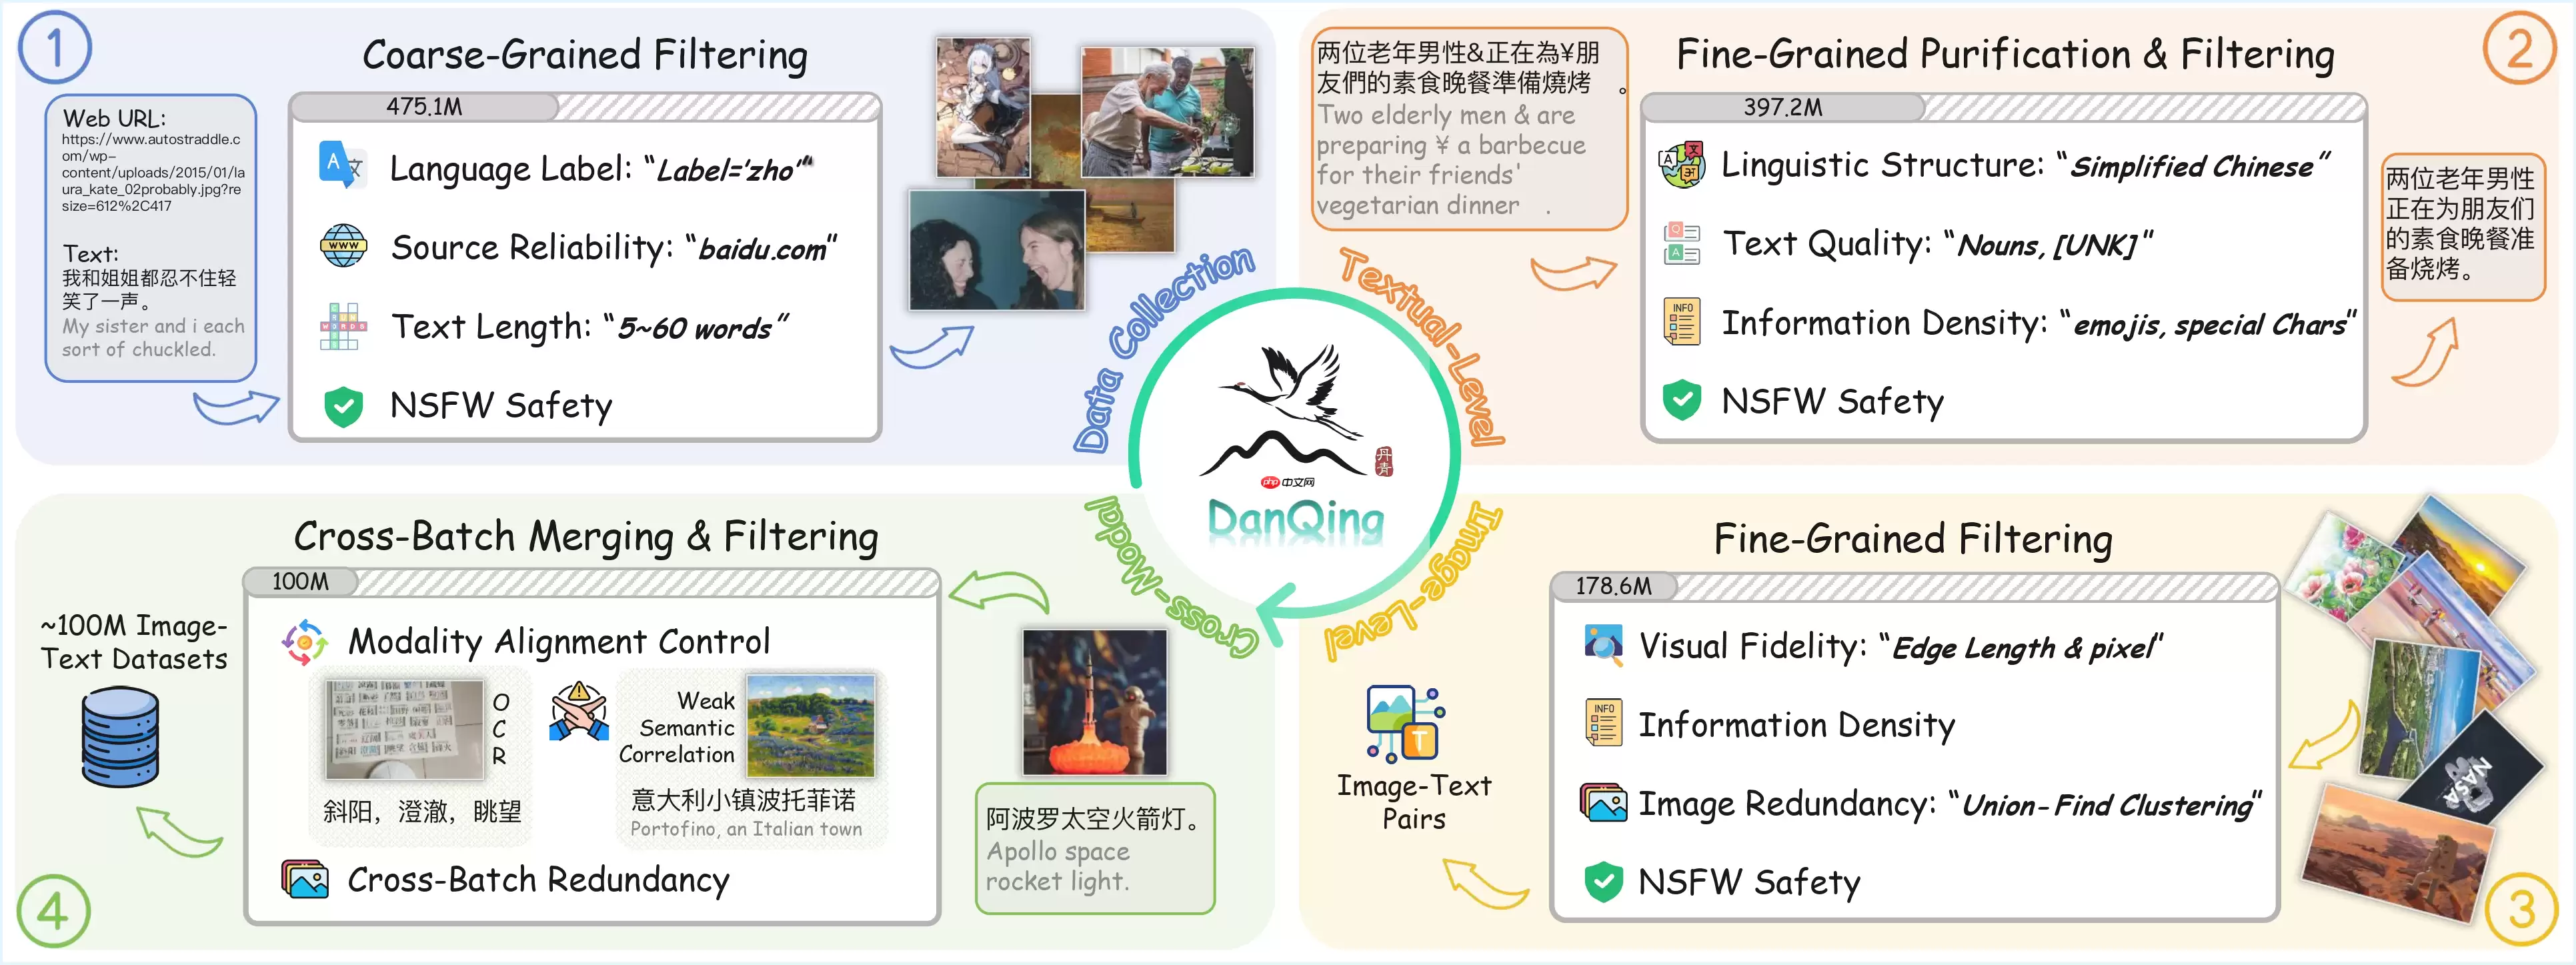
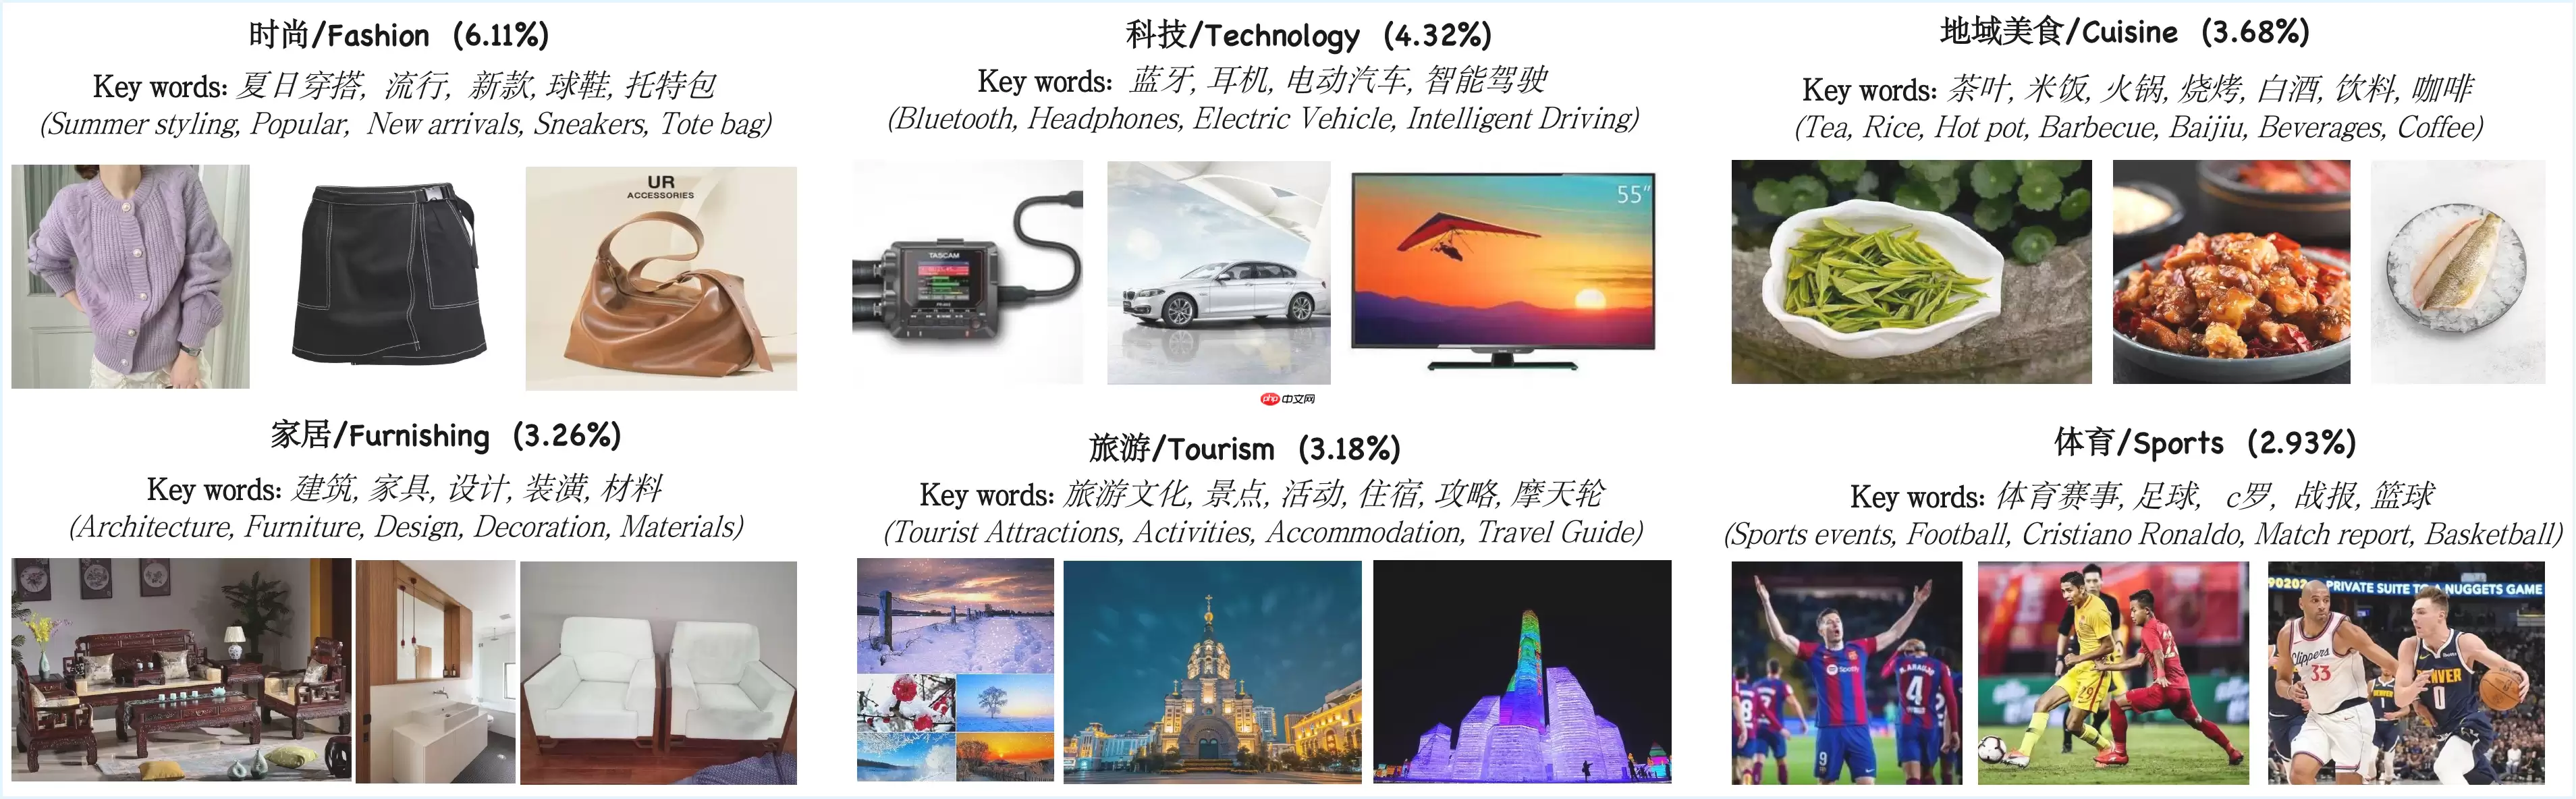
那么,这个数据集是怎么构建出来的?项目团队透露,他们搭建了一套融合BERTopic算法的主题建模pipeline。具体流程是这样的:先从全量数据中随机采样1000万组图像-文本对,然后用Chinese-CLIP-L/14模型提取文本侧的语义嵌入向量。这里有个技术难点——高维空间聚类容易受到噪声干扰,所以团队先通过UMAP做了非线性降维,再用HDBSCAN算法来识别语义密集的簇,并且把最小簇规模设定为1000,这样既能增强聚类的鲁棒性,又能有效抑制离群噪声。最后,基于各个主题内部的词频分布,采用类别加权TF-IDF策略,提取出最具代表性的关键词集合。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。
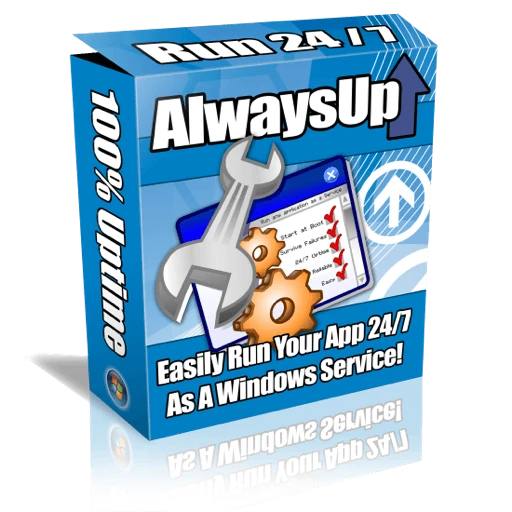
AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。