
导读:本文主要分为三个部分:概述中介绍可观测性的基本概念,主要包括 Logging、Metrics、Tracing 三个方面;然后详细介绍函数计算上的 Logging、Metrics、Tracing;最后以几个常见场景为例,介绍在函数计算中如何快速定位问题并解决问题。
概述
可观测性是什么呢?维基百科中这样说:可观测性是通过外部表现判断系统内部状态的衡量方式。
在应用开发中,可观测性帮助我们判断系统内部的健康状况。在系统出现问题时,帮助我们定位问题、排查问题、分析问题;在系统平稳运行时,帮助我们评估风险,预测可能出现的问题。评估风险类似于天气预报,预测到明天下雨,那出门就要带伞。在函数计算的应用开发中,如果观察到函数的并发度持续升高,很可能是业务推广团队的努力工作导致业务规模迅速扩张,为了避免达到并发度限制触发流控,开发者就需要提前提升并发度。
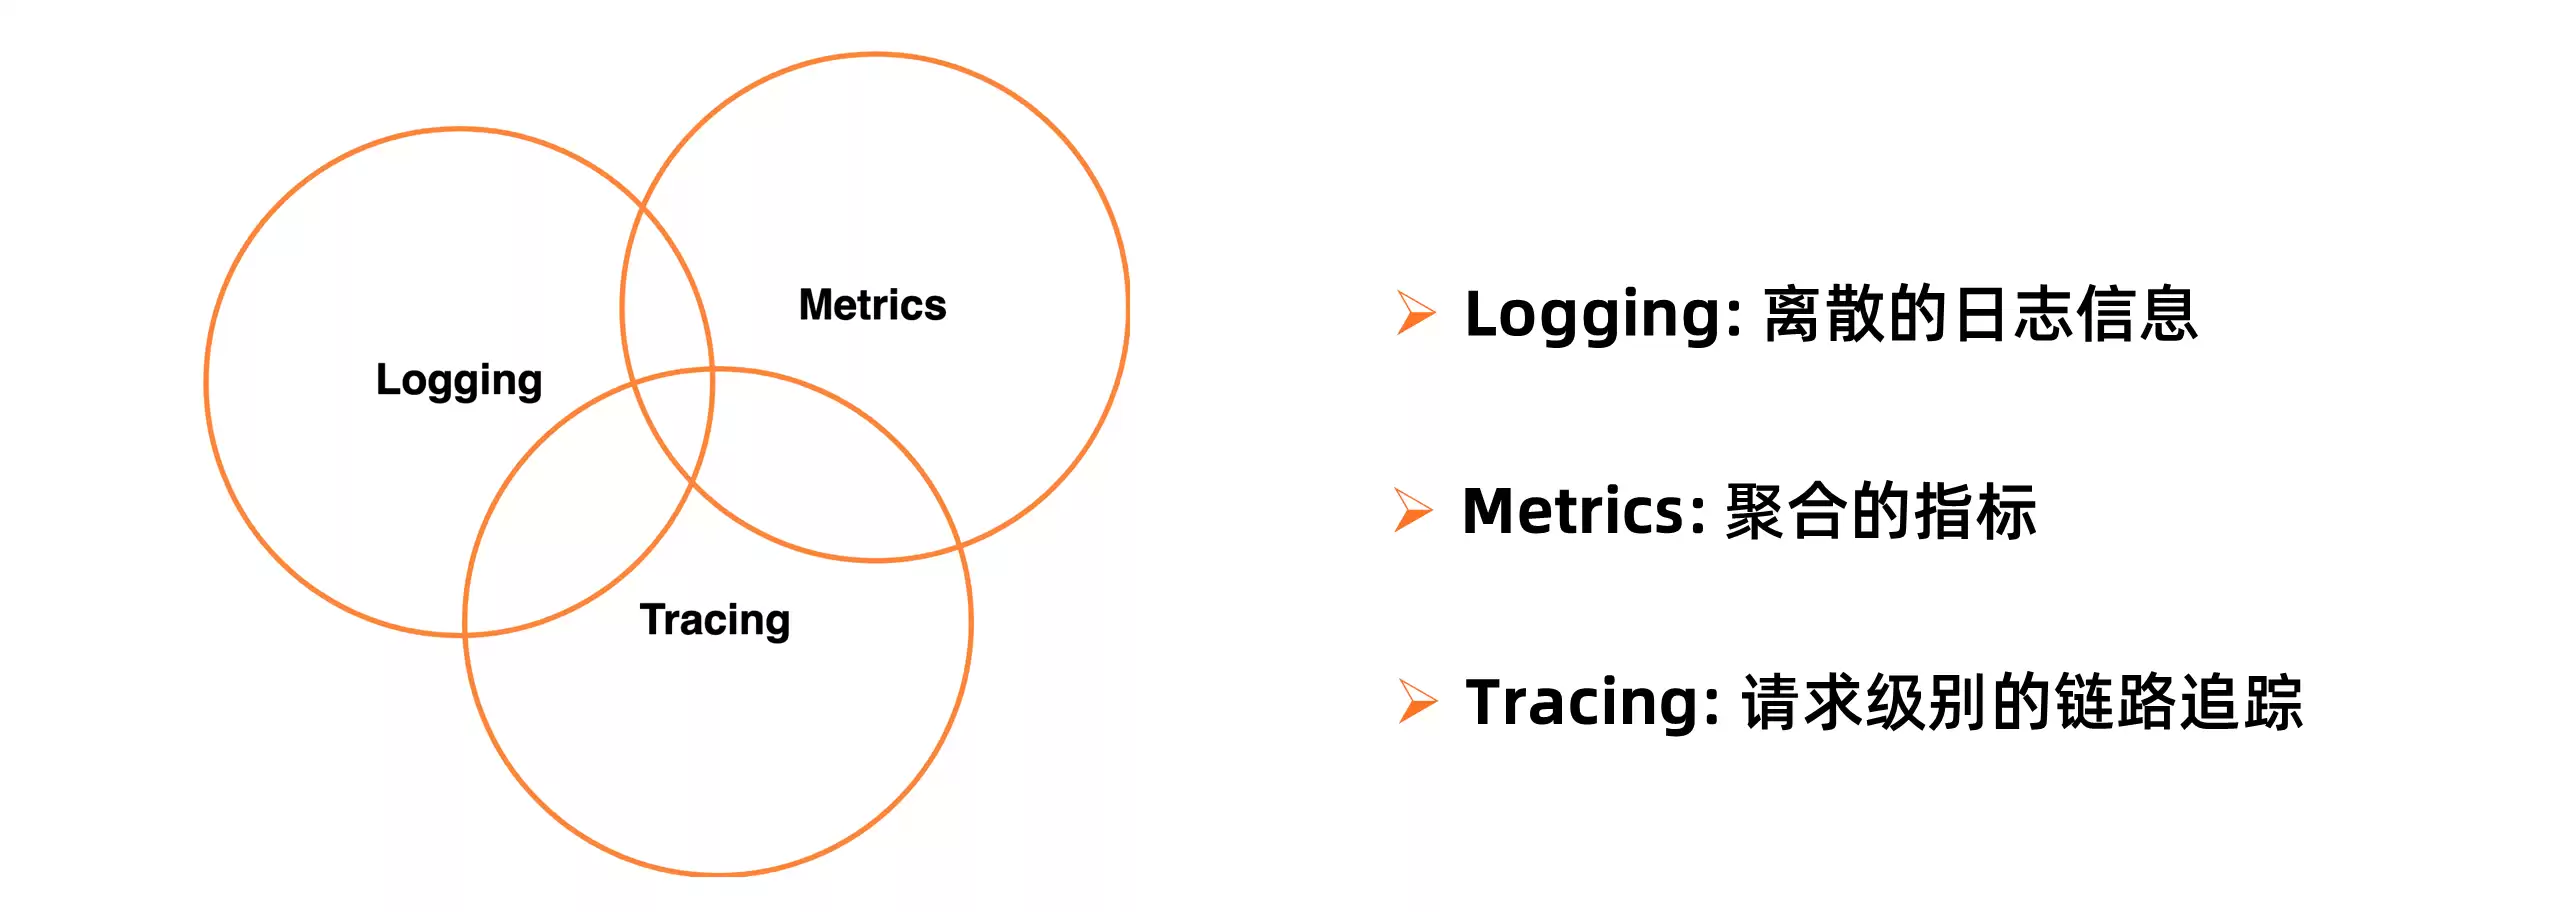
可观测性包括三个方面:Logging、Metrics、Tracing
- Logging 是日志,日志记录了函数运行中的关键信息,这些信息是离散且具体的,结合错误日志与函数代码可以迅速定位问题。
- Metrics 是指标,是聚合的数据,通常以图表的形式展现。图表中的 tps、错误率等核心指标,可以反映函数的运行情况与健康状况。
- Tracing 是链路追踪,是请求级别的追踪,在分布式系统中可以看到请求在各个模块的延时、分析性能瓶颈。
函数计算中的 Logging/Metrics/Tracing
1. 日志
在函数计算中如何查看函数日志呢?在传统服务器开发方式中,可以将日志记录到磁盘中的某个文件中,再通过日志收集工具收集文件的内容;而在函数计算中,开发者不需要维护服务器了,那如何收集代码里打印的日志呢?
1)配置日志
函数计算与日志服务的集成堪称无缝,它能够把函数日志精准记录到开发者所提供的日志仓库(Logstore)里。要知道,日志可是服务配置中的关键一项,得为服务配置好LogProject和Logstore才行。这样一来,同一服务下所有函数通过stdout打印出来的日志,都会被自动收集到对应的Logstore当中。
2)记录日志
那日志该怎么打呢?在代码中直接通过console.log/print打印的日志能收集到吗?答案是肯定的。各个开发语言提供的打印日志的库都会把日志打印到stdout,像node.js的console.log()、python的print()、golang的fmt.Println()等等。函数计算会收集所有打印到stdout的日志,并将其上传到Logstore中。
函数计算的调用是请求维度的,每次调用对应一个请求,也就对应一个 requestID。当请求量很大时,会有海量日志,如何区分哪些日志属于哪个请求呢?这就需要把 requestID 一起记录到日志中。函数计算提供内置的日志语句,打印的每条日志前都会带上请求 ID,方便日志的筛选。
3)查看日志
当函数日志被收集到日志服务的 Logstore 中,可以登录日志服务控制台查看日志。
同时,函数计算控制台也集成了日志服务,可以在函数计算控制台上查看日志。函数计算控制台有两种查询方式:
- 简单查询:简单查询中列出每个 requestID 对应的日志,可以通过 requestID 对日志进行筛选;
- 高级查询:高级查询嵌入了日志服务,可以通过 SQL 语句进行查询。
点击链接观看 Demo 演示:https://developer.aliyun.com/lesson_2024_18996
2. 指标
查看指标的方式:
- **函数详情查看监控指标:**FC 提供丰富的系统指标,这些指标可以不用任何配置,就可以在函数计算控制台查看。
- **配置日志大盘:**日志大盘不仅可以看到函数计算提供的监控指标,而且可以与开发者日志关联,生成自定义的监控指标。
3. 链路追踪
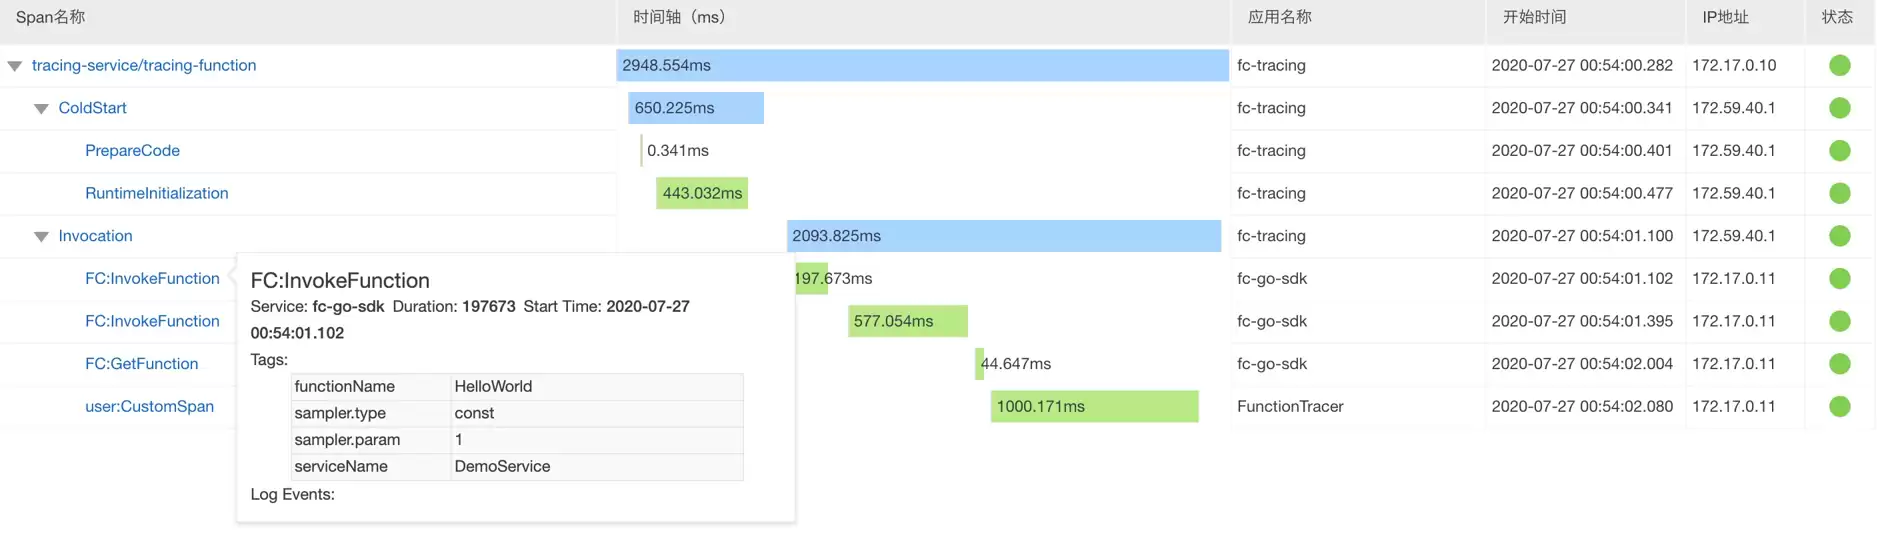 (请求在各个链路的延时瀑布图)
链路追踪是分布式系统排查问题的重要一环,链路追踪可以分析分布式系统中请求在各个链路的时延。有以下几种情况:
- 函数计算作为整个链路中的一环,可以看到请求在函数计算上的时延,时延包括系统启动的时间和请求真正的执行时间,帮助用户分析性能瓶颈。
- 函数计算中调用 FC SDK,可以默认看到 SDK API 的调用时延。
- 开发者在函数代码中访问数据库等产品,可以手动在函数中埋点分析这段时延。
问题排查
函数计算提供了很多可观测性相关的功能,那究竟怎样定位问题呢?以几个场景为例。
场景一:新版本发布后,函数错误率升高
首先发布版本后要观察函数各项指标,一旦错误率升高要立即回滚避免故障,查看函数日志定位错误原因,修复问题再次上线。
场景二:函数性能差,总是执行时间很长,甚至超时
开启 tracing 功能,在函数内部可能耗时的地方进行埋点,查看请求的瀑布图,定位执行时间长的原因,修复问题。
场景三:业务量迅速扩张,并发度即将到达并发度限制
通过 metrics 查看当前并发度,观察到并发度持续上升时,及时联系函数计算开发同学,提升并发度。
Serverless 公众号,发布 Serverless 技术最新资讯,汇集 Serverless 技术最全内容,关注 Serverless 趋势,更关注你落地实践中的遇到的困惑和问题。



