


Curve技术解析之MDS元数据管理
Curve简介Curve是网易数帆于今年7月份开源的一个高性能、高可用、高可靠的分布式存储系统,主打高性能、低延迟。Curve设计可以作为多种存储场景的底层存储:例如块存储,对象存储,云原生数据库,EC等。当前Curve已实现高性能块存储,并且基于这⼀场景对接了OpenStack 和 Kuberne
Curve简介
Curve是网易数帆于今年7月份开源的一个高性能、高可用、高可靠的分布式存储系统,主打高性能、低延迟。
Curve设计可以作为多种存储场景的底层存储:例如块存储,对象存储,云原生数据库,EC等。
当前Curve已实现高性能块存储,并且基于这⼀场景对接了OpenStack 和 Kubernetes。OpenStack上主要是用做云主机的系统盘和云盘,目前已经在线上稳定一年多了。Kubernetes上主要是想作为计算节点的数据目录,这个场景目前在灰度环境中测试验证中。
github主页:https://opencurve.github.io/
github代码仓库:https://github.com/opencurve/curve
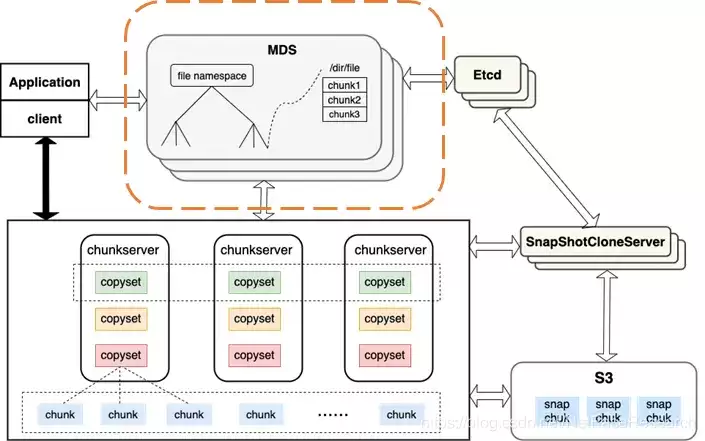
如上图所示,Curve存储系统的基础设计框架与经典的GFS基本类似,采用有中心节点的架构,核心服务由三个部分组成:
元数据节点MDS,主要有两个职责,一方面管理和存储元数据信息,另一方面感知集群状态并进行调度。元数据存储在etcd中。
数据节点ChunkServer, 一方面负责数据的存储,另一方面负责数据一致性(如果底层是多副本,需要负责副本间的数据一致性)。
客户端Client, 向上层应用提供对文件的操作接口(open、read、write等), 会和MDS以及ChunkServer交互,与MDS交互实现对元数据的增删改查;与ChunkServer交互实现对数据的增删改查。
还有一个快照克隆服务器:
快照克隆服务器独立于核心服务,对外提供了http接口,用于处理和管理快照克隆任务。
这篇文章会介绍Curve的元数据的管理,主要是MDS的元数据的管理。
MDS是Curve的元数据管理服务,负责整个集群的元数据管理。MDS的所有元数据信息都会持久化到kv存储中,Curve选择了etcd作为元数据的存储。
为了加快元数据的访问,mds还在内存维护了一个元数据的cache。cache采用LRU(Least Recently Used)淘汰策略,cache最多缓存的记录条目数量,通过mds的配置文件进行配置。
mds存储的元数据包含拓扑信息的元数据,namespace的元数据。所有的信息都是经过一定的编码,以kv的方式保存在元数据中。不同类型的元数据的编码方式不同,所有保存在mds的元数据的key都是以 “prefix + 其他字段”的方式进行编码。value则是对应的元数据序列化为字符串。
不同类型的元数据的前缀不同,这些前缀比如:
const char FILEINFOKEYPREFIX[] = "01";const char SEGMENTINFOKEYPREFIX[] = "02";const char SNAPSHOTFILEINFOKEYPREFIX[] = "03";const char CHUNKSTOREKEY[] = "05";const char TOPOLOGYITEMPRIFIX[] = "10";拓扑元数据信息
curve的拓扑信息由mds的topology模块管理,topology管理集群的 topo元数据信息。用于管理和组织机器,利用底层机器的放置、网络的规划以面向业务提供如下功能和非功能需求。
故障域的隔离:比如副本的放置分布在不同机器,不同机架,或是不同的交换机下面。
隔离和共享:不同用户的数据可以实现固定物理资源的隔离和共享。
下图是一个topology的层级关系图。一个集群可以支持1到多个Pool,每个Pool下有多个zone,每个zone由多个server组成,每个server上有多个chunkserver。
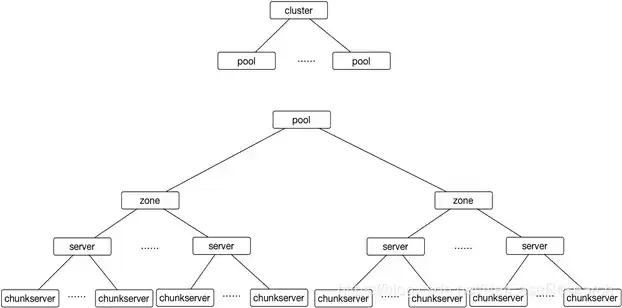
介绍一下各个组件的概念。
pool:用于实现对机器资源进行物理隔离,server不能跨Pool交互。运维上,建议以pool为单元进行物理资源的扩容。
zone:故障隔离的基本单元,一般来说属于不同zone的机器至少是部署在不同的机架,一个server必须归属于一个zone。
server:用于抽象描述一台物理服务器,chunkserver必须归属一个于server。
Chunkserver:用于抽象描述物理服务器上的一块物理磁盘(SSD),chunkserver以一块磁盘作为最小的服务单元。
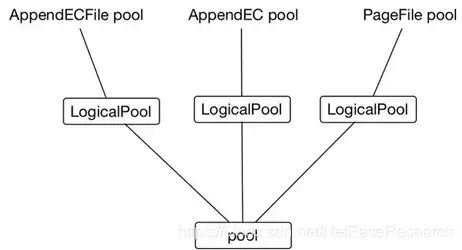
curve在上物理pool之上又引入了逻辑pool的概念,以实现统一存储系统的需求,即在单个存储系统中可以同时支持块存储、对象存储、进行对象存储。
Curve底层通过不同的文件类型支撑不同上层应用, curve的数据组织形式是文件。Curve提供三种文件类型,PageFile、AppendFile、AppendECFile
PageFile支持块设备。
AppendFile支持在线对象存储(规划中)。
AppendECFile支持近线对象存储可以共存(规划中)。
目前我们只实现了对块存储的支持。
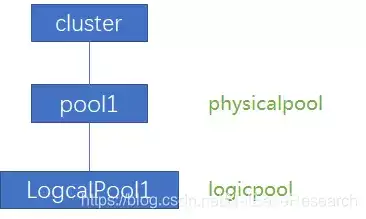
如下图所示LogicalPool与物理pool为多对一的关系,一个物理pool可以存放各种类型的file。当然由于curve支持多个pool,可以选择一个logicalPool独享一个pool。
topo的元数据信息的来源有两种:一部分是curve集群上线时确定的;还有一部分是集群在运行的过程中,通过心跳上报的信息。
集群上线的topo信息,这个是集群上线时,在配置文件中指定。比如下面是一个新集群上线的例子,一个简单的配置文件如下。在这个集群中,有一个物理pool pool1,这个物理pool由3个zone组成,分别为zone1, zone2, zone3。每个zone有一台server。在物理pool上,还创建了一个逻辑pool,逻辑pool使用3个zone,采用3副本。
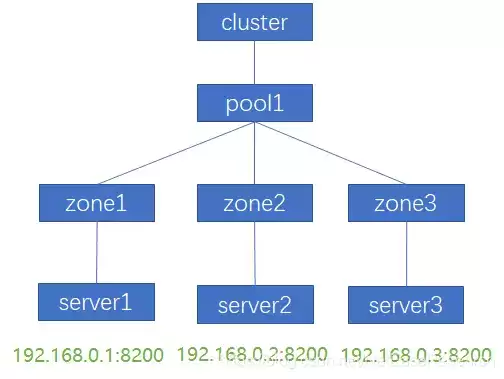
cluster_map: servers: - name: server1 internalip: 192.168.0.1 internalport: 8200 externalip: 192.168.0.1 externalport: 8200 zone: zone1 physicalpool: pool1 - name: server2 internalip: 192.168.0.2 internalport: 8200 externalip: 192.168.0.2 externalport: 8200 zone: zone2 physicalpool: pool1 - name: server3 internalip: 192.168.0.3 internalport: 8200 externalip: 192.168.0.3 externalport: 8200 zone: zone3 physicalpool: pool1 logicalpools: - name: logicalPool1 physicalpool: pool1 type: 0 replicasnum: 3 copysetnum: 100 zonenum: 3 scatterwidth: 0心跳上报的topo信息,主要是chunkserver与mds之间的心跳信息。chunkserver会定时向mds发送心跳信息,该信息中带有chunkserver的状态信息,如负载、容量、副本状态、是否可用等。mds依据收到的上报信息,更新拓扑元数据。若mds在一段时间内未收到chunkserver心跳,会修改chunkserver的状态。
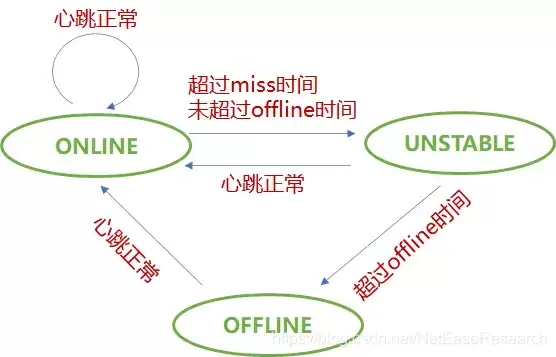
Online: chunk server在线,正常服务。
Unstable: chunk server一段时间没收到心跳(默认30s),但是还没有到达offline的时间(默认30min),chunkserver状态改为unstable状态,打印一条warning日志。
Offline:chunk server超过offline的时间没有收到心跳(默认30min), chunkserver状态改为offline,打印一条error日志。调度模块感知到offline状态,触发chunk server的recover修复。
namespace元数据信息
curve目前仅支持块存储,每个块设备在mds都有一个对应的文件。为了方便管理,curve还引入类似于文件系统那种层次结构。一个curve集群在curvefs中有且仅有一个根目录“/”,根目录在系统初始化的时候自动创建。目录可以嵌套,目录下可以存放子目录或者文件。
curve的namespace信息一方面保存着文件和目录的元数据信息,一方面还保存着文件和目录的层次关系。
无论是目录,还是文件,统一都用FileInfo表示,区别在于他们的类型不一样。
FileInfo的编码方式:
key:prefix(2Byte)+parentId(8Byte)+fileName;
Value:FileInfo序列化后的字符串。
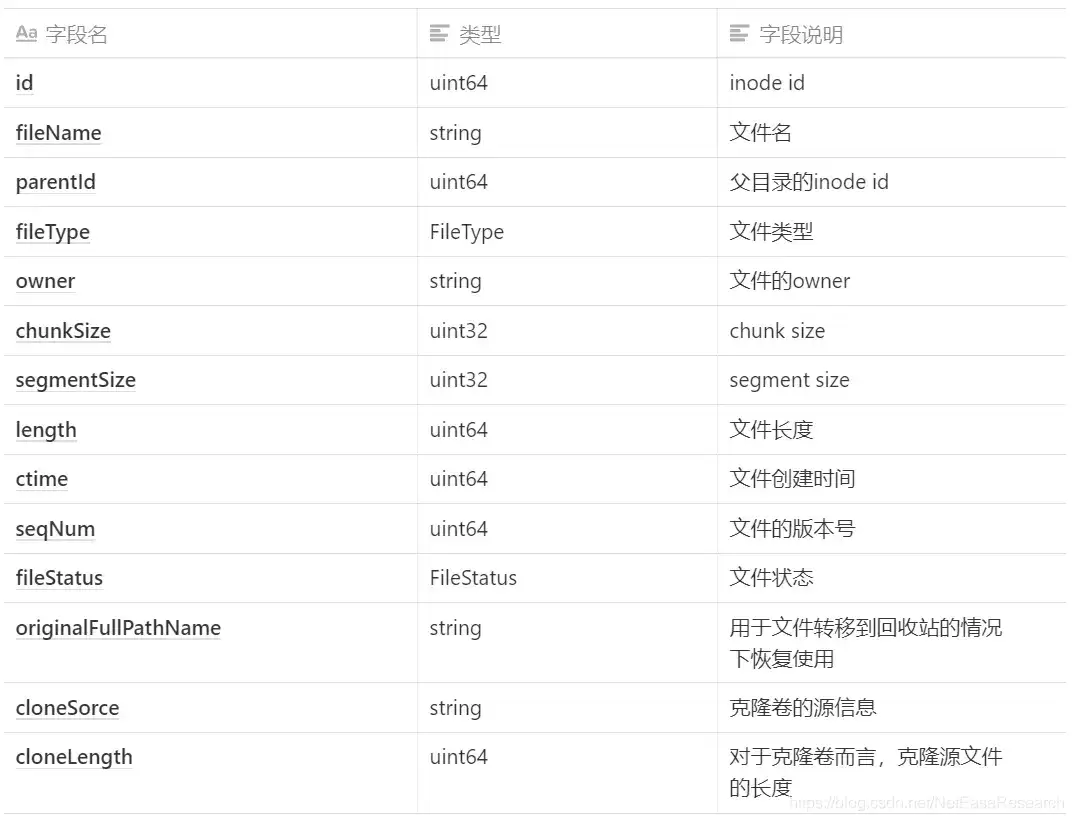
FileInfo的各个字段含义如下:
如下图所示的一个curvefs的目录层次结构,根目录下有目录home和文件tmp,home下有目录dir1,目录dir2,文件filez,dir1下有文件filex,dir2下有文件filey。
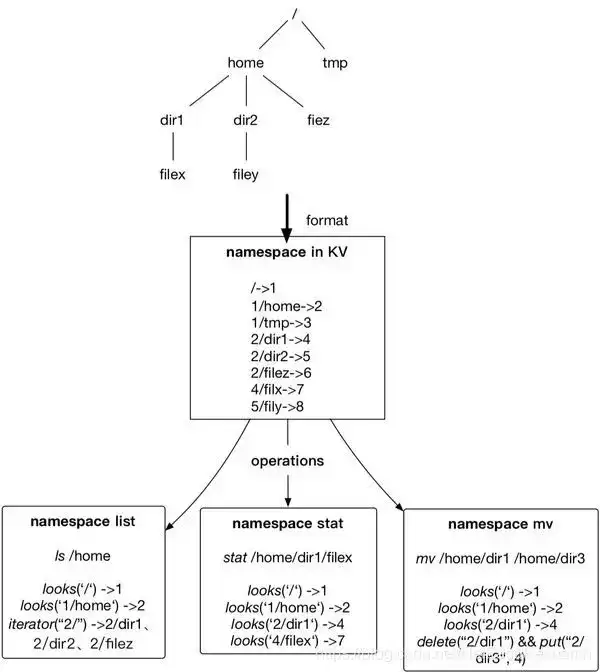
如上图所示。这些文件和目录经过编码,以kv的方式保存在etcd中。文件和目录的key的前缀都相同,这里省略了prefix,在KV中,Key是ParentID + "/"+ BaseName,Value是自身的文件ID;这种方式可以很好地平衡几个需求:
文件列目录:列出目录下的所有文件和目录
文件查找:查找一个具体的文件
目录重命名:对一个目录/文件进行重命名
curve的空间采用瘦分配(thin provisioning)的方式进行空间分配,也就是说卷在开始创建的时候,是没有实际分配空间的,仅仅是在元数据中记录了文件的长度和空间分配的粒度,真正的空间分配只有在地址第一次真正访问到的时候才会触发。
curve的底层按照chunk进行空间管理,但是chunk的切分粒度比较小,如果按照chunk进行分配,大量chunk分配会对元数据造成一定的压力,而且对性能也有影响。所有chunk的分配按照批量分配的原则,也就是一次性分配一批chunk。在chunk之上引入了一个segment的概念。Segment是⼀个逻辑概念,也是空间分配的基本单元。在curve中,一个curve文件会按照segment为粒度去进行空间分配。chunk外⾯包⼀层segment的好处是减少元数据量。
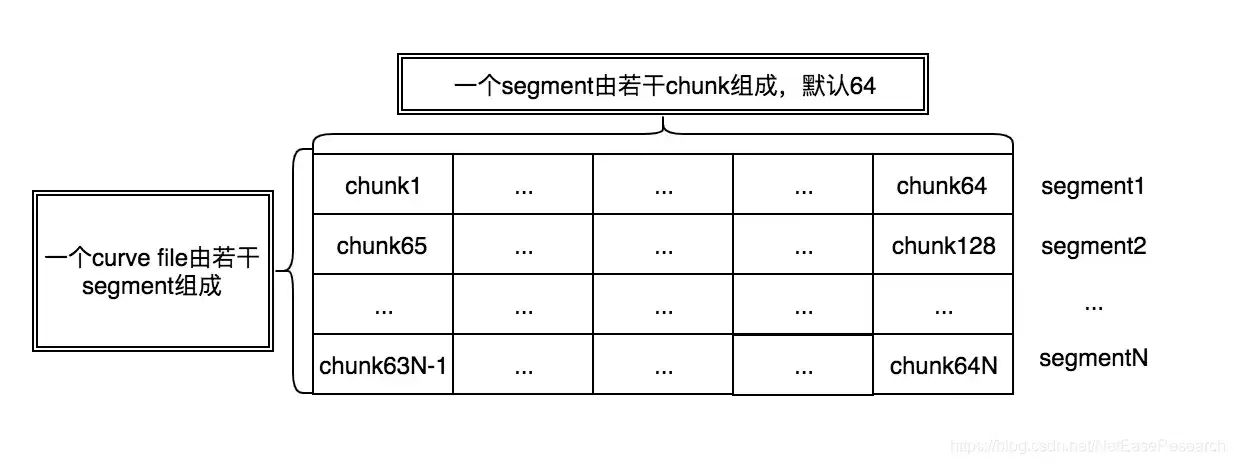
如下图所示,一个curve的文件由若干个segment组成,segment的大小由配置文件指定,目前curve默认segment的粒度为1GB,所以curve的文件大小必须是1GB的整数倍。一个segment由若干个chunk组成。
client在对空间进行读写请求之前,会先去mds查询指定offset和length的空间所在的segment的元数据信息。并把这个元数据信息缓存在client本地,以后client就可以使用缓存在本地的元数据信息对数据进行访问。segment元数据信息包含了以下的字段。
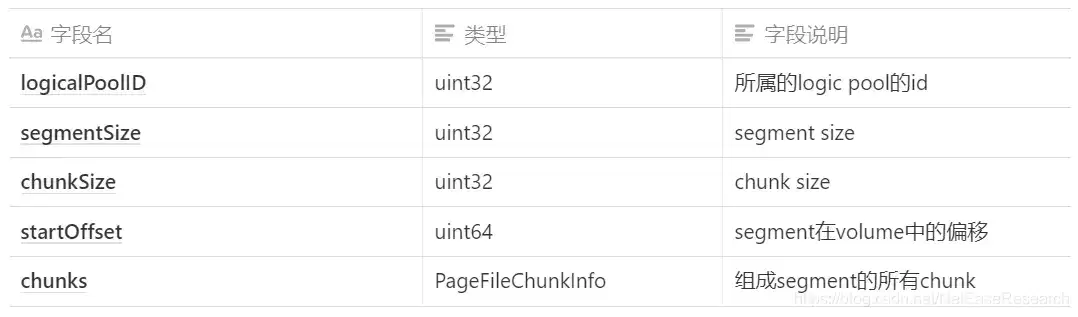
所有的文件在curve中都是由多个Segment组成的。每个segment的元数据记录着该segment是从哪个logicalpool分配出来,这个segment的size,组成这个segment的chunk的size,这个segment在文件中的偏移,以及这个组成这个segment的每一个chunk的信息。
Segment的持久化,Segment的编码方式:
key:prefix(2Byte)+文件的inodeid(8Byte)+offset(8Byte);
Value:PageFileSegment序列化后的字符串。
Segment是由多个chunk组成的,这里的chunk是实际的物理存储单元,对应着chunk server上的⼀个物理⽂件。chunk的元数据,包含了chunk所属的copyset id和chunkid。
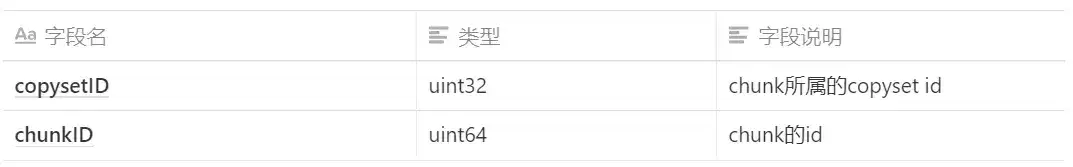
每个chunk实际上由多个副本的组成的,chunk的实际的存储位置,由copyset确定。copy保存着chunk的复制组的成员关系,在copyset中,记录着chunk的3个副本实际上分布在哪些chunkserver节点上。copyeset类似于ceph中的pg。为什么不直接记录chunk的3个副本,而是通过chunk→copyset,copyset→三个副本的方式存储元数据呢?
这里简要介绍下引入copyset的好处,后期curve团队还会对copyset进行更加详细的介绍。
减少元数据量:一般来说实际物理文件chunk不会设置的太大,都是M级别的。如果直接去记录这些chunk的信息,元数据量会很大。引入copyset可以认为就是分组,对于chunk的信息记录就是组信息+组内信息,数据量会少很多。如果为每个Chunk去保存复制组成员关系,需要至少 ChunkID+3×NodeID=20 个byte,而如果在Chunk到复制组之间引入一个CopySet,每个Chunk可以用ChunkID+CopySetID=12个byte。
减少复制组数量:要是一个数据节点里有256K个复制组,那复制组占用的内存资源可就相当可观了!而且复制组之间的通信也会变得异常复杂。比如说,复制组内的Primary会定期给Secondary发送心跳来进行探活,在有256K个复制组的情况下,心跳产生的流量会特别大。不过呢,引入CopySet的概念之后,就可以按照CopySet的粒度来进行探活、配置变更了,这样能大大降低开销。
提高数据可靠性:在数据复制组过度打散的情况下,在发生多个节点同时故障的情况下,数据的可靠性会受到影响。引入CopySet,可提高分布式存储系统中的数据持久性,降低数据丢失的概率。
至此,这篇文章分别从拓扑信息的元数据、namespace元数据、地址空间映射元数据三个方面,介绍了Curve的MDS的元数据的管理,介绍了拓扑信息的组成,元数据的持久化,空间的分配等。
更多CurveMDS技术解读,参考以下视频:
【视频】Curve核心组件之MDS元数据节点
更多Curve信息介绍请参考:
网易数帆存储负责人亲述:我眼中的Curve与Ceph
分布式存储开发:Curve中的内存管理
后续Curve团队还会陆续对Curve其他部分进行介绍,欢迎大家持续关注。
作者简介
陈威,网易数帆存储团队资深开发工程师,有多年存储阵列、分布式存储研发运维经验。
Curve项目已经完全开源到github:https://github.com/opencurve/curve,欢迎感兴趣的小伙伴去star&&fork。如对curve有疑问或者想参加curve的开发,欢迎给我们提issue或者pr。
Curve微信交流群,7*24h为大家答疑解惑,欢迎搜索微信号opencurve加好友后拉进群。
Curve系列技术课程,每周五晚19:00 B站直播,本周五主题为 Curve 快照克隆,敬请收看!








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。