


Django 6.1 RC1 实测:FETCH_PEERS 两条 SQL 解决 N+1,select_related 还需要吗?
Django 6.1 RC1 实测:FETCH_PEERS 两条 SQL 解决 N+1,select_related 还需要吗? Django 6.1 RC1 在 2026 年 7 月 22 日发布,正式版已进入最后的发布窗口。这个版本最值得后端开发者关注的变化之一,是 ORM 新增了 Fetch
Django 6.1 RC1 实测:FETCH_PEERS 两条 SQL 解决 N+1,select_related 还需要吗?
Django 6.1 RC1 在 2026 年 7 月 22 日发布,正式版已进入最后的发布窗口。这个版本最值得后端开发者关注的变化之一,是 ORM 新增了 Fetch Modes(字段获取模式)。
它试图解决一个老问题:代码运行时才访问关联字段,开发者又没有提前写 select_related() 或 prefetch_related(),于是一次列表查询悄悄膨胀成 N+1 条 SQL。
这篇文章不只介绍 API。我在隔离环境中安装了 Django 6.1 RC1,用 100 本书和 100 位作者做了一次可复现实验,直接比较:
- 默认的
FETCH_ONE; - 新增的
FETCH_PEERS; - 传统的
select_related(); - 用来阻止意外查询的
RAISE。
先给结论:FETCH_PEERS 很有价值,但它不是 select_related() 的替代品。
N+1 为什么总在代码评审后才暴露
假设每本书都关联一位作者:
 复制代码class Author(models.Model):
    name = models.CharField(max_length=100)
class Book(models.Model):
    title = models.CharField(max_length=200)
    author = models.ForeignKey(Author, on_delete=models.CASCADE)
下面的代码看起来非常自然:
 复制代码books = Book.objects.all()for book in books:
    print(book.author.name)
第一条 SQL 查询 100 本书。之后,每次访问 book.author,Django 都需要再查询一次作者,于是总数变成:
复制代码1 条 Book 查询 + 100 条 Author 查询 = 101 条 SQL
传统修复方式是提前声明关联字段:
复制代码books = Book.objects.select_related("author")
它会使用 JOIN,一条 SQL 就把书和作者一起取回。问题在于,真实系统中的字段访问经常由序列化器、模板、插件或运行时分支决定,写查询的人未必知道后面会访问哪个字段。
这正是 FETCH_PEERS 想补上的空白。
Django 6.1 的三种 Fetch Mode
FETCH_ONE:保持原来的行为
复制代码from django.db import modelsbooks = Book.objects.fetch_mode(models.FETCH_ONE)
当一个未加载字段被访问时,只为当前对象取一次数据。这是 Django 过去的行为,也是 Django 6.1 的默认模式。
优点是行为稳定、单次访问成本明确;缺点是放进循环后很容易形成 N+1。
FETCH_PEERS:第一次访问时批量补齐同批对象
 复制代码books = Book.objects.fetch_mode(models.FETCH_PEERS)for book in books:
    print(book.author.name)
第一次访问某一本书的 author 时,Django 会找到来自同一个 QuerySet 的其他 Book 实例,并批量获取它们需要的关联作者。最终查询形态通常是:
- 查询全部 Book;
- 批量查询这些 Book 对应的 Author。
它很像“按需触发的 prefetch_related()”:只有代码真正访问关联字段时,第二条查询才发生。
RAISE:不允许代码偷偷访问数据库
 复制代码books = Book.objects.fetch_mode(models.RAISE)for book in books:
    print(book.author.name)
一旦 author 未能提前加载,Django 便不再默默执行查询,而是直接抛出 FieldFetchBlocked 异常。这一机制在性能敏感场景、模板渲染及 API 序列化测试中显得尤为关键:它让意外产生的 SQL 无法再悄无声息地溜过,而是立刻报错,从而确保代码行为的确定性。
100 本书的真实查询结果
测试环境如下:
| 项目 | 配置 |
|---|---|
| Django | 6.1 RC1 |
| Python | 3.12 |
| 数据库 | SQLite 内存数据库 |
| 数据量 | 100 Author + 100 Book |
| 关系 | 每本书关联一位作者 |
| 计数方法 | connection.queries |
核心测试函数只有几行:
 复制代码def measure(label, queryset):
    connection.queries_log.clear()
    started = perf_counter()
    books = list(queryset)
    names = [book.author.name for book in books]
    elapsed_ms = (perf_counter() - started) * 1000
    print(label, len(connection.queries), elapsed_ms)
四种模式依次运行:
 复制代码measure("FETCH_ONE", Book.objects.fetch_mode(models.FETCH_ONE))
measure("FETCH_PEERS", Book.objects.fetch_mode(models.FETCH_PEERS))
measure("select_related", Book.objects.select_related("author"))blocked = list(Book.objects.fetch_mode(models.RAISE))
print(blocked[0].author.name)  # FieldFetchBlocked
本机单次结果如下:
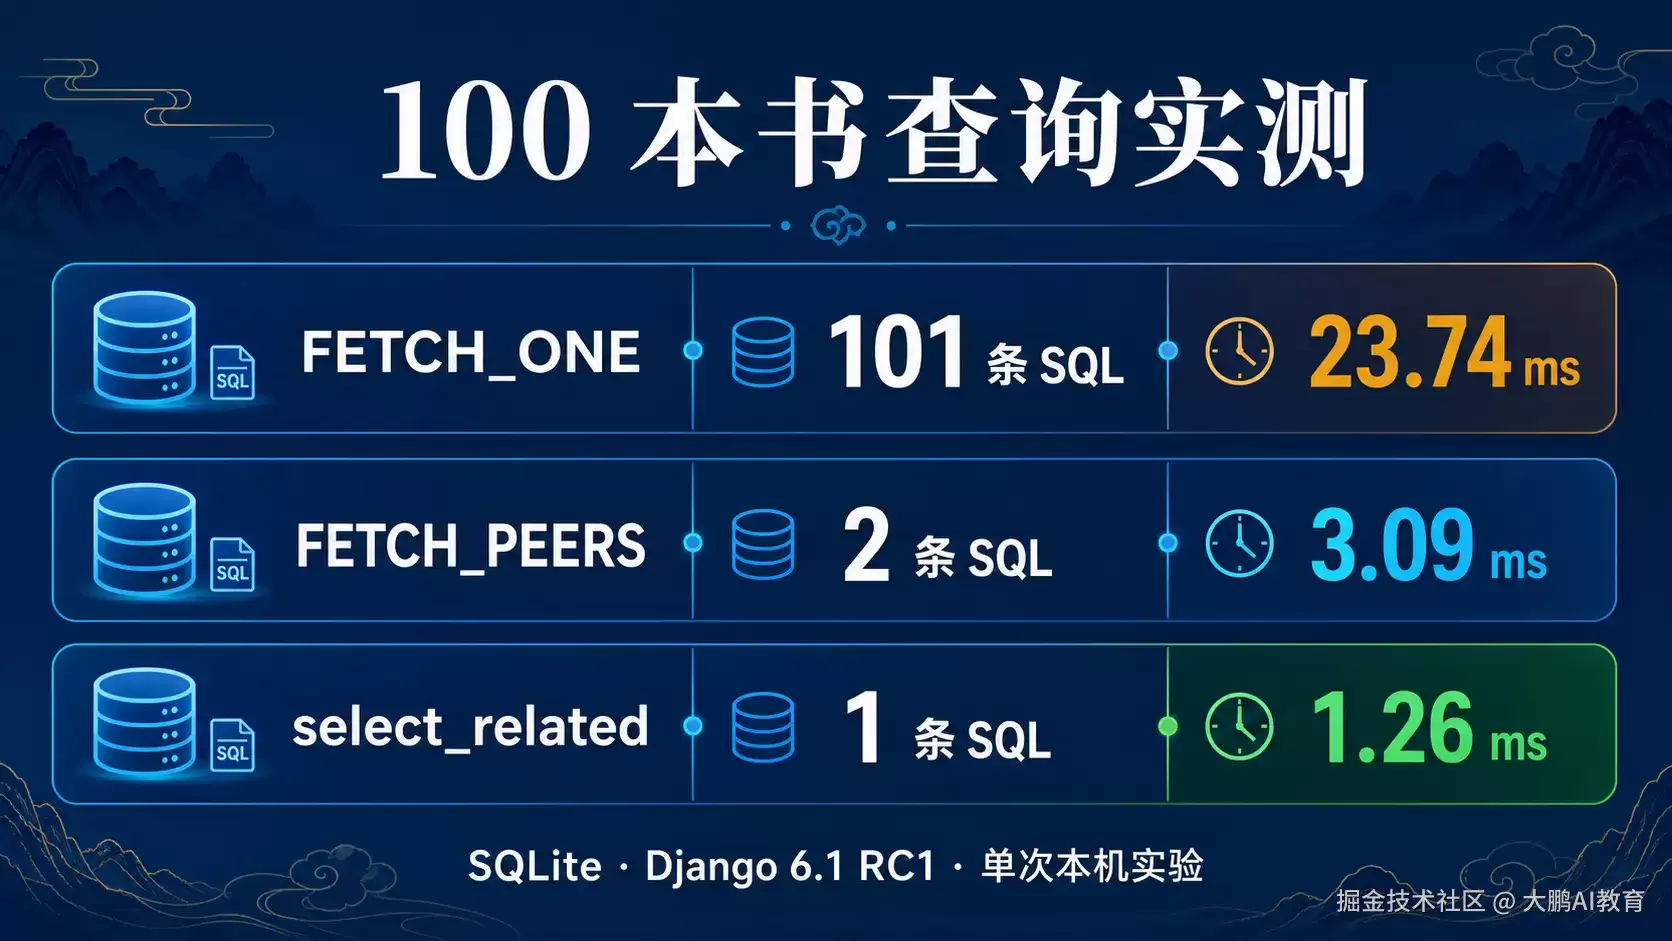
| 策略 | SQL 数量 | 单次耗时 |
|---|---|---|
FETCH_ONE | 101 | 23.74 ms |
FETCH_PEERS | 2 | 3.09 ms |
select_related | 1 | 1.26 ms |
RAISE | 阻止查询 | 抛出 FieldFetchBlocked |
这组数据更适合用来说明查询形态,本身并不能直接当作通用性能排行榜来看。原因很简单:SQLite 的内存数据库、数据规模、字段宽度、网络延迟,甚至数据库执行计划,都会把最终耗时拉向不同结果。真正更稳、更有参考价值的结论,其实是 SQL 的数量变化——在这个关系访问场景里,FETCH_PEERS 直接把 101 条 SQL 压缩到了 2 条。
select_related 还需要吗?当然需要
如果业务代码明确知道“这次一定会访问作者”,select_related("author") 仍然是最直接的表达:
复制代码books = Book.objects.select_related("author")
它的优势有三个:
- 查询意图在代码中清晰可见;
- 只执行一次 JOIN;
- 不需要等到第一次属性访问时才触发第二条 SQL。
FETCH_PEERS 更适合访问路径不确定的场景。例如:
- 同一个 QuerySet 被多个序列化器复用;
- 模板根据权限决定是否展示关联字段;
- 插件或扩展在运行时访问模型属性;
- 希望减少 N+1,又不想为每条动态路径维护预取字段列表。
换句话说,select_related() 是“我明确知道会用什么”;FETCH_PEERS 是“我运行到这里才知道需要什么,但请不要逐条查询”。
一张图完成策略选择
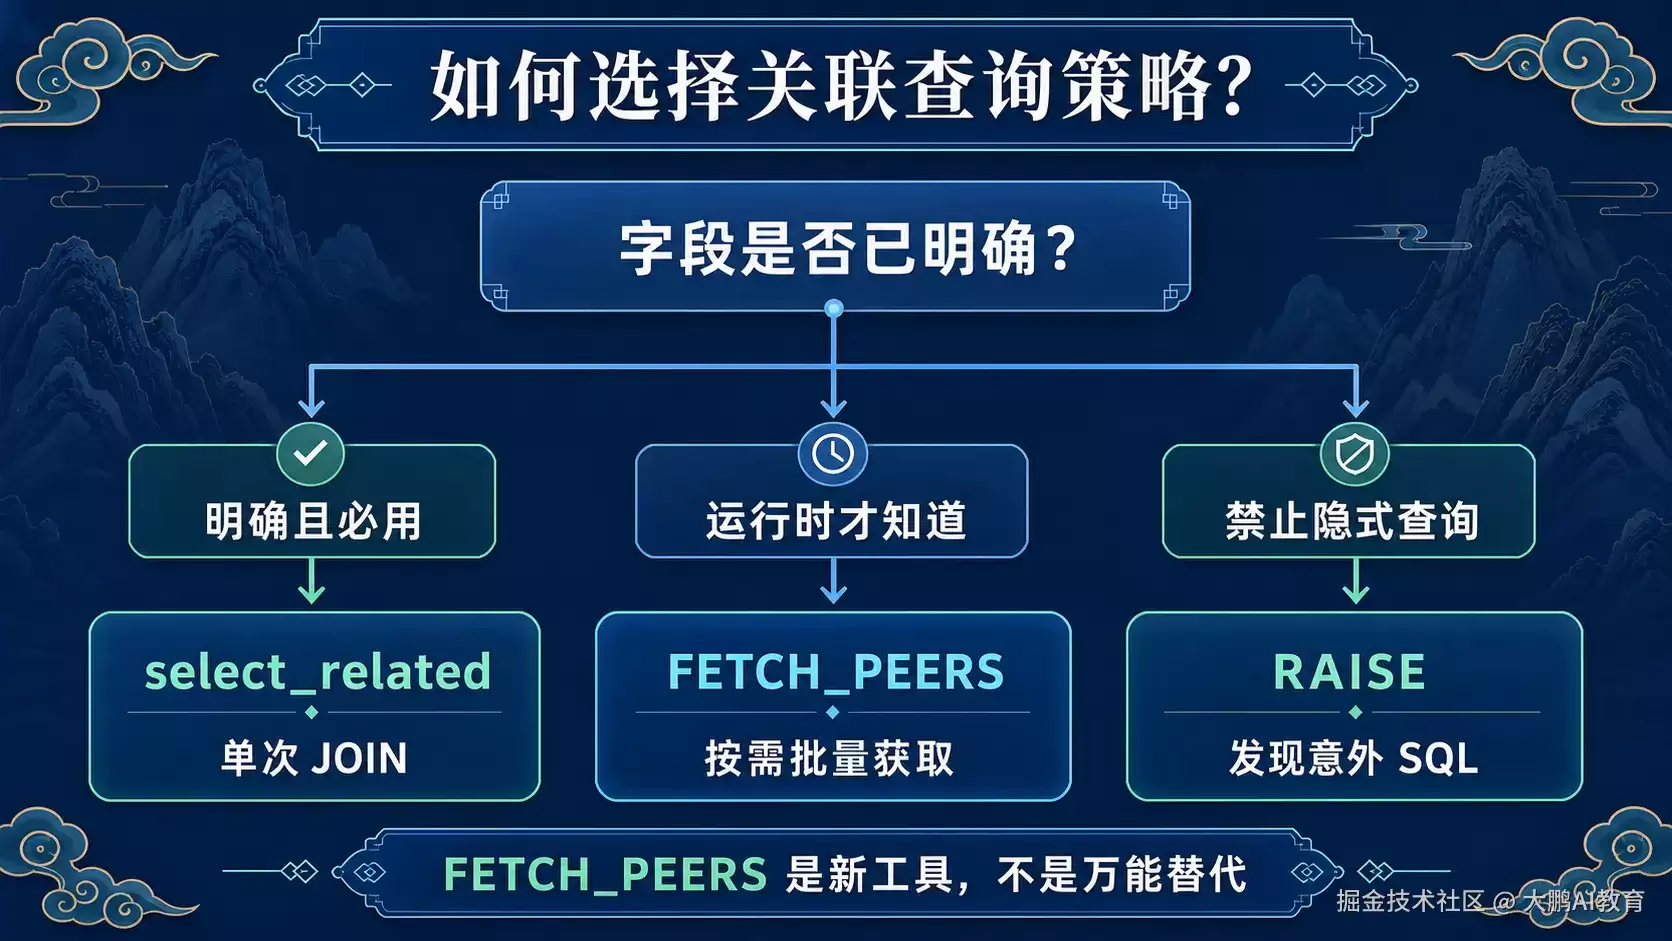
可以把选型压缩成三条规则:
规则一:字段明确且必用,优先 select_related
对于 ForeignKey 和 OneToOneField,如果调用链明确,JOIN 通常更直接。
规则二:访问由运行时决定,考虑 FETCH_PEERS
它能在真正访问字段时批量补齐同一 QuerySet 的对象,避免逐条获取。
规则三:性能边界必须严格,使用 RAISE
把隐式查询变成测试失败,尤其适合高吞吐 API、循环和模板渲染边界。
FETCH_PEERS 的边界不能忽略
第一,它只影响未加载字段和关联对象的获取行为,不会让任意 ORM 查询自动变快。
第二,它不是数据库缓存。第二条批量查询仍然真实发生,只是从 N 条缩减为一条。
第三,模式会沿着获取到的关联对象继续传播。复杂关系树中应观察真实 SQL,而不是凭感觉判断。
第四,Django 6.1 RC1 仍是预发布版本。正式版发布前,API 与边界行为仍应以最终文档和发布说明为准,生产环境不要因为一篇基准文章直接升级。
升级前的验证清单
- 在隔离环境安装 Django 6.1 RC1,不直接修改生产依赖;
- 为关键列表接口记录 SQL 数量基线;
- 对已知字段继续使用
select_related()/prefetch_related(); - 在动态访问路径试用
FETCH_PEERS; - 在不允许隐式查询的测试中启用
RAISE; - 同时比较 SQL 数量、返回数据量和数据库执行计划;
- 检查第三方包是否支持 Django 6.1;
- 正式升级前重新阅读最终版 6.1 发布说明。
结论:FETCH_PEERS 是新工具,不是万能替代
Django 6.1 没有宣布 select_related() 过时。它新增的是一套更细的控制手段:
FETCH_ONE保留兼容行为;FETCH_PEERS在运行时批量补齐同批对象;RAISE把意外 SQL 变成明确错误;select_related()继续负责已知关系的主动 JOIN。
真正值得升级的不是“少写一个 select_related”,而是 ORM 第一次允许我们明确表达:缺失字段应该单独取、成批取,还是根本不许取。
如果你的项目中既有 DRF 序列化器又有复杂模板,你更希望先在哪一层尝试 FETCH_PEERS?
参考资料
- Django 6.1 RC1 发布公告
- Django 6.1 Fetch Modes 官方文档
- Django 6.1 发布说明













火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。