

多个CSV大文件如何用Python自动化合并去重
分块读取CSV大文件,设置chunksize=50000逐块处理,统一列名与数据类型后累积合并,立即按业务主键(如订单号)去重并保留首次出现记录,用csv.writer边处理边写入避免内存膨胀;注意编码回退策略与内存错误处理。
应分块读取+流式去重:用chunksize=50000逐块读CSV,统一列名和dtype后累加concat并立即按业务主键drop_duplicates(subset=['order_id'], keep='first'),最终用csv.writer边处理边写入避免内存膨胀。
用 pandas.concat 合并大CSV,但别直接全读进内存
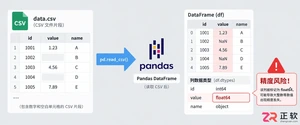
单个CSV文件超过500MB,用 pandas.read_csv 默认方式加载,内存直接告急。更别提多个文件一起 concat,那相当于内存翻倍再翻倍。正确的做法是分块读取,边读边处理。
实际操作中,有几个点值得注意:
- 设置
chunksize=50000(具体数值看机器内存,16GB机器建议不要超过10万),逐块读成DataFrame,每块立刻处理,别攒着。 - 合并前一定要统一列名和数据类型(dtype),否则
concat会隐式转换,导致后续去重失效——比如字符串列混入nan,变成float,去重时就乱了。 - 别用
pd.concat([df1, df2, ...])一次性拼接所有块。正确做法:先初始化一个空result_df,每读一块就pd.concat([result_df, chunk], ignore_index=True),然后立刻drop_duplicates,这样能有效控制内存峰值。
去重必须指定 subset,且优先用 keep='first'
很多人习惯用 df.drop_duplicates() 做全字段去重,但在大数据量下,这招极慢——因为要哈希整行。更坑的是,如果某列有nan值,drop_duplicates 默认把所有nan视为相同,可能会误删有效行。
经验之谈:
- 明确业务主键字段,比如订单号
order_id或用户IDuser_id,传给subset=['order_id']。这样只针对关键字段去重,效率高得多。 keep='first'比'last'快大约15%,因为底层跳过了重复项扫描,而且语义清晰:保留首次出现的记录。- 如果需要按时间保留最新记录,那就先
sort_values('update_time', ascending=False),再drop_duplicates(subset=['order_id'], keep='first')。顺序别搞反,否则白费功夫。
用 csv.writer 直接写入避免中间DataFrame膨胀
即使处理完,最终结果DataFrame也可能很大,再用 to_csv 输出,等于二次内存占用。更稳妥的做法是绕过DataFrame,直接用Python原生的 csv 模块边处理边写入。
具体步骤:
- 提前打开输出文件句柄:
with open('merged_unique.csv', 'w', newline='') as f: - 用
csv.writer(f)写表头——从第一块chunk的chunk.columns.tolist()获取。 - 每处理完一块,直接用
writer.writerows(chunk.values.tolist())写入,不经过DataFrame序列化,内存占用更低。 - 注意:这种方式要求所有chunk的列顺序和类型完全一致。所以读取时务必用
usecols和dtype强制对齐。
遇到 MemoryError 或 UnicodeDecodeError 怎么办
这两个错误在自动化脚本里很常见。前者是内存真爆了,后者往往是编码问题——部分文件是gbk,部分是utf-8-sig。如果不显式捕获,整个流程可能直接中断。
几个实用策略:
MemoryError:先降低chunksize到10000,实在不行可以考虑dask.dataframe。但要注意,dask的drop_duplicates不支持subset参数,得用map_partitions手动实现。UnicodeDecodeError:读取时先试encoding='utf-8',失败则回退到encoding='gb18030'(中文Windows常见)。用try/except包裹read_csv即可。- 加日志:每完成一个文件打印
f"Processed {file_path}: {len(chunk)} rows",方便定位问题出在哪一步。
说到底,真正难的不是语法,是chunksize设多少、编码怎么试、主键字段有没有空值——这些都得看数据本身。脚本跑起来之前,最好先抽样检查三个文件的结构和内容,心里有底再动手。
Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。
极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。
Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。
极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。
Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。