


千问如何做细粒度的情感分析区分多种情绪类别
千问通过结合CNN与RNN的深度学习模型,利用海量精细标注的多领域训练数据,从语义、句法、语境等多维度提取特征,并持续优化,从而实现精准区分喜悦、愤怒等细粒度情绪类别。
在数字化浪潮席卷各行各业的今天,情感分析技术早已不再是实验室里的新鲜名词,而是逐渐成为理解文本背后真实情绪的关键工具。不过,真正能做到“细粒度”分析,精准区分出喜悦、愤怒、悲伤、惊讶等不同情绪层次,却并非易事。千问在这方面倒是展现出了独特的能力。
那么,千问究竟是如何做到这一点的?背后到底藏着哪些技术秘密?
先进的算法模型
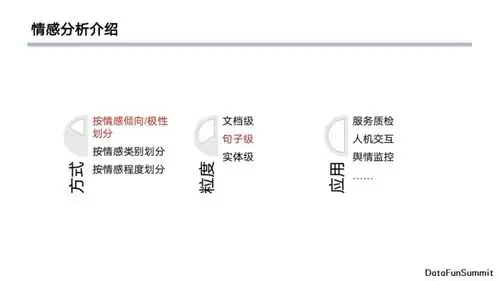
简单来说,千问将深度学习中的多种前沿算法串联了起来。你猜怎么着,关键就在于它把卷积神经网络(CNN)和循环神经网络(RNN)巧妙地结合在了一起。CNN主要负责从文本中抓取关键词汇和短语的特征,像给文字拍了一张快照;而RNN,尤其是它的变体长短期记忆网络(LSTM)和门控循环单元(GRU),则擅长处理文本的序列性——说白了,就是能理解“前因后果”,把上下文关系梳理得明明白白。当这两种算法协同作战时,一个高效、精准的情感分析模型就诞生了。
丰富的训练数据
算法再强,没有“货”也是白搭。千问之所以能实现细粒度分析,一个核心根基在于它背后海量的、经过精细标注的训练数据。这些数据覆盖面极广,从社交媒体上用户吐槽的“毒舌”评论,到新闻报道里字里行间的情感倾向,再到文学作品里人物细腻的心理描写,以及产品评价中用户真实的满意度反馈,几乎无所不包。更重要的是,它们不是粗略地贴个“正面”或“负面”标签,而是针对每一种情绪都做了细致入微的标注。正是靠着这种“喂”出来的经验,模型才能精准地识别出不同情绪在文本中的具体表达方式。
多维度特征提取
光看词汇本身,远远不够。千问在这一点上做得相当聪明,它会从多个维度去“扒”文本的底。在语义层面,它会分析词汇之间的勾连关系,真正理解句子想表达的实际意思;在句法层面,它通过解析句子结构,抓住语法规则和成分关系,从而更准确地判断情感的落脚点。此外,它还会把文本的语境信息纳入考量,比如一段关于医疗领域的表述,其中“积极”可能意味着病情好转,而在消费领域,同样的词则可能指向产品满意度。这种多维度的特征提取,让千问的分析能力比单纯“看词断义”要全面得多。
持续优化与改进
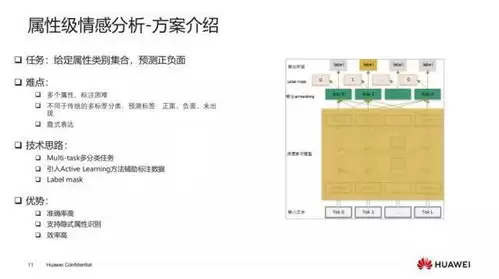
技术没有终点。千问的研发团队一直在持续跟踪新出现的文本类型和情感表达形式,比如网络流行语、夸张的修辞手法等,并且根据实际应用中的反馈,不断调整模型参数和训练数据。这种持续优化的机制,确保了千问能始终站在细粒度情感分析领域的前沿。无论是企业需要做市场调研、舆情监控,还是个人想深入理解一篇文章背后的情绪脉络,都可以借助千问的能力,更清晰地洞察文本中那些丰富而微妙的情感世界。







Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Xcode 是苹果面向 Mac 提供的官方集成开发环境,将代码编辑、项目构建、SwiftUI 实时预览、设备模拟、自动化测试、断点调试、性能分析和应用分发整合在同一套工作流中,适合开发与维护 iPhone、iPad、Mac、Apple Wa

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

PhpStorm 是 JetBrains 推出的专业 PHP 集成开发环境,可在 Mac 上完成代码编写、智能检查、重构、调试、测试和数据库管理。它支持主流 PHP 框架、Composer、Git、Docker 与远程解释器。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

Visual Studio Code 是微软提供的免费代码编辑器,支持 macOS,并为 Intel 与 Apple 芯片 Mac 提供适配版本。软件集代码编辑、调试、Git 源代码管理、集成终端和扩展市场于一体。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

Adobe Audition 是面向播客、影视后期、音乐制作及内容创作者的专业音频工作站,提供波形精修、多轨录制与混音、频谱编辑、降噪修复、响度匹配和效果处理工具,并可与 Adobe Premiere 协同完成视频声音制作。

Pro Tools 是 Avid 推出的专业数字音频工作站,覆盖多轨录音、无损剪辑、MIDI 编曲、插件处理、自动化混音及声音与画面同步等工作。它拥有 Intro、Artist、Studio 和 Ultimate 等方案。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,

WebStorm 是 JetBrains 面向 JavaScript、TypeScript 和现代 Web 技术打造的集成开发环境。它提供项目级代码分析、智能补全、安全重构、导航搜索,并集成调试、测试、终端、Git 与常用前端工具,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

Visual Studio Code 是微软推出的免费代码编辑器,Windows 版集成智能补全、代码导航、调试、终端和版本控制,并可通过扩展添加语言、格式化及远程开发能力。它启动较快、配置灵活,

REAPER 是 Cockos 推出的数字音频工作站,适用于录音、MIDI 编曲、音频编辑、混音、母带制作及声音设计。软件安装包小巧,支持多轨录制、灵活路由、自动化、第三方插件和脚本扩展,并提供完整功能的 60 天免费评估期。

Adobe Audition 是面向播客、影视后期、广播与音乐制作的专业音频工作站,提供波形编辑、多轨混音、频谱分析、录音、降噪修复和效果处理等功能。Windows 版通过 Adobe Creative Cloud 安装和管理,

Pro Tools 是 Avid 推出的专业数字音频工作站,提供多轨录音、音频剪辑、MIDI编曲、插件处理、自动化混音及影视声音制作能力。它适合音乐人、录音师、制作人和音频后期团队使用,并提供免费入门版、订阅方案及永久授权选择。