


ICLR'24无监督学习车道分段的创新方法:LaneSegNet
写在前面&笔者的个人理解地图作为自动驾驶系统下游应用的关键信息,通常以车道或中心线表示。然而,现有的地图学习文献主要集中在检测基于几何的车道或感知中心线的拓扑关系。这两种方法都忽略了车道线与中心线的内在关系,即车道线绑定中心线。虽然在一个模型中简单地预测两种类型的车道在学习目标中是互斥的,但本文提出将lanesegment作为一种无缝结合几何和拓扑信息的新表示,因此提出了LaneSegNet。这是第一个生成lanesegment以获得道路结构完整表示的端到端建图网络。LaneSegNet有两个关键
写在前面&笔者的个人理解
地图作为自动驾驶系统下游应用的关键信息,通常以车道或中心线表示。然而,现有的地图学习文献主要集中在检测基于几何的车道或感知中心线的拓扑关系。这两种方法都忽略了车道线与中心线的内在关系,即车道线绑定中心线。虽然在一个模型中简单地预测两种类型的车道在学习目标中是互斥的,但本文提出将lane segment作为一种无缝结合几何和拓扑信息的新表示,因此提出了LaneSegNet。这是第一个生成lane segment以获得道路结构完整表示的端到端建图网络。LaneSegNet有两个关键的修改,一个是车道注意力模块,用于捕捉长距离特征空间内的关键区域细节。另一个是参考点的相同初始化策略,它增强了车道注意力的位置先验的学习。在OpenLane-V2数据集上,LaneSegNet在三项任务上都比以前的同类产品有显著的优势,即地图元素检测(+4.8 mAP)、车道中心线感知(+6.9 DETl)和新定义的lane segment感知(+5.6 mAP)。此外,它还获得了14.7FPS的实时推理速度。
开源链接:https://github.com/OpenDriveLab/LaneSegNet
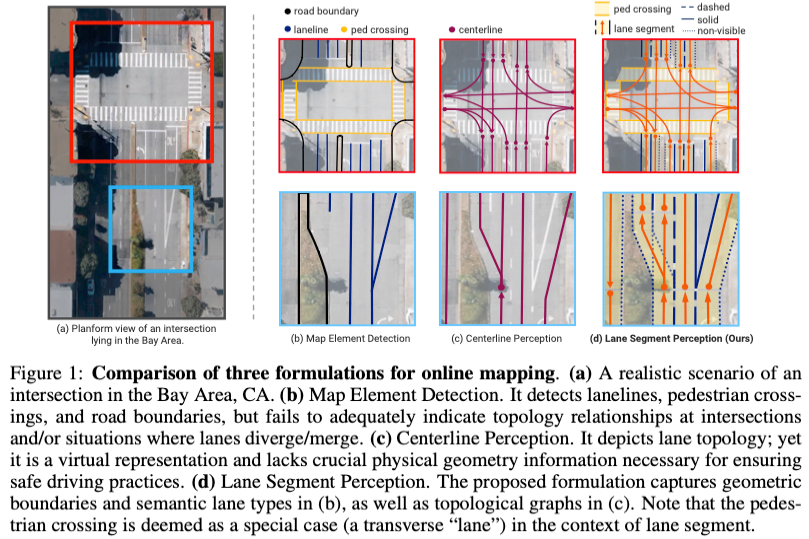
总结来说,本文的主要贡献如下:
- 本文引入了全新的lane segment感知作为一种新的地图学习公式。它包含了几何和拓扑要素。我们希望它能给领域带来新的见解。
- 本文提出了LaneSegNet,这是一种为lane segment感知而提出的端到端网络。已经提出了两种新的修改,包括具有heads-to-regions机制的车道注意力模块,用于捕获长距离注意力,以及用于参考点的相同初始化策略,以增强车道注意力的位置先验学习。
相关工作回顾
中心线感知:来自车载传感器数据的中心线感知(与本文中的车道图学习相同)最近引起了极大的关注。STSU提出了一种类似DETR的网络来检测中心线,然后是多层感知器(MLP)模块来确定它们的连接性。在STSU的基础上,Can等人引入了额外的最小循环查询,以确保重叠行的正确顺序。CenterLineDet将中心线视为顶点,设计了通过模仿学习训练的图更新模型。值得注意的是,特斯拉提出了“车道语言”的概念,将车道图表示为一个句子。他们基于注意力的模型递归地预测车道标记及其连通性。除了这些分段方法外,LaneGAP还引入了一种使用额外转换算法恢复车道图的路径方法。TopoNet针对完整多样的驾驶场景图,对网络内中心线的连通性进行了显式建模,并将交通元素纳入任务中。在这项工作中,我们采用segment方法来构建车道图。然而,我们在建模Lane Segment而不是将中心线作为车道图的顶点方面与以往的方法不同,这允许方便地集成段级几何和语义信息。
地图元素检测:在先前的工作中,人们关注将地图元素检测从相机平面提升到3D空间,以克服投影误差。随着BEV感知的流行趋势,最近的工作专注于使用分割和矢量化方法学习高清地图。地图分割预测每个纯BEV网格的语义,如车道、人行横道和可驾驶区域。这些工作主要在透视图(PV)到BEV转换模块方面有所区别。然而,分割的地图不能提供下游模块所使用的直接信息。HDMapNet通过对具有复杂后处理的分割地图进行分组和矢量化来处理该问题。
尽管密集分割提供了像素级的信息,但它仍然无法触及重叠元素的复杂关系。VectorMapNet提出将每个地图元素直接表示为点序列,使用粗略的关键点来顺序解码车道位置。MapTR探索了一种统一的基于排列的点序列建模方法,以消除建模歧义,提高性能和效率。PivotNet进一步在集合预测框架中使用基于枢轴的表示对地图元素进行建模,以减少冗余并提高准确性。StreamMapNet利用多点注意力和时间信息来提高远程地图元素检测的稳定性。事实上,由于矢量化也丰富了车道的方向信息,因此基于矢量化的方法可以通过交替监督来容易地适应中心线感知。在这项工作中,我们为道路上的所有高清地图元素提出了一种统一的、便于学习的表示方式——车道分段。
详解LaneSegNet
车道分段感知任务描述
Lane Segment的实例包含道路的几何和语义方面。至于几何,它可以表示为由矢量化的中心线及其相应的车道边界组成的线段:。每条线都被定义为3D空间中个点的有序集合。此外,几何体也可以被描述为定义该车道内的可驾驶区域的闭合多边形。
在语义方面,它包括Lane Segment类别C(例如,Lane Segment、行人交叉)和左/右车道边界的线型(例如,不可见、实心、虚线):{}。这些细节为自动驾驶汽车提供了关于减速要求和变道可行性的重要见解。
此外,拓扑信息在路径规划中起着至关重要的作用。为了表示这一信息,为Lane Segment构建了一个车道图,表示为G=(V,E)。每个Lane Segment都是该图中的一个节点,由集合V表示,而集合E中的边描述了Lane Segment之间的连通性。我们使用邻接矩阵来存储该车道图,其中只有当第j个Lane Segment跟随第i个Lane Segment时,矩阵元素(i,j)才设置为1;否则,它保持为0。
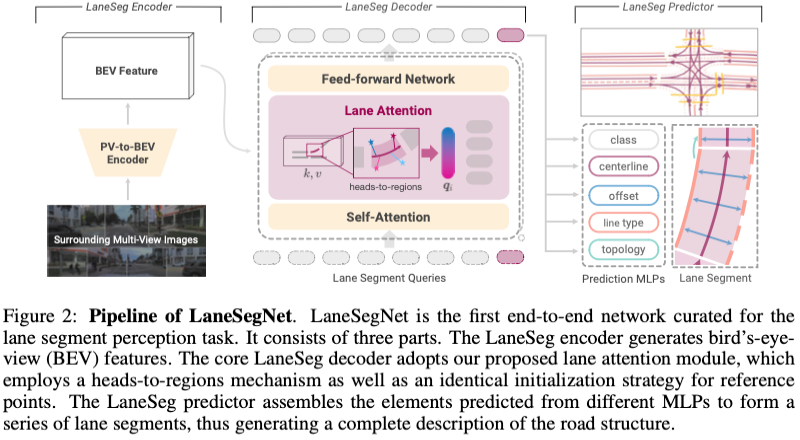
LaneSegNet框架
LaneSegNet的整体框架如图2所示。LaneSegNet将环视图像作为输入,以感知特定BEV范围内的Lane Segment。在本节中,我们首先简要介绍用于生成BEV特征的LaneSeg编码器。然后,我们介绍了车道分段解码器和车道注意力。最后,我们提出了车道分段预测器以及训练损失。
LaneSeg Encoder
编码器将环视图像转换为BEV特征,用于Lane Segment提取。我们利用标准的ResNet-50主干从原始图像中导出特征图。随后使用BEVFormer的PV到BEV编码器模块被用于视图转换。
LaneSeg Decoder
基于Transformer的检测方法利用解码器从BEV特征中收集特征,并通过多层更新解码器查询。每个解码器层利用自注意力、交叉注意力机制和前馈网络来更新查询。此外,还采用了可学习的位置查询。更新后的查询随后被输出并被馈送到下一阶段。
由于复杂且细长的地图几何形状,收集长距离BEV特征对于在线地图任务至关重要。先前的工作利用分层(实例点)解码器查询和可变形注意力来提取每个点查询的局部特征。虽然这种方法避免了捕获长距离信息,但由于查询数量的增加,随之而来的是高昂的计算成本。
Lane Segment作为构建场景图的车道实例表示,在实例层面上具有优越的特性。我们的目标不是使用多点查询,而是采用单个实例查询来表示Lane Segment。因此,核心挑战在于如何使用单个实例查询来交叉关注全局BEV特性。
Lane Attention:在目标检测中,可变形注意力利用目标的位置先验,只关注目标参考点附近的一小部分注意力值作为预滤波器,大大加速了收敛。在层迭代期间,参考点被放置在预测目标的中心,以细化注意力值的采样位置,注意力值通过可学习的采样偏移分散在参考点周围。采样偏移的有意初始化包含了二维目标之前的几何体。通过这样做,多分支机制可以很好地捕捉每个方向的特征,如图3a所示。
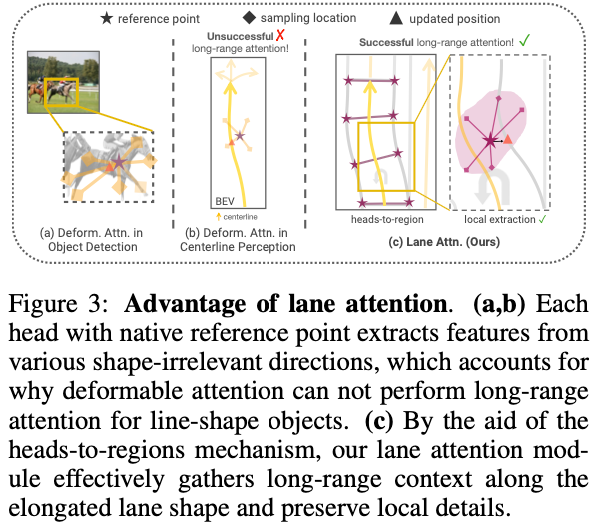
在地图学习的背景下,李等人使用朴素的可变形注意力来预测中心线。然而如图3b所示,由于参考点的朴素放置,它可能无法获得lone range注意力。此外,由于目标的细长形状和复杂的视觉线索(例如,精确预测实线和虚线之间的断点),这一过程需要为我们的任务进行额外的自适应设计。考虑到所有这些特征,网络有必要拥有不仅关注长范围上下文信息,而且准确提取局部细节的能力。因此,建议将采样位置分布在大的区域中,以有效地感知长距离信息。另一方面,局部细节应易于区分,以识别关键点。值得注意的是,虽然在单个注意力头内的value特征之间是竞争关系,但不同头部之间的value特征可以在Attention过程中保留。因此,明确利用这一属性来促进对特定区域局部特征的关注是有希望的。
为此,本文提出建立一个heads-to-regions机制。我们首先在Lane Segment区域内均匀分布多个参考点。然后围绕局部区域中的每个参考点对采样位置进行初始化。为了保留复杂的局部细节,我们使用了多分支机制,其中每个头都关注局部区域内的一组特定采样位置,如图3c所示。
现在提供车道注意力模块的数学描述。给定BEV特征,第i个Lane Segment查询特征qi和一组参考点pi作为输入,车道注意力计算如下:
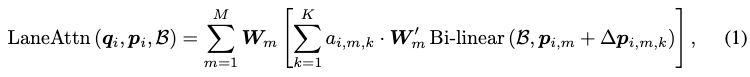
参考点的相同初始化:参考点的位置是车道注意力模块功能的决定因素。为了使每个实例查询的关注区域与其实际几何结构和位置对齐,基于前一层的Lane Segment预测来分布每个实例查询中的参考点p,如图3c所示。并迭代细化预测。
先前的工作认为,提供给第一层的参考点应该用从位置查询嵌入推导出的可学习先验来单独初始化。然而,由于位置查询与输入图像无关,因此这种初始化方法可能会反过来限制模型记忆几何先验和位置先验的能力,并且错误生成的初始化位置也会对训练构成障碍。
因此,对于Lane Segment解码器的第一层,我们提出了相同的初始化策略。在第一层中,每个头部采用由位置查询生成的相同参考点。与传统方法中的参考点分布式初始化(即为每个查询初始化多个参考点)相比,相同的初始化将通过过滤掉复杂几何形状的干扰,使位置先验的学习更加稳定。需要注意的是,相同的初始化似乎是反直觉的,但被观察到是有效的。
LaneSeg Predictor
我们在多个预测分支中使用MLP,从Lane Segment查询中生成最终预测的Lane Segment,同时考虑几何、语义和拓扑方面。
对于几何,我们首先设计了一个中心线回归分支来回归中心线在三维坐标中的矢量化点位置。输出的格式为。由于左右车道边界的对称性,我们引入了一个偏移分支来预测偏移,其格式为。因此,可以使用和来计算左右车道边界坐标。
假设车道分段可以概念化为可驾驶区域,我们将实例分段分支集成到预测器中。在语义方面,三个分类分支并行预测C的分类得分,和的得分。拓扑分支将更新的查询特征作为输入,并使用MLP输出车道图G的加权相邻矩阵。
训练损失
LaneSegNet采用类似DETR的范式,使用匈牙利算法有效地计算预测和地面实况之间的一对一最优分配。然后根据分配结果计算训练损失。损失函数由四个部分组成:几何损失、分类损失、laneline型分类损失和拓扑损失。
几何损失监督每个预测Lane Segment的几何结构。根据二分匹配结果,为每个预测的矢量化Lane Segment分配一个GT Lane Segment。矢量化几何损失定义为分配的Lane Segment对之间计算的曼哈顿距离。
实验结果
主要实验结构
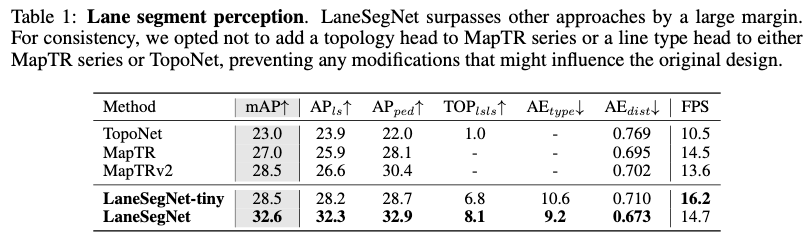
Lane Segment感知:在表1中,我们在新引入的Lane Segment感知基准上,将LaneSegNet与几种最先进的方法MapTR、MapTRv2和TopoNet进行了比较。用我们的Lane Segment标签重新训练他们的模型。LaneSegNet在mAP上的性能优于其他方法高达9.6%,平均距离误差相对降低了12.5%。LaneSegNet-mini也超过了以前的方法,FPS更高,为16.2。
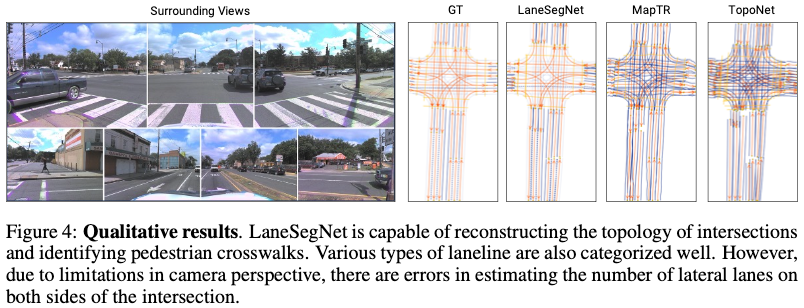
定性结果如图4所示:
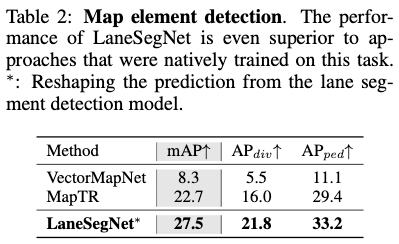
地图元素检测:为了与地图元素检测方法进行更公平的比较,我们将LaneSegNet的预测Lane Segment分解为成对的车道,然后使用地图元素检测指标将其与最先进的方法进行比较。我们将拆下的车道线和人行横道标签输入到几种最先进的方法中进行再训练。实验结果如表2所示,表明LaneSegNet在地图元素检测任务方面始终优于其他方法。在公平的比较下,LaneSegNet可以在额外的监督下更好地恢复道路几何形状。这表明Lane Segment学习表示善于捕捉道路几何信息。
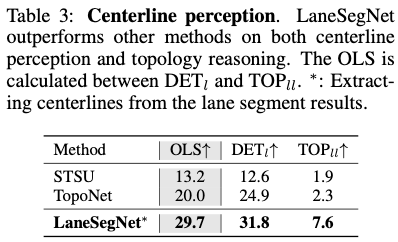
中心线感知:我们还在表3中将LaneSegNet与最先进的中心线感知方法进行了比较。为了保持一致性,还从Lane Segment中提取中心线以进行重新训练。可以得出结论,LaneSegNet在车道图感知任务中的性能明显高于其他方法。通过额外的地理监控,LaneSegNet还展示了卓越的拓扑推理能力。证明了推理能力与较强的定位和检测能力密切相关。
消融实验
Lane Segment公式:在表4中,我们提供消融来验证我们提出的Lane Segment学习公式的设计优点和训练效率。与前两行的单独训练模型相比,中心线和地图元素的联合训练对两个主要指标带来了全面的平均1.3的改进,如第4行所示,证明了多任务训练的可行性。然而,通过添加额外的类别在单个分支中训练中心线和地图元素的普通方法会导致明显的性能下降。与上述朴素单分支方法相比,我们使用Lane Segment标签训练的模型获得了显著的性能增强(对于第3行和第5行之间的比较,OLS上的+7.2和mAP上的+4.4),这验证了我们的地图学习公式中各种道路信息之间的正交互作用。我们的模型甚至超过了多分支方法,特别是在中心线感知方面(OLS为+4.8)。这表明几何可以在我们的地图学习公式中指导拓扑推理,其中多分支模型仅略微优于仅CL模型(第1行和第4行之间+0.6 OLS)。至于的小幅下降,它来自于我们预测结果的重塑过程,是由线型分类的错误引起的,
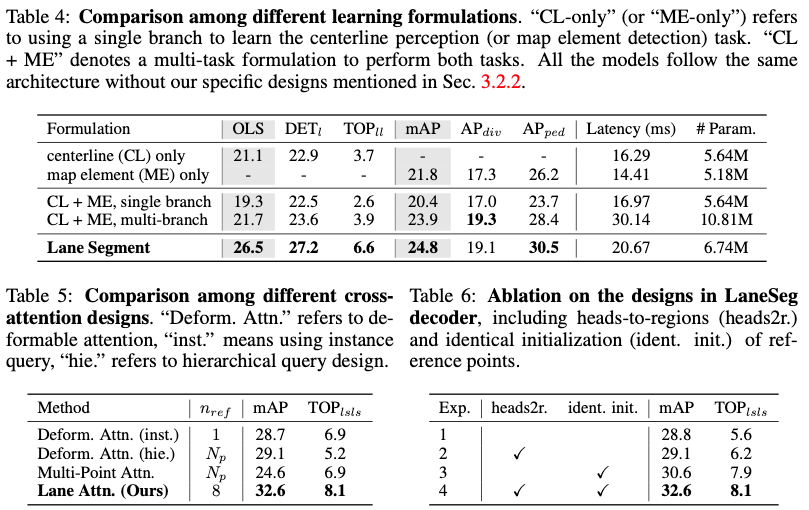
车道注意力模块:我们展示的注意力模块消融如表5所示。为了便于进行公平的比较,我们用替代注意力设计代替了框架中的车道注意力模块。在我们精心设计的情况下,具有车道注意力的LaneSegNet显著优于这些方法,显示出显著的改进(与第1行相比,mAP提高了3.9,TOPll提高了1.2)。此外,与分层查询设计相比,由于查询数量的减少,解码器延迟可以进一步减少(从23.45ms减少到20.96ms)。
结论
本文提出了Lane Segment感知作为一种新的地图学习公式,并提出了LaneSegNet,一种专门针对这一问题的端到端网络。除了网络之外,还提出了两个创新的增强功能,包括车道注意力模块,该模块采用头到区域机制来捕捉长距离注意力,以及参考点的相同初始化策略,以增强车道注意力的位置先验学习。在OpenLane-V2数据集上的实验结果证明了我们设计的有效性。
限制和未来工作。由于计算限制,我们没有将所提出的LaneSegNet扩展到更多的额外主干。Lane Segment感知和LaneSegNet的制定可能有利于下游任务,值得未来探索。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。