


神庙大学:AI回答问题时,"第一个字"就已经暴露了它是否在胡说

Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
天普大学研究发现,通过分析大型语言模型生成答案第一个词时的内部概率分布,可有效判断其输出是否可靠。该指标称为“第一个词的置信度”,其检测效果与需重复提问的复杂方法相当,但计算成本仅为后者的十一分之一。这为低成本识别AI“幻觉”提供了新思路。
当你向朋友问路时,如果他真的知道怎么走,往往会脱口而出“直走然后左转”。但如果他其实不确定,通常会先停顿一下,犹豫地说“呃……好像是……往那边?”。那个开口前的迟疑,往往比他最终给出的答案本身更能说明问题——他到底知不知道。
最近一项来自美国天普大学计算机与信息科学系的研究,正是抓住了这个微妙的瞬间。这项研究以预印本形式于2026年5月发表,论文编号为arXiv:2605.05166。其核心思路非常直观:当大型语言模型(也就是我们日常所说的AI聊天机器人)回答问题时,它在生成答案第一个词的那个瞬间,究竟是胸有成竹还是底气不足?这种“犹豫程度”,能否直接告诉我们它接下来说的话是可靠的,还是在“一本正经地胡说八道”?
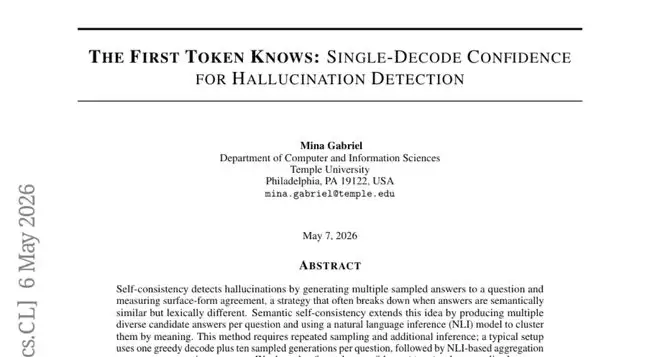
研究团队给这个“犹豫程度”起了一个正式的名字,叫做“第一个词的置信度”,用希腊字母φ加下标“first”来表示,简称φfirst。他们发现,这个单一的、从AI回答第一个词时就能读取的数字,在判断AI是否在产生“幻觉”(即编造事实)这件事上,其表现甚至略优于那些需要让AI把同一个问题重复回答十遍再做比较的复杂方法。更关键的是,它的计算成本只有后者的十一分之一。
这个发现,或许会改变未来所有检测AI输出可信度工具的设计思路。
一、AI为什么会“一本正经地胡说八道”
要理解这项研究解决的问题,得先聊聊AI“幻觉”的根源。现代的大型语言模型,其工作原理并非真的去“查阅资料”或“检索数据库”。它们更像是一个读过海量书籍的人,凭借记忆和模式来回答问题。这种方式存在一个根本性问题:当它们对某个事实“记不太清楚”的时候,通常不会诚实地说“我不知道”,而是会非常流畅地、基于概率拼凑出一个听起来合理但实际上是错误的答案。这就是所谓的“幻觉”。
幻觉的危险性恰恰在于它的“流畅性”。AI在说错话的时候,其语气、结构和自信程度,与说对话时几乎别无二致。这种表面上的高度一致,让普通用户极难从字里行间判断真伪。因此,如何有效、低成本地判断AI输出的可信度,就成了一个重要的研究方向。
目前主流的方法之一是“自我一致性检测”。原理很直接:把同一个问题反复问AI很多遍,然后统计它每次给出的答案是否一致。如果AI每次都肯定地说“莎士比亚写了《哈姆雷特》”,那么这个答案大概率是正确的;如果它这次说莎士比亚,下次又说马洛,那就说明它自己也不确定。这个方法有一定效果,但缺点显而易见——成本太高了,一个问题需要重复生成多次。
后来,研究者升级了这个方法,提出了“语义自我一致性”。这个升级版不只是机械地比较答案字面是否相同,而是借助另一个专门的语义理解模型,来判断这些答案在含义上是否一致。例如,“威廉·莎士比亚”和“莎翁”字面不同,但意思相同,升级版方法能识别出它们本质上是同一个答案。这个方法更精准,但代价也更大——不仅需要多次生成答案,还需要额外运行一个语义判断模型。
于是,天普大学的这支研究团队提出了一个更根本的疑问:我们真的需要问这么多遍吗?AI在第一次回答、吐出第一个词的那个瞬间,是不是就已经暴露了它的“底牌”?
二、侦探如何在嫌疑人开口的瞬间判断真假
研究团队的核心思路,可以用一个“侦探审讯”的场景来类比。经验丰富的侦探都明白,嫌疑人在被问到关键问题时,回答的第一个字往往最具信息量。如果他张嘴就来,干脆利落,说明他心中早有预案,答案经过了“预演”。如果他开口前有明显的迟疑,发出“呃……”或“这个……”的声音,则说明他的大脑正在临时组织语言,答案的可靠性自然要打上问号。
大型语言模型在生成文字时,也存在一个类似的“犹豫时刻”。模型在决定输出每一个词之前,实际上会在内部对词汇表中所有可能的候选词进行“打分”,分数高的词更有可能被选中。这些分数经过数学处理,可以看作是模型认为每个词作为下一个词的“概率”。
当模型被问到“《哈姆雷特》是谁写的?”时,如果它非常确定,那么“莎士比亚”这个词(或其对应的第一个token)会占据绝大部分的概率权重,其他候选词的概率几乎可以忽略不计。但如果模型不太确定,这个概率就会被分散到好几个不同的候选词上——“莎士比亚”、“马洛”、“培根”……都可能占有相当的概率,模型只是“碰巧”输出了其中概率最高的那个。
φfirst这个指标,衡量的正是这种概率分散程度的反面——即概率的集中程度。研究团队提取了AI在生成答案第一个有实际内容的词时,概率最高的前100个候选词,重新归一化它们的概率,然后使用“熵”这一数学工具来衡量这些概率的分散程度。熵值越高,说明概率越分散,模型越“犹豫”;熵值越低,说明概率越集中,模型越“确定”。最终的φfirst是用1减去归一化后的熵,因此,φfirst越高代表模型越有把握,越低则代表模型越迷茫。
关键在于,这个计算只需要模型运行一遍就能完成,既不需要重复提问,也不需要任何额外的模型。
三、考场上的实验设计
为了检验这个思路是否真的有效,研究团队设计了一套相当严谨的实验。他们选择了三个主流的开源AI模型:Llama-3.1-8B、Mistral-7B-v0.3和Qwen2.5-7B。这些都是研究界常用的中等规模指令微调模型,你可以把它们理解为三个不同品牌但性能相近的“AI考生”。
测试题目来自两个标准的知识问答数据集。第一个是PopQA,主要考察关于各类事实的简短问题,例如名人、地理、历史等,答案通常很短。第二个是TriviaQA,题目更接近知识竞赛风格,涉及领域更广,答案也稍复杂一些。每个数据集各抽取1000道题,确保三个模型都在完全相同的题目上作答,以进行公平比较。
“判卷”工作交给了另一个更大的AI模型(基于Qwen2.5-14B-Instruct的压缩版)。这个“阅卷老师”会综合考虑问题、AI给出的答案以及所有可接受的标准答案形式,来判断AI是否答对,而不是进行简单的字符串匹配。
研究团队将φfirst与五种现有的方法进行对比。按成本从低到高排列分别是:1)“口头置信度”:直接让AI自评对答案的把握(0-100分);2)三种不同严格程度的“表面形式一致性检测”:分别要求完整答案匹配、前三个词匹配或仅第一个词匹配,这三种方法都需要将同一问题重复提问10次并统计一致率;3)“语义自我一致性”:同样重复提问10次,但使用专门的语义理解模型(DeBERTa)来判断答案含义是否一致。
评价所有方法优劣的标准是一个叫做AUROC的指标。你可以把它理解为“该方法有多擅长将正确答案和错误答案区分开来”。AUROC等于0.5意味着和随机猜测没区别;等于1.0意味着完美区分。通常,超过0.8就表明方法相当不错了。
四、“第一个词”的惊人战绩
实验结果令人印象深刻。从整体平均成绩来看,φfirst获得了0.820的AUROC。而成本最高的对手——“语义自我一致性”方法,得分是0.793。其他方法的得分分别为:完整答案匹配的表面形式一致性(0.791)、前三个词匹配(0.782)、仅第一个词匹配(0.752)。效果最差的是让AI自报把握度的“口头置信度”,仅有0.700。
“口头置信度”垫底这个结果本身就值得玩味。让AI直接评估“我对这个答案有多少把握”,听起来最直接,但实际效果最差。这与以往许多研究的发现一致——AI在进行这种“元认知”(即对自己的认知进行认知)时,往往并不可靠。它可能对错误答案充满信心,也可能对正确答案过于谦虚。
进行更细致的分析后,φfirst在六个“数据集-模型”组合(两个数据集乘以三个模型)中,有五个组合都取得了最高分。剩下的那个组合,也只比最强的对手低了0.002分,差距微乎其微。
尤其在PopQA数据集上,φfirst的优势更为明显,三个模型的平均AUROC达到了0.875,而语义自我一致性只有0.839,差距超过了0.036。在TriviaQA数据集上,φfirst仍然领先,但优势缩小到了0.016。研究团队对此给出了一个合理的解释:TriviaQA的答案往往更长、表述形式更多样,这给了需要重复采样的方法更多的“发挥空间”——不同的回答表述中,可能仍然携带了一致性信息。而PopQA的答案很短,重复采样能提供的额外信息就比较有限。这个细微的差异,也被研究团队诚实地列为了研究的局限性之一。
五、胜利是否站得住脚——统计检验的证明
仅看AUROC的数值还不够,因为这些数字是基于特定的1000道题计算出来的,存在偶然性的可能。为此,研究团队进行了名为“配对自助检验”的统计测试。通俗地说,就是将这1000道题的数据反复随机抽样重组,看在大量随机重组的情况下,φfirst依然优于对手的比例有多高。如果这个比例超过95%,就可以认为差距是真实、稳健的,而非偶然。
结果显示,在与“完整答案匹配的表面形式一致性”对比时,φfirst在六个组合中有四个通过了检验;在与“语义自我一致性”对比时,有三个组合通过了检验。那些没通过的组合,意味着两者在统计上差异不显著,即表现相当,而非φfirst明显落后。而与最简单的“仅第一个词匹配”方法相比,φfirst在全部六个组合中都通过了检验,优势非常明显。
研究团队对此的表述非常客观:对于语义自我一致性,φfirst在部分情况下是“略胜一筹”,在其他情况下则是“打成平手”,而非全面碾压。这种坦诚,反而让研究的结论显得更加可信。
六、两者说的是同一件事吗?
φfirst和语义自我一致性成绩接近,这引出了一个有趣的问题:它们衡量的是同一种东西吗?换句话说,φfirst是否已经包含了语义自我一致性所能提供的大部分信息?
研究团队为此专门做了一个“信息包含性测试”。他们首先计算了两个指标之间的皮尔逊相关系数——这个数字越接近1,说明两者走势越一致。计算结果显示,在六个组合中,相关系数在0.54到0.76之间,均值为0.67。这表明两者是中等偏高的正相关,走势大体一致,但并非完全重叠。
更关键的测试是:如果将φfirst和语义自我一致性两个指标合并使用(通过一个简单的逻辑回归模型结合),会比单独使用φfirst提升多少?如果语义自我一致性提供了大量φfirst所没有的信息,那么合并后应该有显著提升;如果两者说的基本是同一件事,那么合并后的提升将微乎其微。
实验结果是:合并两者之后,AUROC平均只提升了0.021,在六个组合中有五个的提升幅度不超过0.025。这个提升几乎可以忽略不计,说明φfirst已经捕获了语义自我一致性绝大部分的判断能力。多花十倍的计算成本去运行语义自我一致性检测,带来的额外收益极为有限。
七、“答案越长越不自信”——这是真的吗?
研究团队还仔细检验了一个潜在的干扰因素:答案长度。有一种担忧认为,φfirst可能只是在间接衡量答案的长短——例如,正确的短答案往往第一个词就很确定,而错误的长答案第一个词可能更犹豫。如果是这样,φfirst的有效性可能只是一种表象,而非真正反映了模型的认知状态。
为了检验这一点,研究团队进行了两步分析。第一步,直接计算φfirst与答案长度之间的相关性,结果在-0.11到-0.25之间(负相关意味着答案越长,置信度倾向于越低)。这个相关性本身不算强,最多只能解释6.5%的变化,但确实存在。
第二步,研究团队使用了一个统计技巧,叫做“偏相关分析”。简单来说,就是先把“答案是否正确”这个共同因素的影响从两个变量(φfirst和答案长度)中剔除,然后再看它们剩余的相关性。其背后的逻辑是:我们知道,模型在答错时往往既更“犹豫”(φfirst低),又倾向于生成更长的答案来掩饰不确定性。如果把这个共同原因去掉,φfirst和答案长度之间还剩下多少关联?
在PopQA数据集上,剔除共同因素后,残余相关性从原来的-0.13到-0.16,大幅缩水到了-0.02到-0.04,几乎消失了。这说明在PopQA上,φfirst与答案长度之间的表面关联,几乎完全是因为两者都与“答案是否正确”相关,一旦控制了这个因素,两者就基本独立了。
在TriviaQA数据集上,情况略有不同:Llama和Mistral模型的残余相关性分别是-0.18和-0.17,下降幅度不如PopQA那么彻底。研究团队对此的态度依然诚实——这说明在TriviaQA上,答案长度对φfirst确实存在一定的独立影响,虽然不大,但无法完全排除。这一点也被明确列入了研究的局限性清单。
八、这项研究的边界在哪里
任何研究都有其适用范围,这项研究的团队在这方面表现得非常坦诚。目前,φfirst方法仅在英语环境下的“封闭式”短答案事实问答任务中得到了验证。所谓“封闭式”,是指模型完全凭借自身的参数记忆来回答,不借助任何外部文档检索。在这种设定下,答案的第一个词往往就决定了整个回答的走向,因此第一个词的置信度具有很高的代表性。
但是,如果换成需要大段推理的问题,例如“请分析第一次世界大战的主要原因”,答案的第一个词可能只是一个“第”字,完全无法预示后续内容。或者,如果换成需要先检索外部文档再作答的场景,模型的不确定性来源就不仅仅是其内部记忆,还包括检索结果的质量,此时第一个词的置信度可能就无法代表全局了。
此外,φfirst方法需要能够访问模型生成每个词时的原始概率分布。这意味着,对于那些只提供最终文字输出、不开放内部数据的商业API(例如某些封闭的云端AI服务),该方法完全无法适用。
研究团队在初步分析中还发现,如果不只看第一个词,而是汇总整个回答生成过程中所有词的置信度信息,在TriviaQA数据集上可以获得更好的效果。这个方向被留作未来的研究课题,意味着φfirst可能只是这类“单次解码置信度”方法的冰山一角。
说到底,这项研究揭示了一个具有高度实用价值的洞见:在你决定投入大量算力、反复询问AI同一个问题十遍之前,不妨先花点时间,仔细看看它第一次回答时,吐出第一个词的那个瞬间有多自信。这个几乎零成本的信号,往往已经足够告诉你,它接下来说的话是否值得信任。
研究团队据此建议,未来任何声称能更有效检测AI幻觉的新方法,都应该先将φfirst作为一个廉价的基准线进行报告。只有新方法的表现明显超越了这条简单的基准线,其额外的计算成本才算物有所值。
这个发现本身充满了一种简洁的美感——AI在开口的那一刻,就已经在某种程度上“供认”了它自己是否心中有数。我们需要做的,只是学会读懂那个瞬间。
Q&A
Q1:什么是“AI幻觉”,为什么很难被发现?
A:AI幻觉是指大型语言模型在不知道正确答案的情况下,仍然流畅地编造出一个听起来合理但实际错误的答案。其难以被发现的原因在于,AI在说错话时,其语气、自信程度和逻辑性与说对话时几乎无异,没有明显的犹豫或警示信号,导致普通用户很难从表面判断真伪。
Q2:第一个词置信度检测方法需要额外购买工具或服务吗?
A:该方法本身不需要额外工具,但有一个重要前提:你必须能够访问模型生成每个词时的内部概率数据。这对于开源模型是完全可行的。然而,对于那些只提供最终文字输出、不开放内部数据的商业AI接口(如某些云端API),该方法目前无法使用。这是其最主要的应用限制。
Q3:语义自我一致性和第一个词置信度哪个更适合实际应用?
A:对于短答案事实问答场景,两者的检测效果相当。但第一个词置信度(φfirst)的计算成本仅为语义自我一致性的约十一分之一,且无需额外部署语义理解模型。因此,在实际应用中,优先使用第一个词置信度显然更为经济高效。只有当答案较长、表述形式多变时,语义自我一致性才能体现出些许额外优势,但需权衡其高昂的成本。











火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。