


清华发现:让AI自己出"模拟题",数学竞赛题的正确率飙升了4分

Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
教一个孩子解数学难题,最笨的办法是什么?把题目直接扔给他,做对了夸一句,做错了骂一顿,然后期待他下次就会了。任何有经验的老师都知道,真正有效的教学方式应该是把一道大题拆成几道小题,让孩子一步一步爬楼梯,在每一级台阶上都得到反馈,逐渐积累信心和能力,最终独立完成那道原本看似高不可攀的难题。这个道理适用
教一个孩子解数学难题,最笨的办法是什么?把题目直接扔给他,做对了夸一句,做错了骂一顿,然后期待他下次就会了。任何有经验的老师都知道,真正有效的教学方式应该是把一道大题拆成几道小题,让孩子一步一步爬楼梯,在每一级台阶上都得到反馈,逐渐积累信心和能力,最终独立完成那道原本看似高不可攀的难题。
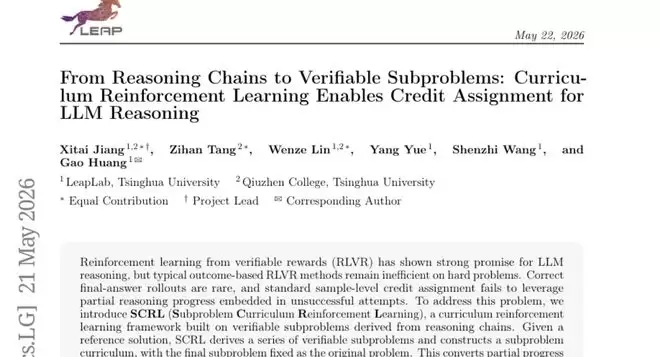
这个道理适用于人类学生,同样适用于人工智能。清华的研究团队发现,目前主流的AI数学训练方式,正在犯"把难题直接扔给学生"这个经典错误。他们提出了一套名为SCRL(子问题课程强化学习)的新训练框架,用"出模拟题"的方式帮AI爬楼梯,让它在挑战奥林匹克级别数学难题时,平均成绩提升了整整4.1分——这在AI研究领域是相当显著的进步。
一、AI学数学:为什么"做对了给糖,做错了不给"的方法失效了
要弄明白SCRL到底解决了什么问题,得先搞清楚当前AI是怎么学数学的。目前最流行的方法叫"基于可验证奖励的强化学习",缩写是RLVR。简单来说,就是AI做一道题,如果最终答案对了,就给颗糖(正向奖励);如果答错了,啥都不给。AI就在无数次做题、获奖或落空的循环中,逐渐摸索出解题的规律。
这套方法在中等难度的数学题上效果还不错。但一旦遇到真正的硬骨头,比如美国数学奥林匹克邀请赛(AIME)或国际数学奥林匹克(IMO)的题目,立刻就哑火了。原因很简单:这些题太难了,AI几乎每次都做错,一颗糖都拿不到。训练系统从没见过"做对了"是什么样子,自然也就无从学习。
更糟糕的是,哪怕AI离正确答案就差那么一小步,系统也完全识别不出"差一点"和"差十万八千里"的区别。所有错误在它眼里都一样,没有任何中间反馈。这就好比老师批改作文,不管学生写得是90分水平还是20分水平,只要没满分,统统打零分——这反馈方式根本帮不了学生进步。
研究团队把这种现象叫做"梯度死区"。从数学上看,当AI几乎每次都做不对某道题时,用来更新参数的"学习信号"会趋近于零,AI陷入一种停滞状态,无论怎么练都学不到有用的东西。
之前的研究人员尝试过两种补救方案。一种是直接给AI"抄作业"——把正确答案和过程展示给它模仿。这种方式短期内有效,但学生永远不会真正理解解题思路,换个题型就抓瞎。另一种是给AI"提示前缀"——把正确答案的前几步直接塞给它,让它只负责完成剩余部分。这就像老师帮忙做完了前三步,只让学生做第四步。学生练的是"接盘"而非"从零开始",能力提升自然有限。
清华团队认为,这两种方案都是在回避问题,而不是真正解决问题。他们的目标是:让AI保持完全自主探索的同时,也能从每一次"虽然没做对但已经做到第几步了"的尝试中获得有意义的学习信号。
二、"分级模拟题"的灵感:从数学竞赛的出题方式说起
说起来,清华团队的灵感特别直观:数学竞赛的题目往往不是单一问题,而是一道分成四个小问的综合题。第一问最简单,第二问稍难,第三问更难,第四问就是最终的核心难题。每做对一个小问都能拿分,而且前一问的结果往往是解下一问的基础。
这种结构设计极其精妙。它让参赛者即使解不出最后一步,也能凭借前几步的正确推导拿到部分分数。对出题者来说,这四个小问共同引导着学生一步步深入核心知识点,难度层层递进,形成了一个自然的学习路径。
SCRL框架完全借鉴了这个思路。给定一道难题和它的参考解题过程,系统会用一个外部语言模型(扮演"课程设计师"的角色)从解题过程中提炼出四个渐进式的子问题。这四个子问题难度递增,后面的问题以前面问题的结论作铺垫,但每个问题本身又是独立的、有明确可验证答案的。最关键的是,第四个子问题就是原始的难题本身。
AI在训练时面对的不再是孤零零的一道难题,而是一份"四题连环卷"。它需要按顺序作答,在一次连续的推理过程中解决全部四道题。每道题的答案都夹在特殊标签之间,系统可以分别验证每道题的对错。
这里有一个非常关键的地方:AI解题时并没有得到任何"提示"或"前几步的答案"。四个子问题都是以完整独立的问题形式呈现的,AI必须完全依靠自己的能力从第一题做到第四题,所有的推理步骤都是自己生成的。这就避免了之前"给提示"方案的核心缺陷——AI练的永远是完整的、自主的解题能力,而不是"接着别人的思路继续做"的能力。
三、"只算连续答对的题":一个防作弊的关键设计
子问题分解解决了"学习信号太稀疏"的问题,但随之而来的新麻烦是:如果AI在第一题和第二题都做错了,却碰巧猜对了第三题,这个第三题的正确答案应该给奖励吗?
清华团队认为不应该。因为在正常的解题逻辑中,第三题的正确答案是建立在第一、二题的正确结论之上的。如果前两步都是错的,第三步"碰巧对了"只是一种误打误撞,不代表AI真正掌握了这一步的推理。奖励这种"运气好的错误"反而会给AI错误的导向,让它学会通过猜答案来骗取奖励,而不是真正理解解题逻辑。
因此,SCRL引入了一个叫做"进度感知修正"的机制。系统只承认AI"连续从第一题开始答对"的进度。如果AI答对了第一、二题,但第三题答错了,那第四题即使答对,也不计入有效成绩。换句话说,如果AI的答题情况是"对、对、错、对",系统会把它视为"对、对、错、错"来处理。
这就好比一场接力赛:只有当前面把棒子递到手里,后面的成绩才作数。如果第三棒选手摔倒了,即使第四棒跑得再快,也于事无补,比赛在那一刻就已经失败了。这个设计彻底堵住了AI通过"跳跃式猜题"来刷分的漏洞,确保奖励信号真正对应着有效的推理进步。
四、"按位置打分":比以前的方式精细了整整一个维度
解决了"哪些答案算数"的问题之后,还有一个核心技术问题:怎么把每道子题的分数,精确地反馈给负责生成那道题答案的具体文字?
在之前的GRPO方法中,整道题的最终得分被"平摊"给这道题解答中的每一个字。无论是解题过程中的关键推导,还是无关紧要的废话,都收到同等程度的奖励或惩罚。这就像一位导演在评价一部电影时,不管哪个场景,一律给出同样的评价——演员、摄影、配乐全部不区分。显然,这种粗糙的反馈无法指导团队改进真正需要改进的地方。
SCRL提出了"子问题级别归一化"的方法,让反馈精细了整整一个维度。系统分别对四个子题各自打分,比较同一组AI生成的多个解答在第一题上谁表现更好、在第二题上谁表现更好,以此类推。然后,每道子题的独立评分,只被反馈给生成那道子题答案的那段文字。
这样做的结果是,第一题推导写得好的部分,会得到针对第一题的专属奖励;第三题解答写得差的部分,会得到针对第三题的专属惩罚。AI能以更高的精度了解到自己的哪些推理步骤是有价值的,哪些是走弯路的。
五、"两套卷子同时练":防止AI忘记怎么答原题
到这里,系统还面临最后一个实际问题:AI在训练中反复练的是"四题连环卷"格式,但在真正考试时,它面对的是原始的单题格式。如果训练和测试的题目形式差异太大,AI可能会慢慢"忘记"怎么直接回答单道难题,而变得只会答格式化的多题卷子。
为了防止这种情况,SCRL采用了"混合训练"的策略。每次训练时,系统同时给AI布置两种作业:一半是"四题连环卷"格式的课程题,用子问题级别的精细反馈来训练;另一半是原始的单题格式,用传统的整体打分方式来训练。两种训练在同一次参数更新中共同发挥作用。
这就像一位高考生的复习计划:一部分时间做分解练习,专注于每个知识点;另一部分时间做完整的模拟卷,保持对全题的整体感觉。两者缺一不可,相互补充。
六、数学证明:为什么这个方法理论上一定有效
研究团队不满足于仅仅用实验结果说话,他们还从数学角度严格证明了SCRL有效的根本原因。
核心思路是这样的。在数学上,可以用一个叫做"有效梯度信息矩阵"的量来衡量AI从一道题上能学到多少东西——矩阵的最小特征值越大,学习信号就越强,AI进步得越快;如果这个值趋近于零,AI就陷入了"梯度死区",学习停滞。
研究团队用定理严格证明:当一道题对于当前AI来说太难,正确率接近零时,直接在这道题上训练的学习信号也会趋近于零,印证了"梯度死区"的存在。与此同时,另一个定理证明:只要子问题的正确率比原题高(这是课程设计的基本前提),在子问题上的学习信号就能保持在一个有意义的正值上,从根本上跳出死区。更精妙的是,原题越难(正确率越低),子问题方法相对于直接训练的优势就越大——这在数学上体现为恢复比率是原题正确率的倒数级别。
简单类比:一道每100人中只有1人能答对的极难题,用子问题方法训练的效果比直接训练好约100倍的量级;而一道每10人中有1人能答对的中等难题,优势只有约10倍。越是绝世难题,这套方法就越是关键。
七、实验结果:在七个数学竞赛基准上全面领先
理论证明完成后,研究团队进行了大规模的实验验证。他们使用了两种主流的大语言模型:阿里的Qwen3系列(包括4B和14B参数量的版本)以及Meta的Llama 3.2系列(3B参数量版本),在七个数学推理基准上进行了全面测试,这七个基准涵盖了从相对较难的奥林匹克数学题(OlympiadBench)到顶级竞赛题(AIME 2024、AIME 2025、IMO-Bench)的完整难度谱系。
在中等规模的Qwen3-4B模型上,SCRL的表现最为突出。在七个基准上的平均分,SCRL达到了35.0%,而同样的模型用传统GRPO方法训练只有30.9%,差距达到4.1个百分点。和最强的竞争方法QuestA(32.0%)相比,SCRL还领先了3.0个百分点。在最难的AIME 2025上,SCRL取得了15.3%的成绩,而QuestA只有11.7%,传统GRPO更是只有7.2%。
在更大规模的Qwen3-14B模型上,SCRL同样取得了最高的平均分38.3%,比GRPO的36.4%提升了1.9个百分点。
除了"做一次能不能做对"(pass@1)这个指标,研究团队还测试了pass@64,即给AI64次机会,只要有一次做对就算成功。在这个反映AI"探索能力"的指标上,SCRL的提升更加明显——在三个最难的基准(AIME24、AIME25、IMO-Bench)上,pass@64比GRPO提升了4.6个百分点,说明SCRL训练的AI不仅在常规情况下表现更好,在面对极难问题时也具备更强的探索和尝试能力。
训练过程中的数据也很能说明问题。研究人员追踪了AI能够解决的题目数量随训练进行的变化。SCRL训练的AI解题能力扩展得更快,最终能覆盖的题目范围也比GRPO更广,而且这种能力的提升并不只体现在"课程格式"的题目上,在原始的单题格式下同样有所改善,说明课程训练的收益真实地迁移到了实际解题能力上。
八、不依赖顶级AI出题,弱一点的模型也能用
这个研究框架有一个潜在的担心:生成子问题需要用外部语言模型,如果这个"出题模型"水平不高,生成的子问题质量差,整个系统还能工作吗?
研究团队专门对此进行了测试。他们分别用顶级的DeepSeek-V3.2和较弱的Qwen3-4B-Instruct(与被训练的模型同等规模)来生成子问题,然后在同样的训练管线下进行对比。结果发现,用弱模型生成子问题时,SCRL依然比传统GRPO高出2.7个平均分;用强模型生成子问题时,提升幅度进一步扩大到3.9个平均分。
这说明SCRL框架本身的有效性并不依赖于一个特别强大的外部出题模型,弱模型生成的子问题哪怕质量一般,也足以提供有意义的课程结构。当然,更好的出题模型能带来更大的收益,但这不是系统运作的必要条件。
九、细节验证:删掉任何一个设计都会变差
研究团队还做了一系列"拆零件"的实验,验证系统中每个设计决策的必要性。
第一个测试是去掉"进度感知修正"机制,允许第三、四题即使在前面做错的情况下也能获得奖励。结果平均分从44.2降到了41.9,说明这个防作弊机制是真实有效的,不只是理论上好看。
第二个测试是把"子问题级别打分"换回"整体打分",即虽然出了四道子题,但仍然只在意最后那道原题对不对,课程题只是作为辅助格式使用。结果平均分变成了43.9,比完整版SCRL的44.2略低,但比没有课程的GRPO的40.3仍然高出不少。这说明仅仅是把难题拆开来问,让AI练习多步推理,本身就有一定价值;但精细到子题级别的信用分配,能在这个基础上进一步提升性能。
第三个测试是改变子问题的数量K。当K从默认的4降低到3或2时,性能都有所下降,但即使只有K=2(只有两道子题),也仍然比单纯的GRPO要好。K越大,AI在每次练习中能获得学习信号的机会就越多,但同时也对AI提出了更高的要求,需要它连续答对更多题。K=4是研究团队认为最合适的平衡点。
十、超出数学领域:在代码生成和科学问答上也有提升
研究成果不仅限于数学领域。研究团队还把用SCRL训练的Qwen3-14B模型放到了三个完全不同的任务上进行测试:科学知识问答(GPQA)、代码生成(HumanEval)和竞争性编程(LiveCodeBench v6)。
结果显示,SCRL在这三个任务上的平均分为51.67,而传统GRPO只有48.37,原始未训练的基础模型是47.20。三项任务中SCRL分别比GRPO高:GPQA高4.55分(41.41对36.86)、HumanEval高4.87分(89.02对84.15)、LiveCodeBench高0.47分(24.57对24.10)。
这个结果说明,SCRL训练的不是针对特定题型的技巧,而是一种更底层的、可迁移的多步推理能力。这种能力在需要分步骤解决问题的任务中普遍有效,无论问题是数学、科学还是编程形式的。
说到底,清华团队做的这件事可以用一句话概括:他们教会了AI自己给自己出练习题,而且出的练习题质量还不错。通过把一道大难题拆成四道递进的小题,AI终于有机会在每一次练习中获得有意义的反馈,而不是在无尽的失败中原地打转。
这对普通人的意义是什么?最直接的影响是:未来的AI数学助手和通用推理AI将会更擅长处理真正困难的问题,而不仅仅是常见题型。当你遇到一道棘手的证明题或复杂的工程计算时,AI提供帮助的能力将会明显增强。更深远的影响在于,这套训练思路不限于数学,可以推广到任何需要多步骤推理的领域,比如法律分析、医学诊断、软件调试等。
当然,这套方法也有它的局限性。构建子问题需要依赖外部语言模型来辅助,增加了训练前的准备工作量。此外,子问题必须有明确可验证的答案,对于那些没有标准答案、需要主观判断的开放式任务,这套方法目前还不太好用。
一个有趣的延伸思考是:AI替自己设计练习题这件事,其实和人类学习中"费曼技巧"有异曲同工之妙——真正理解一个知识点的标志,是你能把它分解并讲解给别人听。SCRL让AI在某种意义上做到了这一点:通过理解一道难题的解题结构,把它转化为一系列可以一步步验证的子目标。
Q&A
Q1:SCRL方法中的"子问题"是AI自己想出来的,还是人工设计的?
A:子问题是由外部语言模型(如DeepSeek-V3.2或Qwen3-4B-Instruct)根据原题的参考解答自动生成的,不需要人工逐题设计。生成时需要提供原题、标准答案和参考解题过程,外部模型会从解题步骤中提炼出四个难度递进的子问题,整个过程是离线自动完成的。
Q2:SCRL训练出来的模型,回答问题时还会出现那四个子问题的格式吗?
A:不会。SCRL采用了"混合训练"策略,一半训练用带子问题格式的课程题,另一半用原始单题格式。测试时使用的也是标准的单题提示格式,模型会直接给出最终答案,不会带有子问题的标签结构。子问题格式只在训练过程中间出现,不影响最终使用时的对话体验。
Q3:SCRL和直接给AI看正确解题过程(监督微调)相比,哪个效果更好?
A:从实验数据看,SCRL整体优于监督微调(SFT)。以Qwen3-4B为例,SFT的平均分是28.0,而SCRL达到35.0,领先了整整7分。监督微调让AI记忆标准答案,而SCRL让AI在自主探索中学习推理结构,两者培养的能力有本质区别,在面对新题时SCRL训练出的模型泛化能力更强。











火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。