


当AI开始"梦游":BITS比拉尼大学等机构联合打造的3D导航测试场
印度等多国机构联合发布SleepWalk基准,用于评估视觉语言模型将语言指令转化为三维路径的能力。该基准通过构建多难度导航任务,由AI从四个维度评分。测试发现,当前先进模型虽能规避障碍,但在精准执行指令方面仍有不足,凸显了AI在空间与语言对齐上的短板。
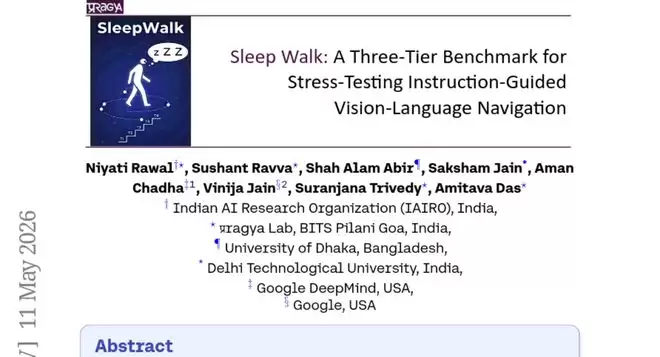
最近,一项关于AI“空间行动力”的研究引起了广泛关注。这项由印度BITS比拉尼果阿校区、印度人工智能研究组织(IAIRO)、孟加拉国达卡大学、德里理工大学,以及来自谷歌DeepMind和谷歌的研究人员共同完成的工作,于2026年5月以预印本形式发布在arXiv上,编号为arXiv:2605.10376。其核心成果,是一个名为SleepWalk的评测基准。这个基准的目的很明确:量化评估视觉语言模型在三维场景中,将一句简单的语言指令,转化为一条可执行、可落地的物理路径的能力。
当机器人“听懂了”但“走错了”
想象这样一个家庭场景:你对着智能机器人助手说:“去把沙发旁边的遥控器拿过来给我。”它或许会点头示意,表示理解。但接下来,它可能径直撞上茶几,或者停在沙发的另一侧,怎么也够不着遥控器。这听起来像科幻喜剧里的桥段,却精准地戳中了当前最先进的视觉语言模型(那些能同时“看图”和“理解文字”的AI)所面临的真实困境。
这类模型在图像描述、问答、指令跟随等任务上成绩斐然。然而,“能说清楚”和“能走对路”之间,存在着一道巨大的鸿沟。当AI需要真正进入物理世界,成为机器人的“大脑”时,它面临的挑战远不止“认出沙发在哪里”。它必须规划出一条从起点出发、绕开所有障碍、最终精准停在一个能伸手拿到遥控器的位置的完整路径。SleepWalk这个评测框架,就是为了精确测量这道鸿沟到底有多宽而设计的。其名字“梦游”颇具深意,暗示了当前AI在三维空间中的行动,更像是一种缺乏清醒空间认知的盲目摸索。
一、从一张文字描述,到一个可以“走进去”的三维世界
构建SleepWalk测试的第一步,是创建逼真的三维考场。研究团队从著名的图像数据集MS-COCO中抽取了原始的场景文字描述,经过人工筛选和精心改写,最终得到了1200条适合生成单一、连贯场景的描述,涵盖室内和室外环境。
这些文字描述随后被喂给一个名为Hunyuan3D-3.0的三维场景生成系统。这个过程,好比一位效率极高的虚拟建筑师:你给它一段话,比如“一家墙壁和地板都很舒适的书店,里面有书架、梯子、阅读椅和收银台,陈列丰富”,它就能根据描述,自动估算空间布局、物体摆放和整体几何结构,生成一个完整的三维环境。
为了确保这些生成的环境能真正用于测试“行走”能力,团队对每一个场景都进行了严格的人工筛选。标准包括:场景必须在视觉和空间上连贯;必须有足够的空地供一个人形智能体移动;主要物体必须能从渲染图像中被清晰识别;任何出现严重几何错误(如物体悬浮、穿模)的场景都会被直接剔除。
经过层层筛选,最终保留了2472个高质量的三维环境。对于每个场景,团队都渲染出两张关键图像:一张是正上方的“鸟瞰图”,清晰展示平面布局和障碍物分布;另一张是带倾斜角度的“斜视图”,更好地呈现物体外观和交互细节。这两张图,共同构成了AI模型在执行任务时所能“看到”的全部视觉信息。
这种聚焦于单一场景内部的设计是刻意为之的。与以往让AI在多个房间穿梭的导航测试不同,SleepWalk压缩了探索范围,将焦点集中在更精细的局部推理上——在一个摆满家具杂物的空间里,AI能否找到正确目标、规划出安全路径、并在恰当的位置停下?这恰恰是现实世界中机器人助手最常遇到的挑战。
二、九道题、三个难度,测的是“越说越难懂”的指令
有了场景,下一步是为每个场景设计考题。研究团队使用了另一个视觉语言模型Qwen3-8B-VL来生成任务。这个模型同时观察鸟瞰图和斜视图,并被要求生成九条不同的导航指令,按难度分为三个等级,每级三条。
简单任务要求直接的、单目标移动,例如“从书架走到墙上的灯”。这类任务的关键在于正确识别起点和终点的位置,路径规划相对简单。
中等任务开始引入组合要素,比如“走向那个黄色球形物体,然后移动到北边的树”。这要求AI不仅要识别两个不同目标,还要按正确顺序依次抵达,并将“先……再……”的时间逻辑体现在路径规划中。
困难任务则进入了真正的多步骤交互领域,例如“从服务台拿起托盘,走到圆桌,把它放在那里”。这不仅涉及三个不同的物体和位置,还包含了拿取、搬运、放置等动作序列,要求AI规划出完整的行动链条,并确保终点位置支持放置动作。
指令生成过程设置了严格约束:起点和终点必须对应场景中真实可见的具体物体;禁止使用“左边”、“右边”等依赖观察者视角的模糊方向词;所有提及的物体必须在画面中存在。这套三级设计的逻辑很清晰:随着任务难度提升,所需的推理能力从“识别目标位置”,升级到“把握多个目标的空间与时间关系”,再升级到“规划包含具体动作约束的完整序列”。每一级都在增加新的认知负担。
三、让AI“画出”路径:轨迹预测任务的设计
SleepWalk的核心考核内容是轨迹预测。每个被测模型会同时接收到两张场景图像和一条语言指令,然后需要输出一条具体的行走路径。
这条路径由一系列三维坐标点表示。场景被离散化为一个25×25×25的网格,模型需要输出从起点到终点经过的每一个中间坐标。一条合格的路径必须满足三个条件:全程位于场景空间范围内;不能穿过任何障碍物;终点位置必须支持指令要求的动作(例如,要能“拿起”物体,终点就必须足够靠近且无障碍)。
这个设计的关键在于,它评估的是整条路径的每一步合理性,而不仅仅是终点是否正确。传统的导航测试往往只看最终结果,就像考试只看答案对错,不管解题过程。SleepWalk要求的是一份完整的、经得起推敲的“解题步骤”。所有模型均在零样本条件下测试,确保结果反映的是其原生能力,而非针对测试的临时优化。
四、用AI当考官:轨迹评分的四维标准
模型输出路径后,如何打分?研究团队设计了一套基于AI评判模型的评分协议,选用GPT-5-mini担任“考官”。
考官会看到三样东西:场景鸟瞰图、导航指令,以及模型预测的路径(在鸟瞰图上以绿色星形标记路径点,绿色圆点标记起点,红色圆点标记终点)。基于这些信息,考官从四个独立维度打分,每个维度1-5分:
1. 起点准确性:路径是否从正确的初始区域出发。
2. 目标完成度:路径终点是否真正到达指令要求的位置,并支持所述动作。
3. 障碍物规避:路径是否绕开了所有明显障碍。
4. 路径效率:路径是否足够直接,没有不必要的绕路。
有效分数归一化后,先在同一难度等级内平均,再跨三个难度等级平均,得到每个维度的总体得分。这套体系能区分“没撞墙但走错了地方”和“找对了地方但绕了远路”等细节差异,比简单的对错二分更精细。当然,依赖AI评判模型本身也存在局限,其可靠性目前缺乏系统性的人工标注验证。
五、三个选手上场:GPT-5-mini、Qwen3-VL、Gemini Robotics ER-1.5
研究团队选取了三个前沿视觉语言模型参与测试:Qwen3-VL、Gemini Robotics ER-1.5和GPT-5-mini。它们在完全相同的条件下接受考核。
从整体得分看,GPT-5-mini在四个维度上均领先:起点准确性(0.75)、目标完成度(0.51)、障碍物规避(0.91)、路径效率(0.64)。Gemini Robotics ER-1.5居中,Qwen3-VL得分相对最低。
这组数据揭示了一个有趣的现象:三个模型在“障碍物规避”上都表现尚可(最低也有0.84),但在“目标完成度”上却集体表现不佳(最高也只有0.51)。这就好比打靶:模型都能把子弹打在靶场范围内(不撞墙),但能否命中靶心(精准到达正确位置)就是另一回事了。前者考验的是生成一条“看起来合理”的路,后者考验的才是真正理解指令并精准对齐空间位置的能力——而这正是当前的短板。
六、越难越崩:三个等级之下的系统性衰退
按难度细分的结果,揭示了一个清晰的规律:随着任务从简单、中等升级到困难,所有模型的表现均出现下滑,且下滑幅度在需要多步骤推理和交互约束的任务中尤为剧烈。
在简单任务(如“从书架走到墙上的灯”)中,模型能大体理解语义并规划方向,但路径常过于贴近物体,存在潜在碰撞风险。这表明,即使是最简单的任务,模型也未能完全弥合“语义理解”与“物理可行性”之间的裂缝。
中等任务(如“走向黄色球形物体,然后移动到北边的树”)的主要挑战在于组合性推理。模型常常无法正确绑定多个参照物到其空间角色,或保持正确的时间顺序,失败模式多为起点或终点定位错误。
困难任务(如“从服务台拿起托盘,走到圆桌,把它放在那里”)引入了显式的物体交互和多步规划。即便是表现最好的模型,在理解“在哪里执行放置动作”这类精确要求时,也显示出明显局限。
综合来看,失败模式可归纳为三类:起点定位偏差、目标定位不完整或错误,以及路径语义通顺但物理上不安全(可能导致碰撞或无法完成动作)。
七、让路径“活起来”:人形机器人动作验证
除了静态评分,团队还进行了一项额外的可视化验证:将GPT-5-mini预测的路径,导入真正的人形运动动画中进行模拟。
具体方法是,先将路径坐标序列输入TLControl系统,转换为低级别运动控制信号;再用MotionGPT系统根据这些信号生成逼真的全身动作动画。这一步的价值在于,它能暴露纯鸟瞰图分析无法发现的问题:一条在平面上看似无误的路径,在三维执行时可能会近距离掠过障碍、停在肢体无法舒适动作的位置,或产生不自然的运动过渡。
这个阶段主要用于定性理解,而非主要评分依据。它像一台高倍显微镜,帮助研究者洞察单靠分数无法捕捉的失败细节,搭建起从“几何正确”到“具身可行”的认知桥梁。
八、这个测试框架本身有哪些局限?
研究团队在论文中坦诚列出了SleepWalk的几个局限,体现了其严谨性。
首先,所有场景均基于文字描述生成,是合成环境而非真实世界扫描。这意味着物理细节(如重量、摩擦力)仅为近似,无法完全反映现实复杂性。其次,主要评分依赖AI评判模型,虽有多维度标准,但缺乏系统性人工核验,结果存在不确定性。第三,鸟瞰图叠加路径的可视化是一种简化,无法捕捉具身执行的全部细节。
此外,论文对从“1200条描述”到“2472个环境”的具体转化过程描述可更详细。目前仅评测了三个模型,未来需要覆盖更广泛的模型类型以得出更普遍的结论。
说到底,这场“梦游测试”告诉了我们什么
归根结底,SleepWalk所做的工作,是在AI系统真正踏入现实世界之前,进行一场严格的预演检验。
测试结果清晰地表明,当前顶尖的视觉语言模型在“不撞墙”方面已做得不错,但在“走对地方”这件事上仍力有未逮。更深层的问题在于,模型尚未完全掌握将语言指令与物理空间进行精确对齐的能力——即理解“指令所说的具体是哪个位置,以及到达后身体该如何摆放”。
对于未来要进入家庭和工厂的机器人而言,这种能力至关重要。一个只能“大概走到附近”的机器人,在现实中可能导致碰撞、无法操作甚至引发事故。SleepWalk的价值,就在于提供了一种可量化、可重复、可扩展的方法,来测量现有系统与这一目标之间的实际距离。
研究也指出了几个值得探索的方向:丰富输入信息(如多视角、时序观察);在结构化三维场景表示上直接推理;将路径预测与底层运动控制更紧密结合;将框架迁移至物理仿真器,支持从仿真到现实的能力迁移。
这项研究促使我们思考的,不仅是AI技术的进步方向,更是评估AI能力时是否问对了问题。能描述、能识别、能说出意图,与能真正在环境中行动,中间隔着一道尚未被完全量化的鸿沟。SleepWalk的价值,正是将这道鸿沟清晰地量化出来,使其从一个模糊的直觉,变成一个可以持续追踪进展的具体标尺。
Q&A
Q1:SleepWalk测试框架和普通的视觉语言导航测试有什么不同?
A:SleepWalk专注于单一场景内的局部精细推理,要求模型输出完整路径而非仅仅到达终点,并评估路径每一步的物理合理性与动作可执行性。传统导航测试更关注跨房间长距离探索,且常以终点到达作为单一成功标准,容易掩盖路径规划本身的问题。
Q2:SleepWalk的评分为什么不用距离这样的几何指标,而要用AI当评判模型?
A:因为路径的正确性不仅是几何问题,还涉及动作语义。例如,“停在能够拿到物体的位置”这种判断,仅靠坐标距离无法完成。使用GPT-5-mini作为评判模型,能同时理解语言指令和视觉场景,对路径是否真正完成任务给出综合判断,弥补了纯几何指标的不足。
Q3:SleepWalk测试出来的AI最大弱点是什么?
A:测试结果显示,模型在障碍物规避上得分较高,但在目标完成度上得分很低。这说明当前模型的主要短板不是生成一条“看起来合理”的路径,而是精准地将语言指令对应到正确的空间位置,并停在一个真正支持执行指定动作的地点。精准的空间-语言对齐能力仍是关键瓶颈。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。