


python使用pdfplumber库一键提取pdf中的所有超链接
前言 在PDF的世界里,超链接有一个更专业的名字——“链接注释”。 根据PDF规范,它本质上是一种特殊的注释类型。其核心结构定义了用户可以点击的区域、指定了要跳转的目标地址(可能是网页URI,也可能是文档内的某个页面),并且可以设置一些视觉样式。正是这种设计,让PDF阅读器能够识别并响应我们的点击操
前言
在PDF的世界里,超链接有一个更专业的名字——“链接注释”。
根据PDF规范,它本质上是一种特殊的注释类型。其核心结构定义了用户可以点击的区域、指定了要跳转的目标地址(可能是网页URI,也可能是文档内的某个页面),并且可以设置一些视觉样式。正是这种设计,让PDF阅读器能够识别并响应我们的点击操作。
今天,我们就来聊聊如何用Python里的一个利器——pdfplumber库,把这些“藏”在PDF里的超链接给精准地“挖”出来。
pdfplumber这个库,专攻PDF文档解析。无论是文档的作者、创建时间这些基本信息,还是更复杂的表格、文本、图片,乃至我们今天的主角——超链接,它基本都能搞定,足以应对大多数常规的内容提取需求。
安装起来也毫不费力,一条pip命令就能搞定:
pip install pdfplumber
提取 pdf 中超链接详解
提取超链接,pdfplumber已经为我们准备好了现成的工具。每个页面对象都有一个.hyperlinks属性,调用它,就能直接获取当前页面上所有的超链接信息,返回的结果是一个字典列表,非常清晰。
来看一段基础代码。我们用pdfplumber打开一个名为“test.pdf”的文件,然后遍历每一页,通过.hyperlinks属性获取链接:
import pdfplumber


with pdfplumber.open(r'./data/test.pdf') as pdf_info:
    for page in pdf_info.pages:
        links = page.hyperlinks
    print(links)
运行之后,你会得到一个结构化的列表,里面包含了链接所在的页码、目标URI地址等关键信息。效果类似下图所示:
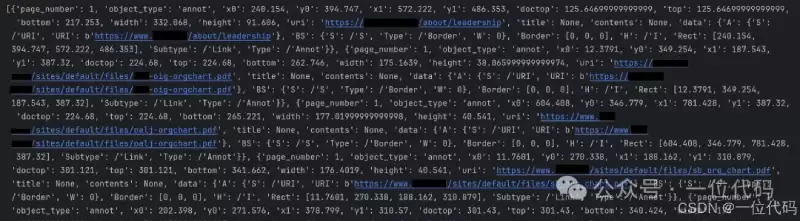
接下来,我们只需要从这个字典列表里,把我们需要的信息(比如URI)提取出来就行了。
下面是一个完整的函数示例。你只需要把文件路径换成你自己的PDF文件完整路径,运行后就能得到文档里所有页面的所有超链接。
import pdfplumber


def get_links(file_path):
    res_links = []
    with pdfplumber.open(file_path) as pdf_info:
        page_number = 0
        for page in pdf_info.pages:
            page_number += 1
            links = page.hyperlinks
            if links:
                for link in links:
                    res_link = link.get('uri')
                    res_links.append(res_link)
                print(f'第{page_number}页,共有{len(links)}个超链接!')
            else:
                print(f'第{page_number}页,不存在超链接!')
    return res_links


if __name__=="__main__":
    # 文件路径为 pdf 完整路径
    res_links = get_links('data/FCC_all.pdf')
    print(res_links)
当然,这只是提取PDF超链接的其中一种有效方法,供各位参考。
方法补充
基本用法:提取所有超链接
核心逻辑其实非常直观:打开PDF,循环遍历每一页,然后从页面的hyperlinks属性里取出uri(也就是目标网址)。
import pdfplumber
def extract_links(pdf_path):
    all_links = []
    with pdfplumber.open(pdf_path) as pdf:
        for page in pdf.pages:
            page_links = page.hyperlinks
            if page_links:
                for link in page_links:
                    # 每个 link 是一个字典,'uri' 键存储了目标网址
                    uri = link.get('uri')
                    if uri:
                        all_links.append(uri)
    return all_links
if __name__ == "__main__":
    links = extract_links("你的文件.pdf")
    for link in links:
        print(link)
如果你想更清楚地知道每个链接出自哪一页,可以在遍历时加上页码信息:
for i, page in enumerate(pdf.pages):
    links = page.hyperlinks
    if links:
        print(f"第 {i+1} 页 有 {len(links)} 个链接")
        for link in links:
            print(f"  - {link.get('uri')}")
    else:
        print(f"第 {i+1} 页 没有链接")
高级用法:灵活处理
处理其他类型的链接
需要留意的是,hyperlinks返回的字典里,不一定只有uri(网页链接)。它还可能包含指向PDF文档内部其他页面的链接(键为page),或者指向文档内某个命名目标的链接(键为nameddest)。区分处理它们能让你的脚本更健壮。
if 'uri' in link:
    print(f"网页链接: {link['uri']}")
elif 'page' in link:
    print(f"内部链接: 第 {link['page']} 页")
elif 'nameddest' in link:
    print(f"命名目标: {link['nameddest']}")
提取链接的链接文本(高级技巧)
有时候,我们不仅想知道链接指向哪里,还想知道这个链接在PDF里显示成什么文字(比如“点击这里”或“了解更多”)。pdfplumber本身没有直接提供这个功能,但我们可以通过一个“曲线救国”的方式来实现:利用页面的chars属性(它包含了页面上每个字符的详细信息,包括坐标)。基本思路是,先拿到链接的矩形区域坐标(x0, y0, x1, y1),然后筛选出所有落在这个区域内的字符,再把它们组合起来,就得到了链接文本。这涉及到一些坐标计算,但对于处理复杂文档来说,是个非常实用的技巧。
处理加密PDF
如果遇到加密的PDF文件也不用慌。pdfplumber.open()方法贴心地提供了password参数,传入密码即可正常打开并解析。
with pdfplumber.open("encrypted.pdf", password="你的密码") as pdf:
    # ... 正常提取链接
常见问题与注意事项
- 链接提取不到?这里有个关键概念:pdfplumber提取的是PDF标准中的“链接注释”。如果你的PDF里,网址是直接以纯文本形式写在内容里的(而不是可点击的链接对象),那么用文本搜索或正则表达式去匹配会更直接有效。
- 小心
CroppedPage相关的Bug:如果你对页面对象进行了裁剪操作,可能会遇到一些与CroppedPage相关的超链接提取Bug。万一碰到这种情况,可以尝试将pdfplumber更新到最新版本,或者更稳妥一点——直接在原始的、未经裁剪的Page对象上提取链接。 - 扫描版PDF无能为力:这一点必须明确:pdfplumber主要擅长处理计算机直接生成的PDF。如果你的PDF是扫描件(也就是一堆图片),那么库是无法直接从中提取超链接甚至文本的。这种场景下,你需要先借助OCR技术(比如
pytesseract这样的工具)把图片文字识别出来,再进行后续处理。











正软商城本月促销专区,汇集办公、设计、安全、影音、系统工具及AI软件等正版软件优惠活动,提供限时折扣、特价授权和优惠购买信息,活动库存及价格以页面实时展示为准。

正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

正软商城macOS软件专区,精选适用于Mac电脑的办公、设计、影音、效率、开发和系统工具,提供软件功能介绍、macOS兼容版本、正版授权及购买下载服务。

正软商城iOS软件专区,精选适用于iPhone和iPad的办公、学习、影音、设计、效率及AI应用,提供功能介绍、适用设备、系统要求和正版获取方式等信息。

正软商城AI软件专区,汇集AI写作、AI绘画、AI视频、AI办公、AI编程、AI翻译、智能客服和数据分析等人工智能工具,提供功能介绍、适用平台、收费方式及正版购买信息。

正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。




一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。


CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。



极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

一款文字处理软件,一种订阅式的跨平台办公软件,基于云平台提供多种服务,通过将 Excel 和 Outlook 等应用与 OneDrive 和 Microsoft Teams 等强大的云服务相结合,Office 365 可让任何人使用任何设备随时随地创建和共享内容。

Wise Folder Hider Pro 是一款专业级文件和文件夹隐藏加密软件,为私密数据添加多重保护。高频操作更强调就近处理,浏览、整理和跨目录移动文件时,来回切换和重复点击都会少很多。
CodeExpander 是一款快捷短语输入增强工具,通过键入缩写自动展开为自定义文段,提升工作效率。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。

Mountain Duck 是一款能将多个网盘挂载到本地的工具,像本地磁盘一样使用网盘。清理链路的完整性会更好一些,做应用卸载、残留处理和空间整理时,通常能少走很多手动排查步骤。
