


A800威力超群,比Llama2的RTX3090和4090具有更高的延迟吞吐量
大型语言模型(LLM)在学界和业界都取得了巨大的进展。但训练和部署LLM非常昂贵,需要大量的计算资源和内存,因此研究人员开发了许多用于加速LLM预训练、微调和推理的开源框架和方法。然而,不同硬件和软件堆栈的运行时性能可能存在很大差异,这使得选择最佳配置变得困难。最近,一篇题为《DissectingtheRuntimePerformanceoftheTraining,Fine-tuning,andInferenceofLargeLanguageModels》的新论文从宏观和微观的角度详细分析了LLM训练、微
大型语言模型 (LLM) 在学界和业界都取得了巨大的进展。但训练和部署 LLM 非常昂贵,需要大量的计算资源和内存,因此研究人员开发了许多用于加速 LLM 预训练、微调和推理的开源框架和方法。然而,不同硬件和软件堆栈的运行时性能可能存在很大差异,这使得选择最佳配置变得困难。
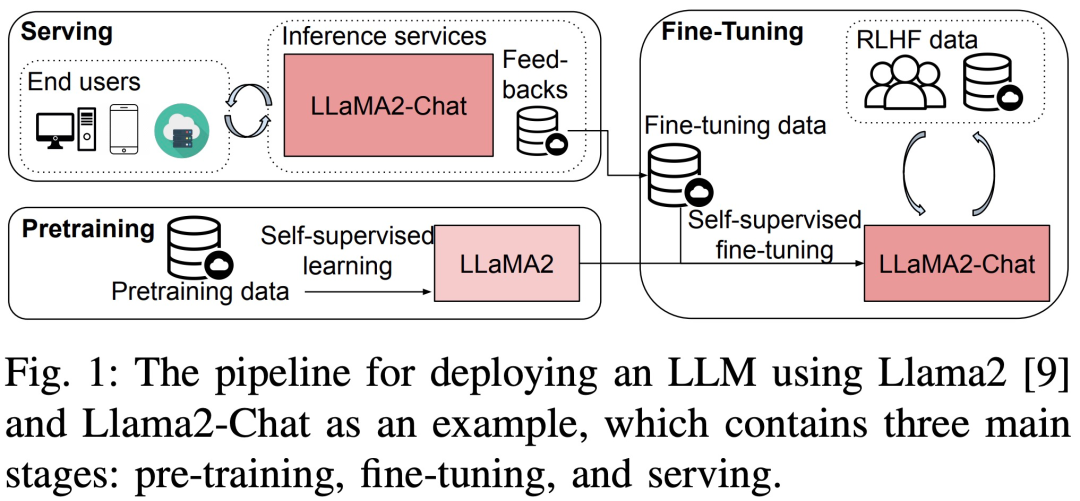
最近,一篇题为《Dissecting the Runtime Performance of the Training, Fine-tuning, and Inference of Large Language Models》的新论文从宏观和微观的角度详细分析了 LLM 训练、微调、推理的运行时性能。
请点击以下链接查看论文:https://arxiv.org/pdf/2311.03687.pdf
具体来说,这项研究首先在三个8-GPU上对不同规模(7B、13B和70B参数)的LLM进行了面向预训练、微调和服务的无需改变原义,全程性能基准测试。测试涉及了具有或不具有单独优化技术的平台,包括ZeRO、量化、重新计算和FlashAttention。然后,该研究进一步提供了LLM中计算和通信运算符的子模块的详细运行时分析
方法介绍
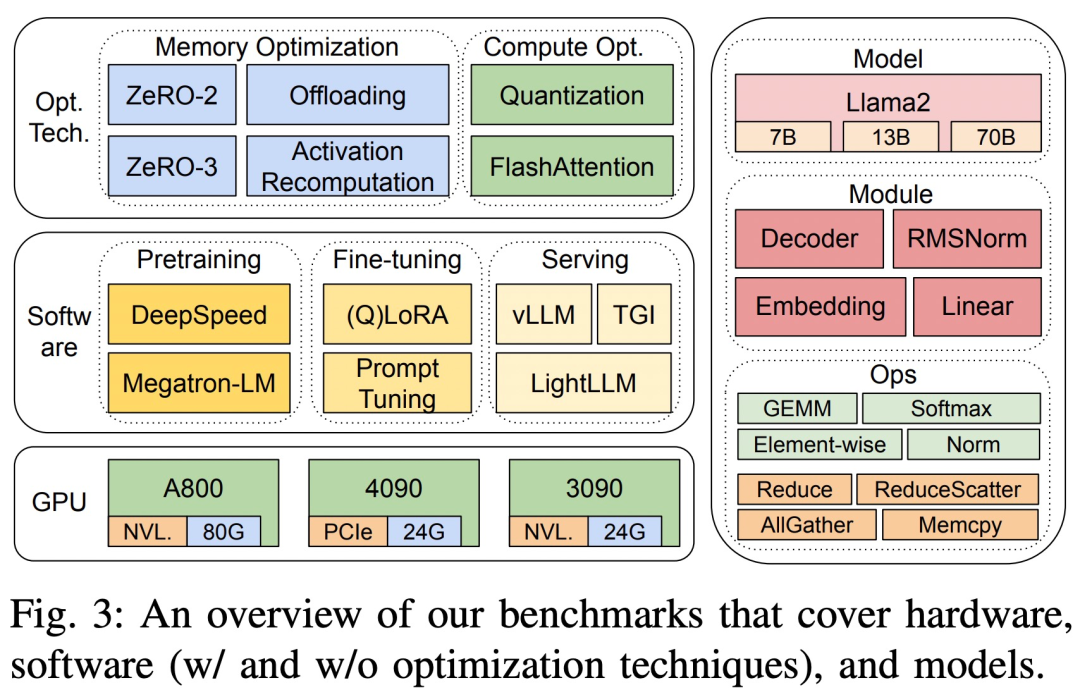
该研究的基准测试采用自上而下的方法,涵盖 Llama2 在三个 8-GPU 硬件平台上的端到端步骤时间性能、模块级时间性能和运算符时间性能,如图 3 所示。
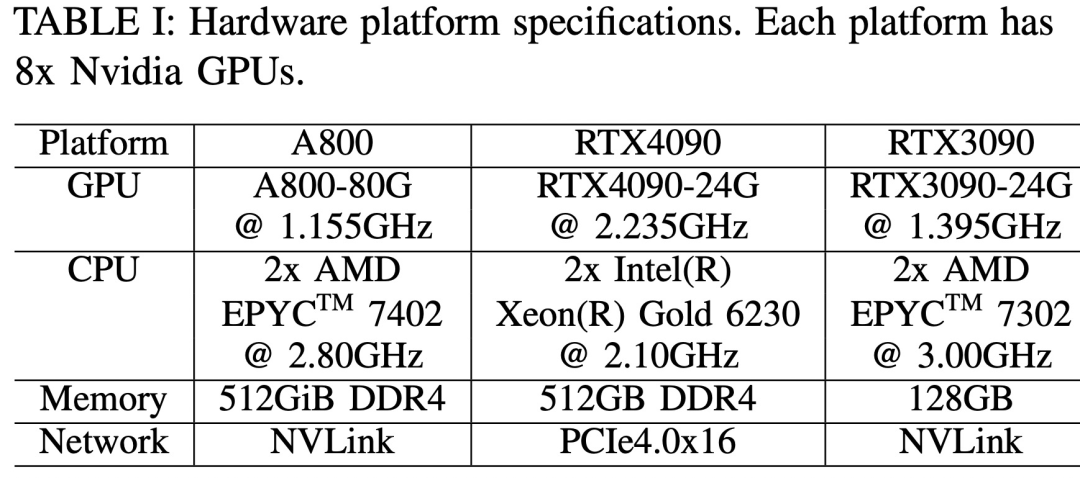
三个硬件平台分别为 RTX4090、RTX3090 和 A800,具体规格参数如下表 1 所示。
在软件方面,该研究比较了 DeepSpeed 和 Megatron-LM 在预训练和微调方面的端到端步骤时间。为了评估优化技术,该研究使用 DeepSpeed 逐一启用如下优化:ZeRO-2、ZeRO-3、offloading、激活重计算、量化和 FlashAttention,以衡量性能改进以及时间和内存消耗方面的下降。
在 LLM 服务方面,存在三个高度优化的系统,vLLM、LightLLM 和 TGI,该研究在三个测试平台上比较了它们的性能(延迟和吞吐量)。
为了保证结果的准确性和可重复性,该研究计算了 LLM 常用数据集 alpaca 的指令、输入和输出的平均长度,即每个样本 350 个 token,并随机生成字符串以达到 350 的序列长度。
在推理服务中,为了综合利用计算资源并评估框架的鲁棒性和效率,所有请求都以突发模式调度。实验数据集由 1000 个合成句子组成,每个句子包含 512 个输入token。该研究在同一 GPU 平台上的所有实验中始终保持「最大生成 token 长度」参数,以保证结果的一致性和可比性。
无需改变原义,全程性能
该研究通过预训练、微调和推理不同尺寸 Llama2 模型(7B、13B 和 70B)的步骤时间、吞吐量和内存消耗等指标,来衡量在三个测试平台上的无需改变原义,全程性能。同时评估了三个广泛使用的推理服务系统:TGI、vLLM 和 LightLLM,并重点关注了延迟、吞吐量和内存消耗等指标。
模块级性能
LLM 通常由一系列模块(或层)组成,这些模块可能具有独特的计算和通信特性。例如,构成 Llama2 模型的关键模块是 Embedding、LlamaDecoderLayer、Linear、SiLUActivation 和 LlamaRMSNorm。
预训练结果
在预训练实验环节,研究者首先分析了三个测试平台上不同尺寸模型(7B、13B 和 70B)的预训练性能(迭代时间或吞吐量、内存消耗),然后进行了模块和操作层面的微基准测试。
无需改变原义,全程性能
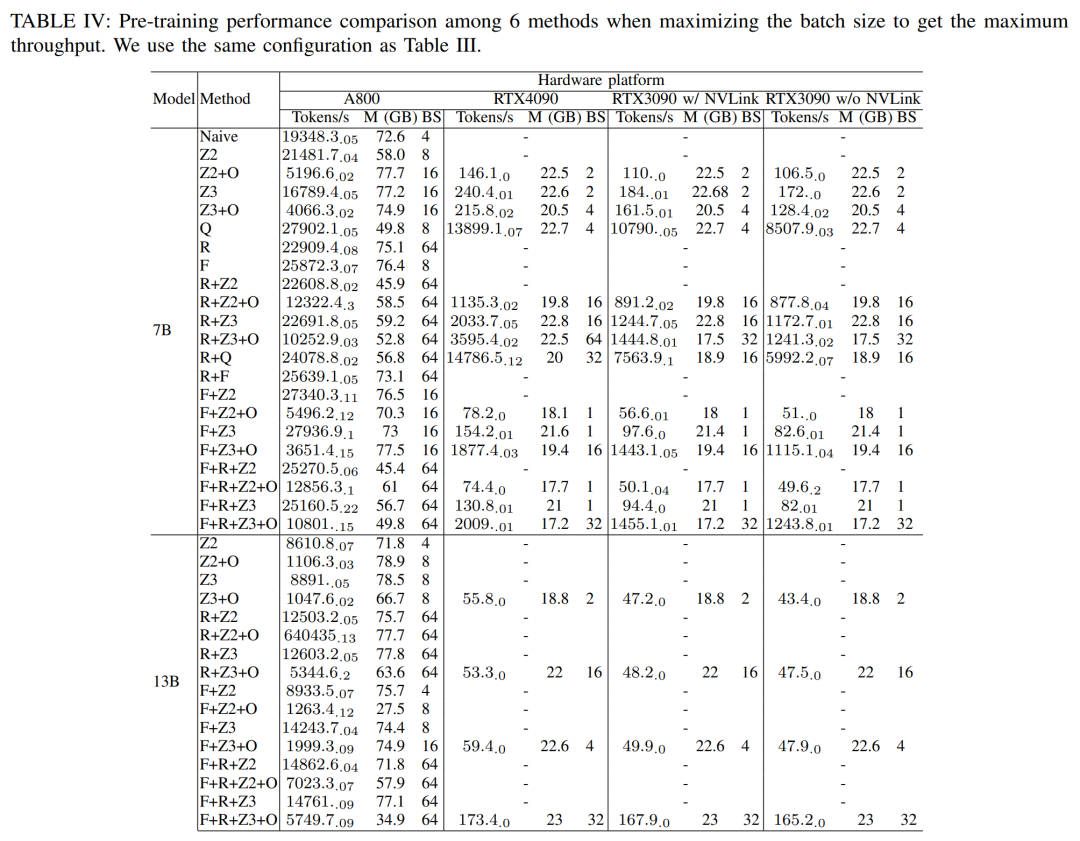
研究者首先进行实验来比较 Megatron-LM 和 DeepSpeed 的性能,二者在 A800- 80GB 服务器上预训练 Llama2-7B 时没有使用任何内存优化技术(比如 ZeRO)。
他们使用的序列长度为 350,并为 Megatron-LM 和 DeepSpeed 提供了两组批大小,从 1 到最大批大小。结果如下表 II 所示,以训练吞吐量(tokens / 秒)和消费级 GPU 内存(单位 GB)为基准。
结果表明,当批大小都为 1 时,Megatron-LM 稍快于 DeepSpeed。不过当批大小达到最大时,DeepSpeed 在训练速度上最快。当批大小相同时,DeepSpeed 消耗了比基于张量并行的 Megatron-LM 更多的 GPU 内存。即使批大小很小,这两个系统都消耗了大量的 GPU 内存,导致 RTX4090 或 RTX3090 GPU 服务器的内存溢出。
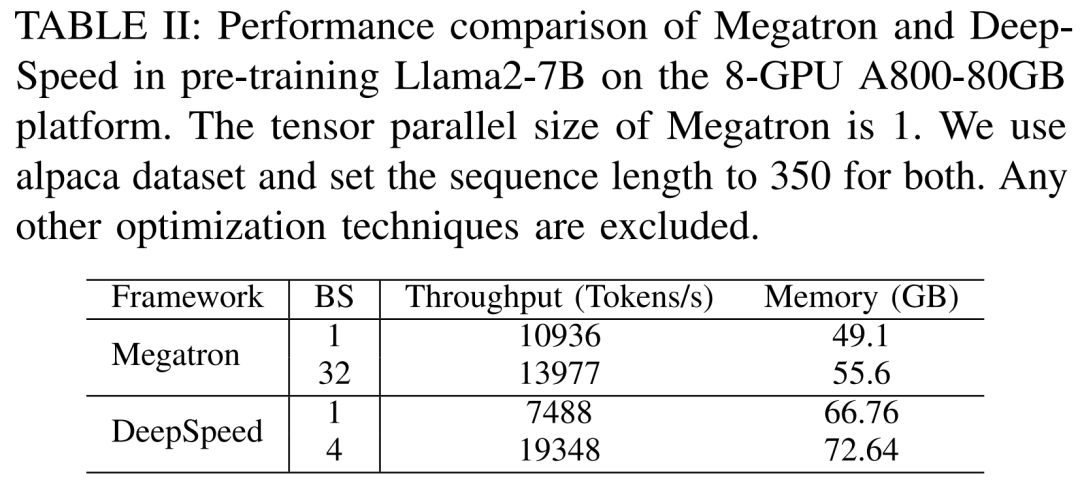
在训练 Llama2-7B(序列长度为 350,批大小为 2)时,研究者使用了带有量化的 DeepSpeed 来研究不同硬件平台上的扩展效率。结果如下图 4 所示,A800 几乎是线性扩展,RTX4090 和 RTX3090 的扩展效率略低,分别为 90.8% 和 85.9%。在 RTX3090 平台上,NVLink 连接比没有 NVLink 时的扩展效率提升了 10%。
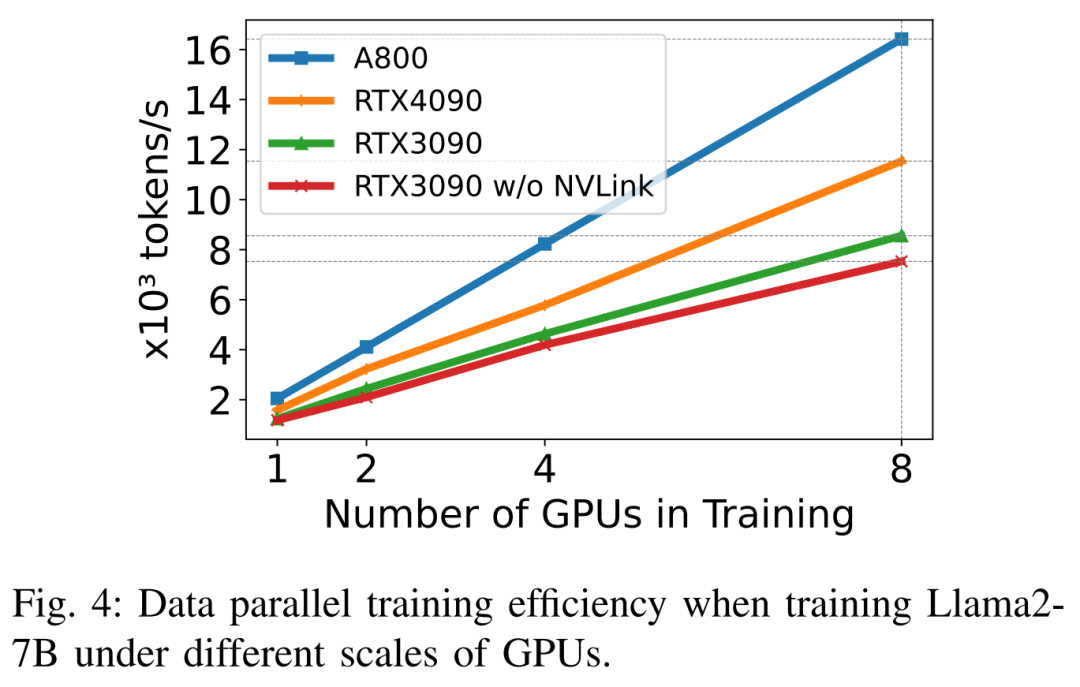
研究者使用 DeepSpeed 来评估不同内存和计算高效方法下的训练性能。为公平起见,所有评估设置成序列长度为 350,批大小为 1,默认加载模型权重为 bf16。
对于具有卸载功能的 ZeRO-2 和 ZeRO-3,他们分别将优化器状态和优化器状态 + 模型卸载到 CPU RAM。对于量化,他们使用了具有双重量化的 4bits 配置。此外报告了 NVLink 失效时 RTX3090 的性能(即所有数据通过 PCIe 总线传输)。结果如下表 III 所示。
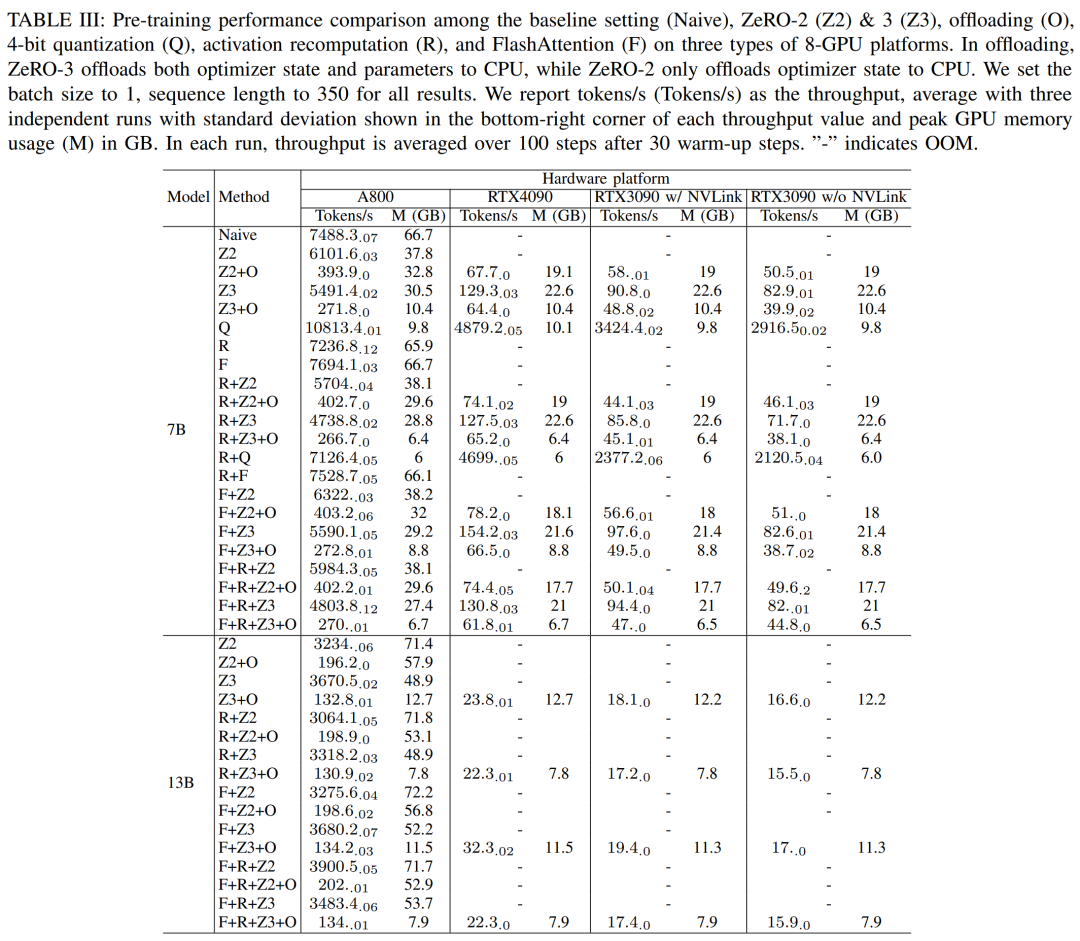
為了獲得最大吞吐量,研究人員通過最大化每種方法的批大小,進一步利用不同的GPU服務器的計算能力。結果如表IV所示,表明增加批大小可以輕鬆改進訓練過程。因此,具有高帶寬和大內存的GPU服務器比消費級GPU服務器更適合進行全參數混合精度訓練
模块级分析
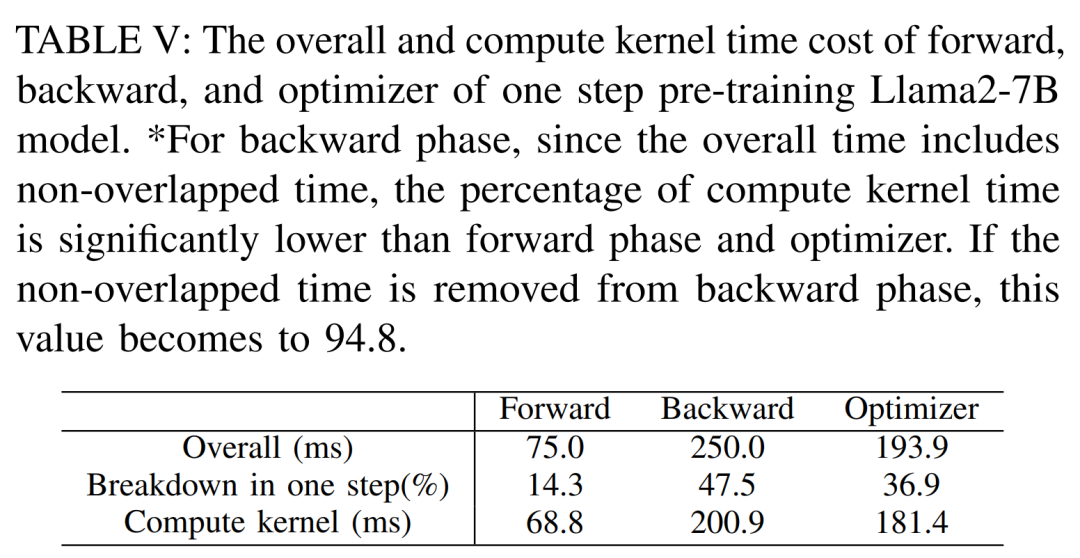
下表 V 展示了单步预训练 Llama2-7B 模型的前向、后向和优化器的整体及计算核心时间成本。对于后向阶段,由于总时间包含了非重叠时间,计算核心时间远远小于前向阶段和优化器。如果非重叠时间从后向阶段中移除,该值变成 94.8。
需要进行重新计算和重新评估 FlashAttention 的影响
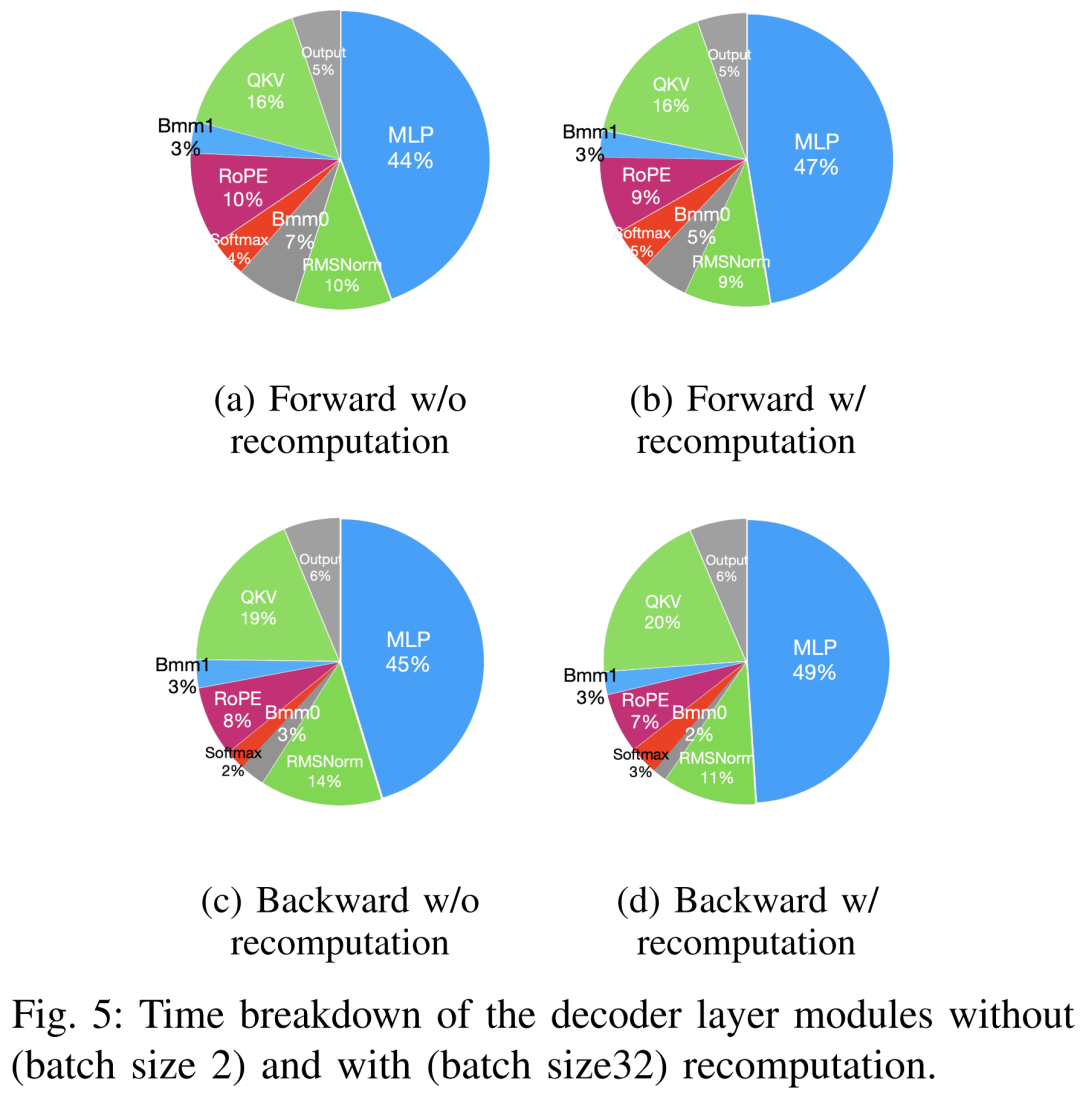
加速预训练的技术大致可以分为两类:节省内存增加批大小、加速计算核心。如下图 5 所示,GPU 在前向、后向和优化器阶段有 5-10% 的时间处于闲置状态。
研究人员相信这种空闲时间是由于较小的批次大小所造成的,因此他们测试了可使用的最大批次大小的所有技术。最终,他们采用重计算来增加批次大小,并利用FlashAttention来加速计算核心分析
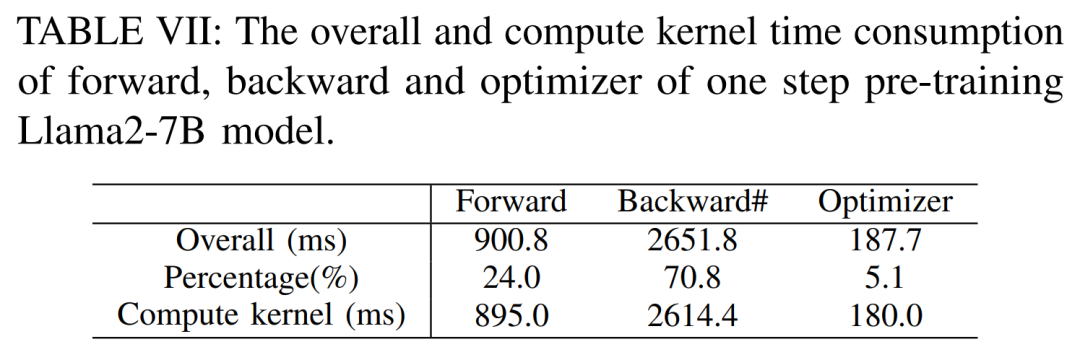
如下表 VII 所示,随着批大小的增加,前向和后向阶段的时间大幅增加,GPU 闲置时间几乎没有。
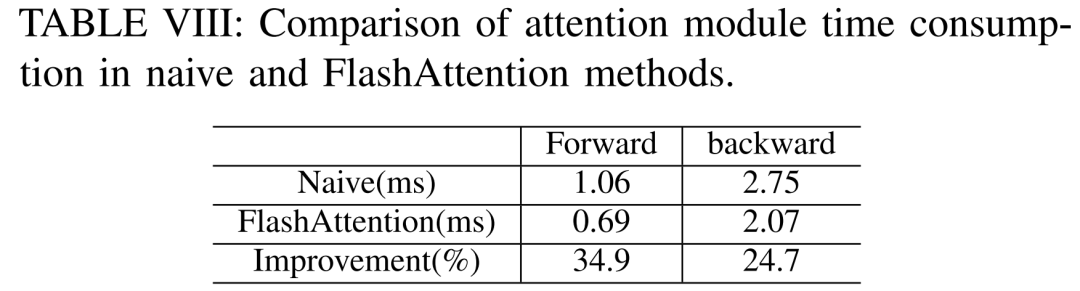
根据下表 VIII 可见,FlashAttention 分别能够加速前向和后向的注意力模块 34.9% 和 24.7%
微调结果
在微调环节,研究者主要讨论参数高效微调方法(PEFT),展示 LoRA 和 QLoRA 在各种模型大小和硬件设置下的微调性能。使用序列长度为 350,批大小为 1,默认将模型权重加载到 bf16。
根据下表 IX 的结果,使用 LoRA 和 QLoRA 对 Llama2-13B 进行微调后的性能趋势与 Llama2-7B 保持一致。与 Llama2-7B 相比,微调后的 Llama2-13B 的吞吐量下降了约30%
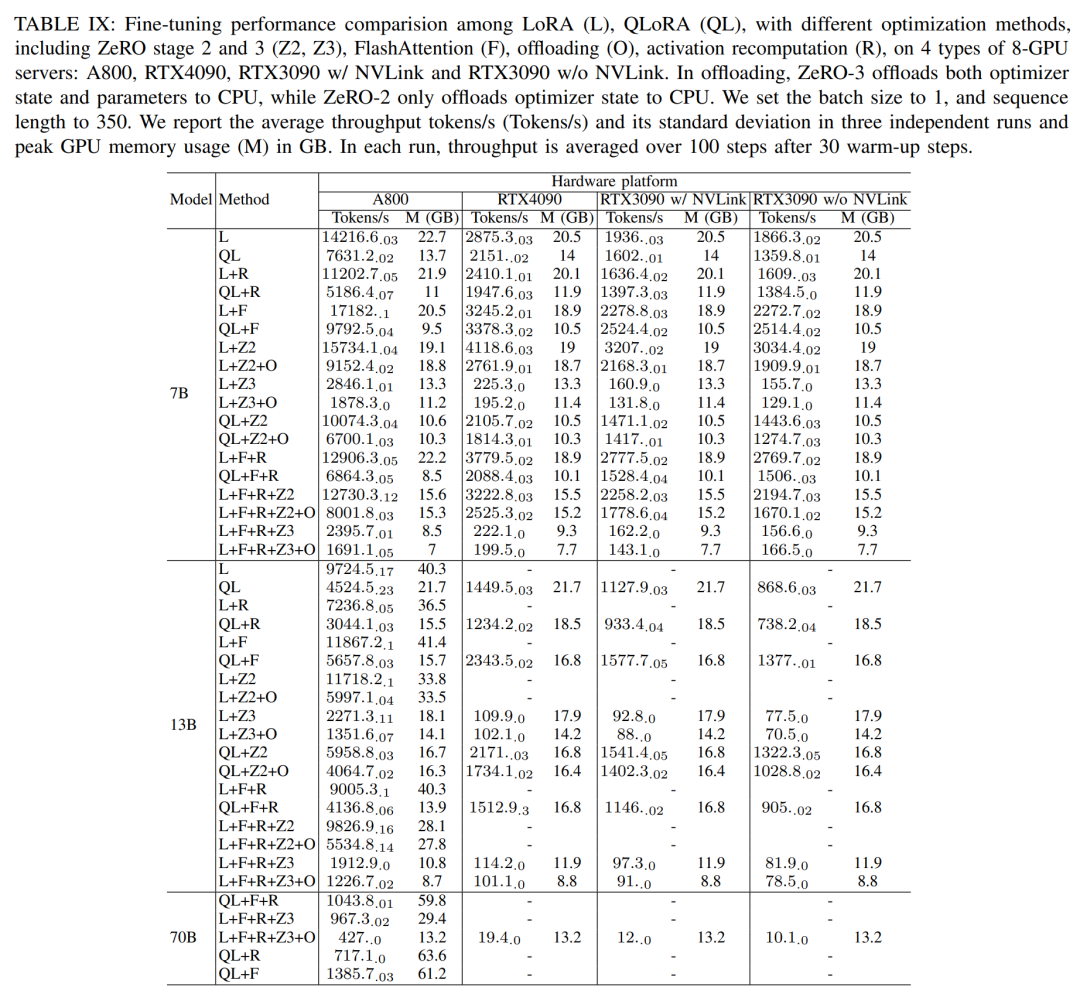
不过当结合所有优化技术时,即使 RTX4090 和 RTX3090 也可以微调 Llama2-70B,实现 200 tokens / 秒的总吞吐量。
推理结果
无需改变原义,全程性能
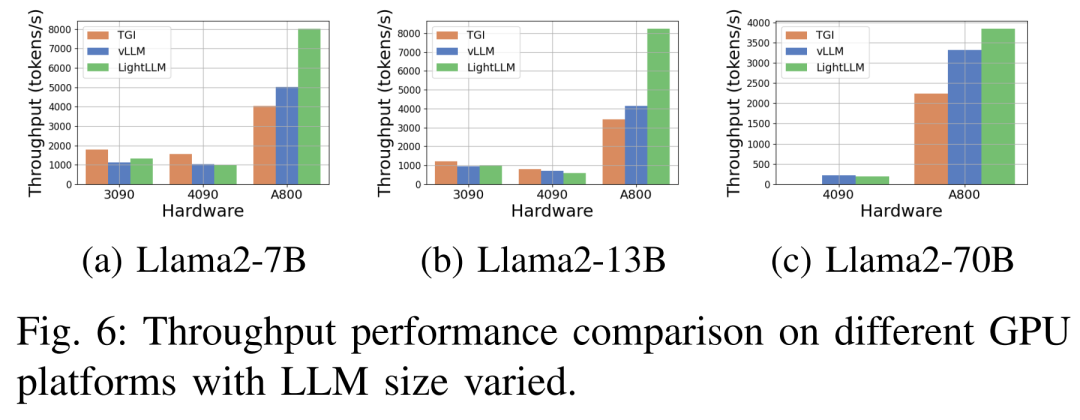
下图 6 显示了各种硬件平台和推理框架下吞吐量的全面分析,其中省略了 Llama2-70B 的相关推理数据。其中 TGI 框架展现了卓越的吞吐量,尤其是 RTX3090 和 RTX4090 等具有 24GB 内存的 GPU。此外 LightLLM 在 A800 GPU 平台上的性能显著优于 TGI 和 vLLM,吞吐量几乎翻倍。
这些实验结果表明,TGI 推理框架在 24GB 内存 GPU 平台上具有卓越的性能,而 LightLLM 推理框架在 A800 80GB GPU 平台上表现出最高的吞吐量。这一发现表明 LightLLM 专门针对 A800/A100 系列高性能 GPU 进行了优化。
延迟表现在不同的硬件平台和推理框架下如图7、8、9、10所示
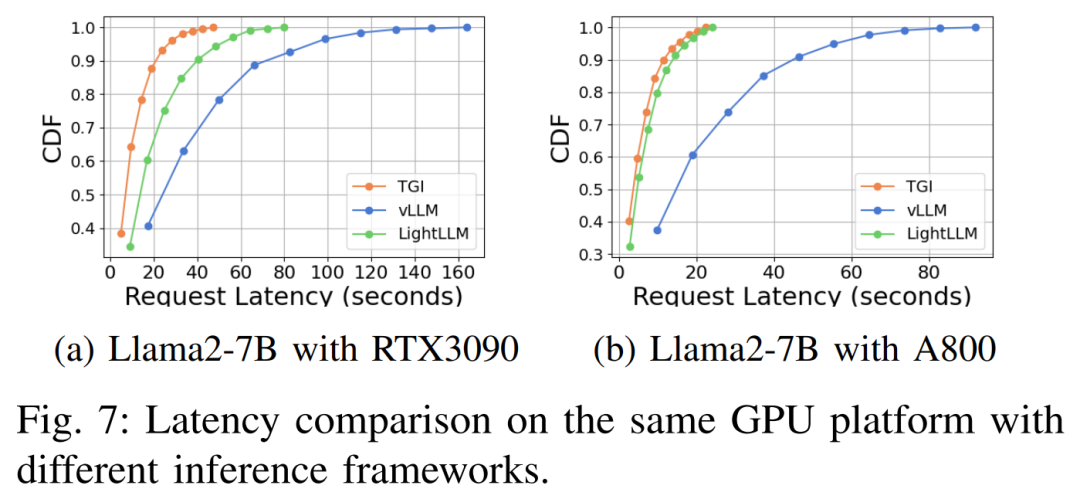
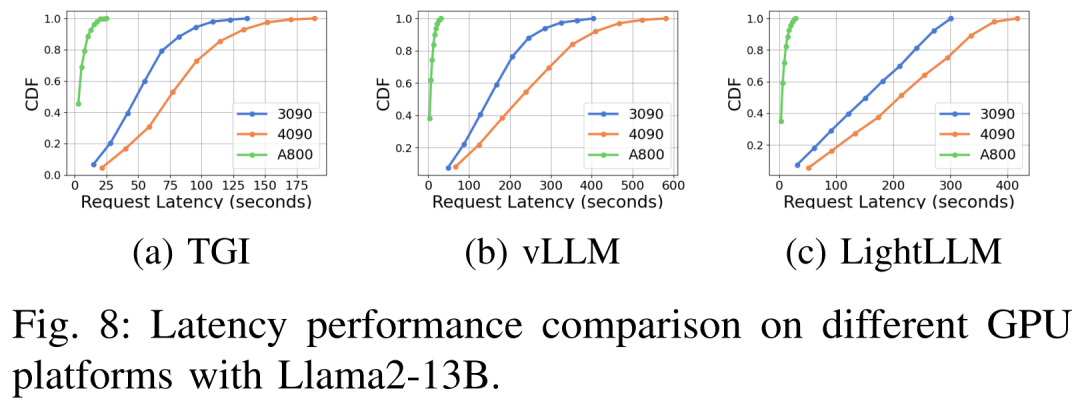
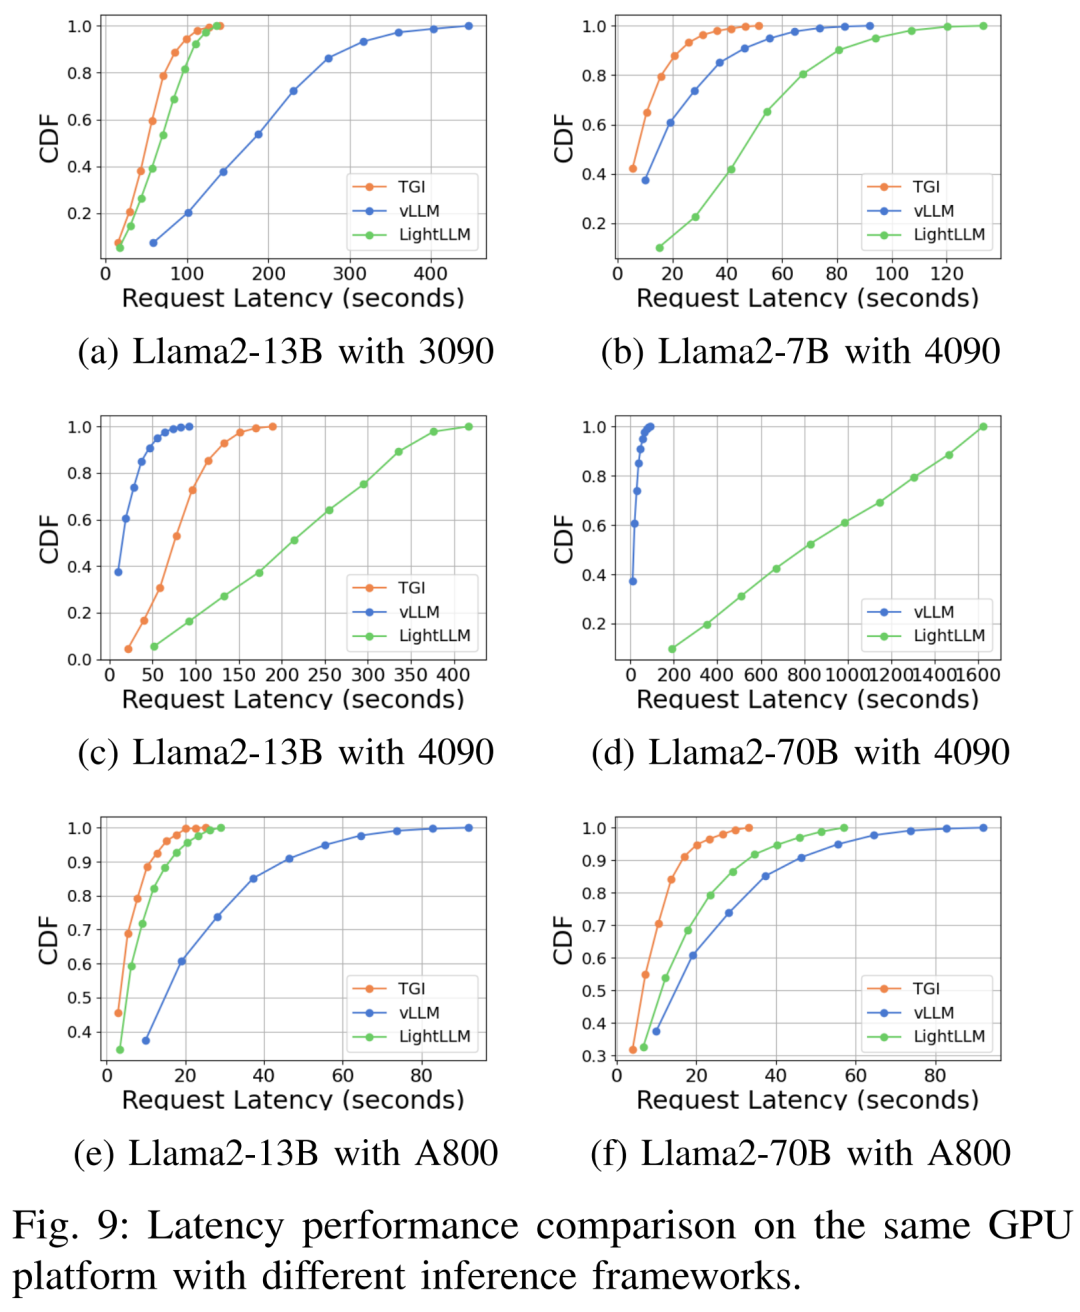
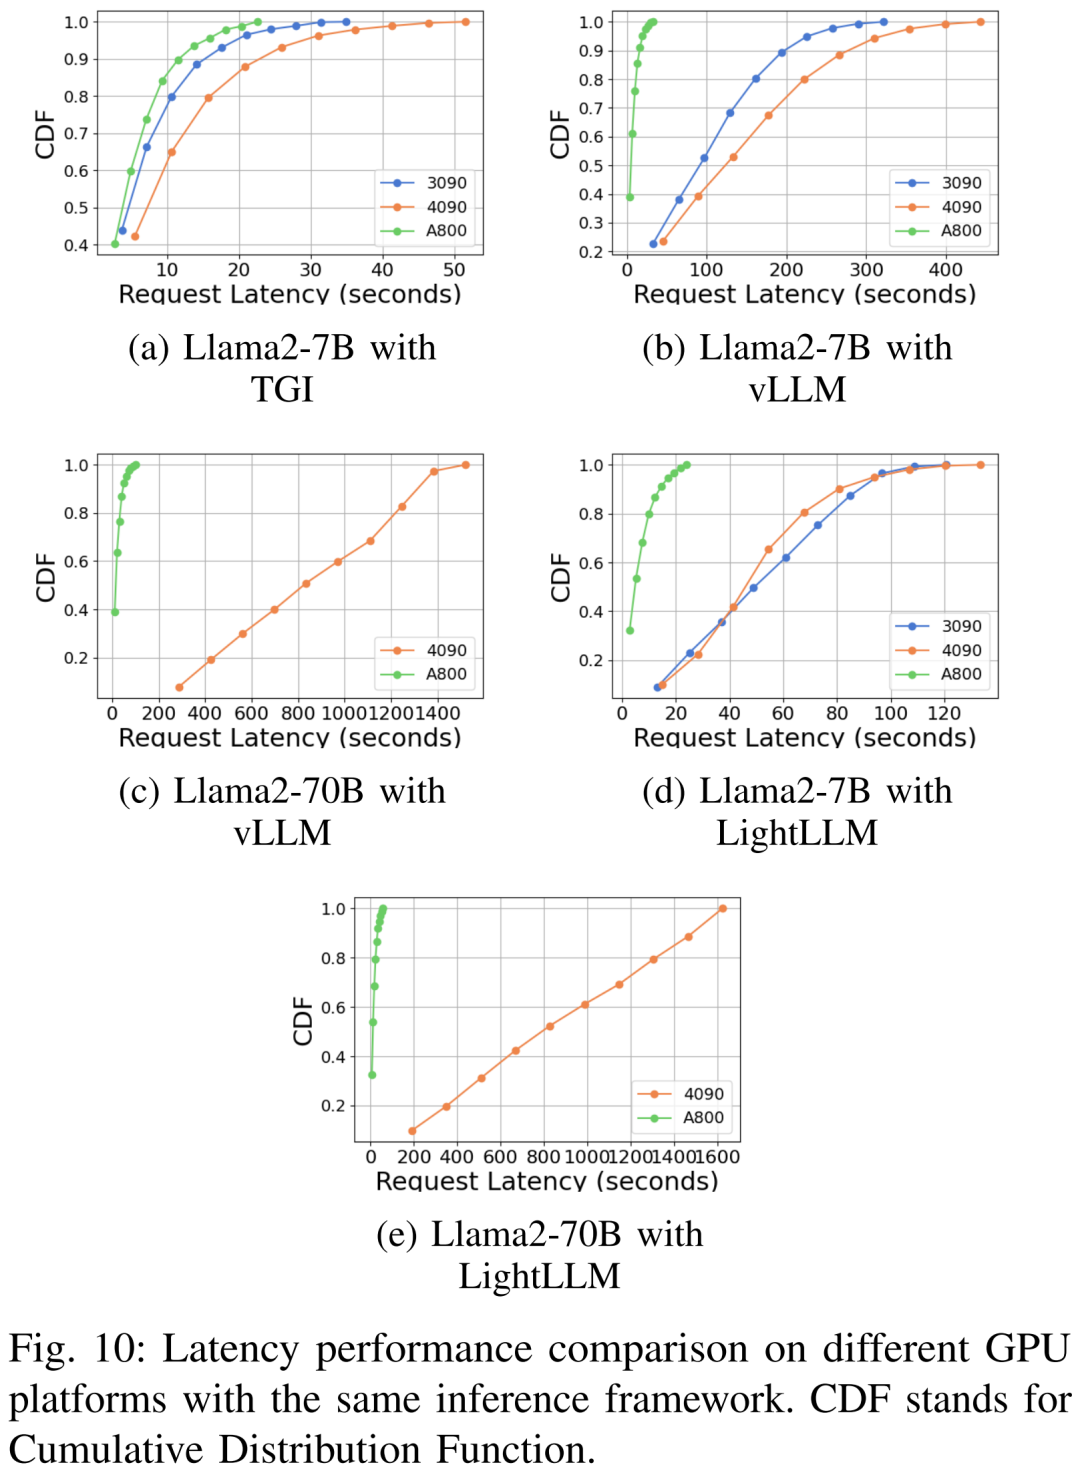
综上所示,A800 平台在吞吐量和延迟方面均显著优于 RTX4090 和 RTX3090 两款消费级平台。并且在两款消费级平台中,RTX3090 比 RTX4090 略有优势。当在消费级平台上运行时,TGI、vLLM 和 LightLLM 三个推理框架在吞吐量方面没有表现出实质性差异。相比之下,TGI 在延迟方面始终优于其他两个。在 A800 GPU 平台上,LightLLM 在吞吐量方面表现最好,其延迟也非常接近 TGI 框架。
请参考原文以获取更多实验结果








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。