


PillarNEst:如何进一步优化基于Pillar的3D目标检测性能?
写在前面&&笔者的个人理解在自动驾驶领域,一辆自动驾驶汽车通常配备多种传感器,例如激光雷达传感器用于采集点云数据,相机传感器用于采集图像数据等。由于激光雷达传感器能够更准确地获取待检测物体的几何和位置信息,因此基于点云的感知算法模型得以迅速迭代和发展。目前,基于点云的感知算法主要分为以下两大类一类是基于Voxel-based的感知算法,如经典的SECOND、VoxelNet等算法。Voxel-based的算法模型首先会将输入的点云数据转换成3D的体素结构表示,然后利用3D的卷积算法模型实现后续的特征提取,
写在前面 && 笔者的个人理解
在自动驾驶领域,一辆自动驾驶汽车通常配备多种传感器,例如激光雷达传感器用于采集点云数据,相机传感器用于采集图像数据等。由于激光雷达传感器能够更准确地获取待检测物体的几何和位置信息,因此基于点云的感知算法模型得以迅速迭代和发展。目前,基于点云的感知算法主要分为以下两大类
- 一类是基于Voxel-based的感知算法,如经典的SECOND、VoxelNet等算法。Voxel-based的算法模型首先会将输入的点云数据转换成3D的体素结构表示,然后利用3D的卷积算法模型实现后续的特征提取,将提取后的3D特征送入到后续的模块当中。
- 另外一类是基于Pillar-based的感知算法,如经典的PointPillar、PillaNext、PillarNet等算法。Pillar-based的算法模型并不依赖3D的卷积网络来获取点云特征,而是直接将点云数据构建成柱状的数据从而实现更快的检测速度,方便后续的上车部署等任务。
尽管目前广泛采用基于Pillar的算法模型,因为其部署方便、精度高,但是目前这些模型主要使用随机初始化的方法对2D卷积神经网络进行初始化。这导致很多在ImageNet上预训练的2D主干网络并没有被有效利用,造成资源浪费。另外,目前来看,基于点云的感知算法模型尺寸放大并没有导致精度上升的现象。而在2D检测任务中,预训练的主干网络和更大尺寸的主干网络在大规模数据集上都展现出更好的优势
所以,今天解析的这篇论文就是要探索2D主干网络的规模大小和预训练对于Pillar-based的3D目标检测器的性能影响。
以下是论文的arxiv链接:https://arxiv.org/pdf/2311.17770.pdf
PillarNeSt的算法解析
首先,让我们来介绍PillarNeSt算法模型的整体框架结构,如下图所示
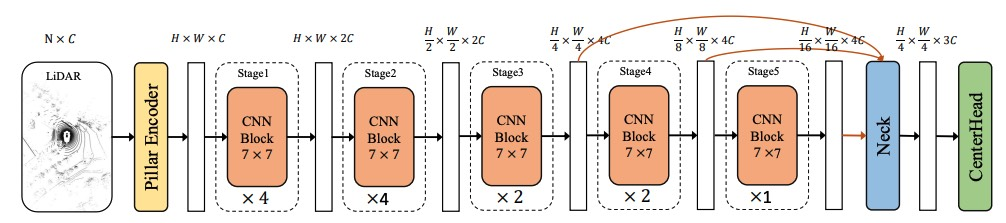 PillarNeSt算法模型的网络框图
通过观察上图可知,PillarNeSt采用了点云感知算法中经典的架构模型(CenterPoint-Pillars)作为基线模型。然而,为了构建一个更强大的基线模型,论文作者对原有的PointPillars算法进行了修改。为了使读者更清楚地了解每个部分的修改位置,首先简单列举了CenterPoint-Pillars算法模型的几个基础模块
- 点云的伪图像表示:利用Pillar Encoder模块完成原始输入到模型中的点云数据向伪图像格式的表示
- 2D的主干网络完成伪图像的特征提取
- 利用Neck模块融合2D主干网络提取出来的多尺度特征图
- 利用3D检测头(CenerHead)输出最终的3D检测结果
- 根据损失函数计算损失loss,利用反向传播代码更新网络的参数值
接下来,我们将根据前面提到的每个基础模块,逐步进行修改和增强,最终构建出PillarNeSt算法模型
Pillar Encoder
在CenterPoint-Pillars算法模型的原始版本中,Pillar Encoder模块首先使用多层感知机结构提取点云数据的特征,然后采用Max Pooling层提取Pillar特征。然而,在本文中,作者认为只使用Max Pooling层会导致信息的丧失。基于此,作者在原有的Max Pooling层基础上添加了一个Mean Pooling层,以获取更多有用的信息。此外,作者还引入了每个点相对于几何中心高度的偏移量作为模块的输入,以补偿在Z轴上的信息丢失
“
在这篇论文中,我们同时使用最大池化和平均池化来保留更多的信息。此外,我们还引入了点的高度偏移,相对于几何中心的输入,以补偿在z轴上的信息损失
“
2D Backbone的重新设计
- 采用更大尺寸的卷积核
论文的作者提出,在2D图像领域中,通过增加网络模型的层数或者是深度,模型的有效感受野大小并没有得到有效的增加。而针对Pillar-based的算法模型也需要对伪图像点云数据进行特征提取。受到最近几篇Large-Kernel工作的启发,作者认为通过使用更大的卷积核可以使模型的有效感受野(ERF)增加,从而增加基于点云的感知算法的检测性能。同时,论文的作者为了平衡好模型速度和精度二者之间的关系,在本文中,采用了卷积核大小为7x7的深度可分离卷积层。
一些最近的研究认为,通过使用更大的卷积核可以有效地实现较大的有效感受野。此外,更大的感受野有助于提高点云检测器的能力
- 在第一层移除下采样操作
论文的作者考虑到图像当中有很多像素的信息都是存在冗余的,而常见的2D主干网络通常都会包括步长为2的卷积层对提取的图像特征进行下采样操作,从而降低后续卷积操作的运算成本。
但是对于点云信息而言却有所不同,由于原始的点云数据是稀疏而且是不规则的,而且包含了物体非常丰富的几何和结构信息。但是如果过早的应用下采样层就会导致点云中关键信息的损失。论文的作者基于这些考虑,在新设计的算法模型当中,删除了在第一个层存在的下采样层,从而保证了输入到后续层的分辨率,保存了输入数据的有效信息。
我们的骨干网络设计去除了干扰因素,并避免在第一阶段块中进行下采样。这个战略选择确保了输入特征的原始分辨率的保持
- 模型早期添加更多的block
作者指出,针对2D图像领域而言,通常都会在网络模型的后面几层堆叠更多的block来提取更抽象的语义特征,从而获取更加丰富的语义表达。但是考虑到点云数据是不规则同时也是稀疏的特点,这就意味着应该在模型的早期堆叠更多的block来完全提取出点云中包含的数据信息。作者也在论文中提到,通过实验结果也可以得出类似的结论,与在主干网络的后期堆叠block相比,在主干网络的前几层堆叠block可以获得更高的检测结果收益。
我们的大量实验表明,在早期阶段增加块的数量比在后期阶段增加更多块的效果更好
- 更深层次的层
论文的作者通过对点云的场景进行分析认为,不同物体的尺寸大小变化是非常巨大的。在针对Pillar-based的算法中而言,当Pillar的的尺寸设置为0.2m时,8倍的下采样后最大可感知范围为1.6m。然而,现实场景中的许多对象超过了有限的可感知范围。这意味着8倍下采样后的特征点不能完全感知大物体的整个物体。
基于此,作者采用了一种简单易行的方法来缓解这个问题,在主干网络第四层的输出基础上,额外再添加一层并标记为第五层。第五层模块包含的模块数量可以根据模型的规模进行扩展。
we adopt a simple way and add one more stage (named stage-5) on top of stage-4, which contains only one or two ConNeXt blocks. The block number of stage-5 can be scaled up based on the model size. The output of added stage-5 is served as one of the multi-scale inputs of the neck network.
主干网络缩放
在本文中,论文的一个重要目标是设计出一组可调整的网络结构模型,以在参数量和精度之间取得平衡。作者提出了一系列2D主干网络,从PillarNeSt-Tiny到PillarNeSt-Large,以满足不同参数量和精度的需求。下图展示了不同尺度的网络模型配置
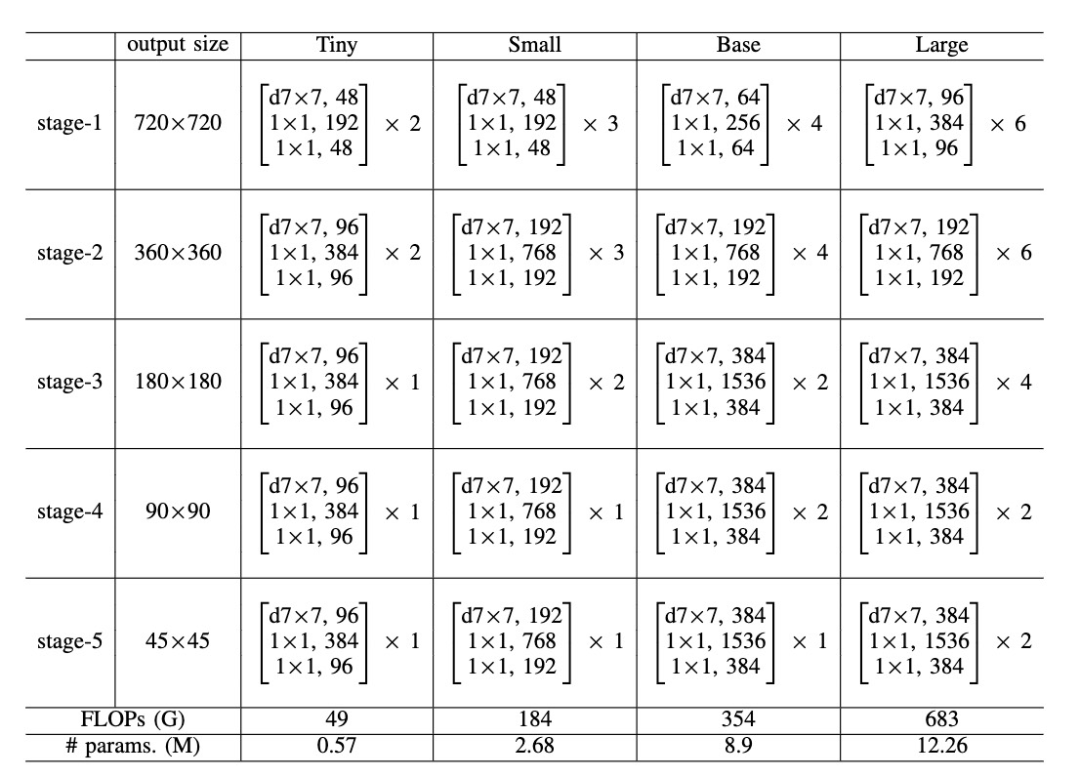 不同PillarNeSt模型的参数配置情况
通过上图可以看出,不同版本的模型共用相似的模型结构。每个模型包括五层结构,上文已经提到过的第一层去掉了降采样层,对于剩余的其他层都会进行降采样的操作
在论文中,还为不同规模的主干网络模型提供了更加简便的表示方法,如下图所示
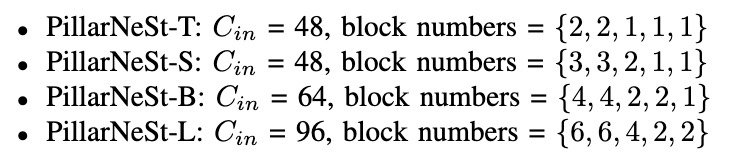
对于不同的PillarNeSt模型,进行通道数和block数的统计
主干网络预训练
为了达到作者的另一个目标,即利用在ImageNet上预训练的2D主干网络的优势,同时论文中的主干网络是基于ConvNeXt进行修改的,因此无法直接将原有的在ImageNet上预训练的ConvNeXt迁移到新设计的网络结构上。为此,论文采用了两种参数初始化方法,分别是基于stage view和micro view的初始化方法
- stage view
直接简单地从预训练的ConvNeXt模型中复制权重,用于用于Stage1-4,而添加的最后层(Stage-5)进行随机的初始化。对于Stage1-4,如果块数小于ConvNeXt的块数,我们只根据块标识复制相应块的参数 - micro view
从预训练的ConvNeXt模型的前Cin个通道复制训练好的参数,而对于剩余的通道则采用随机初始化的方式赋值参数
实验部分
在nuScenes和Argoverse2数据集上对PillarNeSt算法模型进行了有效性测试。首先,我们展示了在nuScenes数据集上的结果
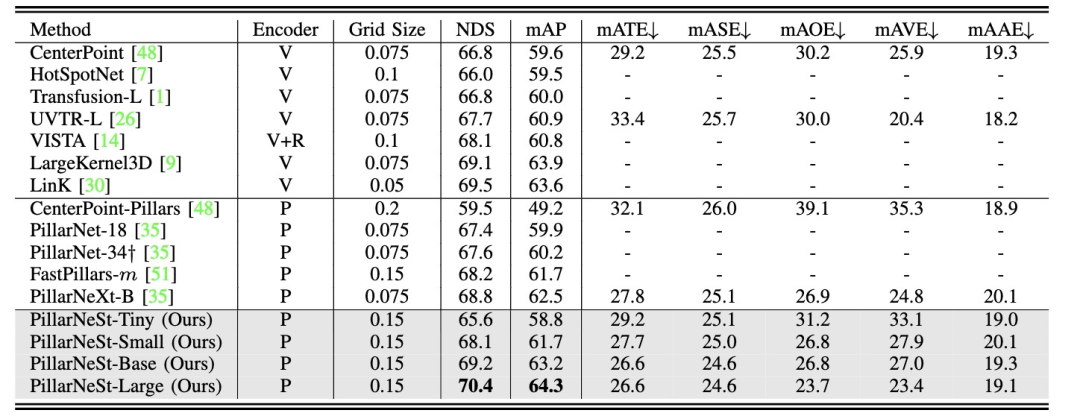
根据实验结果显示,PillarNeSt-Large算法模型在最大参数量下实现了64.3的mAP,相比其他基于点云的感知算法模型,取得了显著的优势
在Argoverse2数据集中,PillarNeSt的性能表现依然出色,除了在nuScenes数据集上的对比结果之外
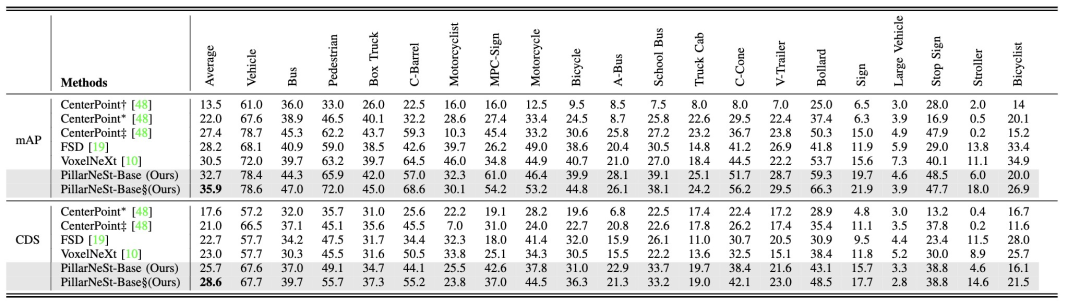
从表格结果可以看出,PillarNeSt-Base算法模型在mAP和CDS指标上表现出最优的检测性能,明显优于其他基于点云的感知算法模型
通过上述实验结果表格,清楚地展示了该方法成功实现了一组可扩展的网络结构。根据具体情况,可以选择不同参数量的算法模型以获得不同的精度效果。针对论文中提出的预训练问题,同样提供了下图所示的实验结果
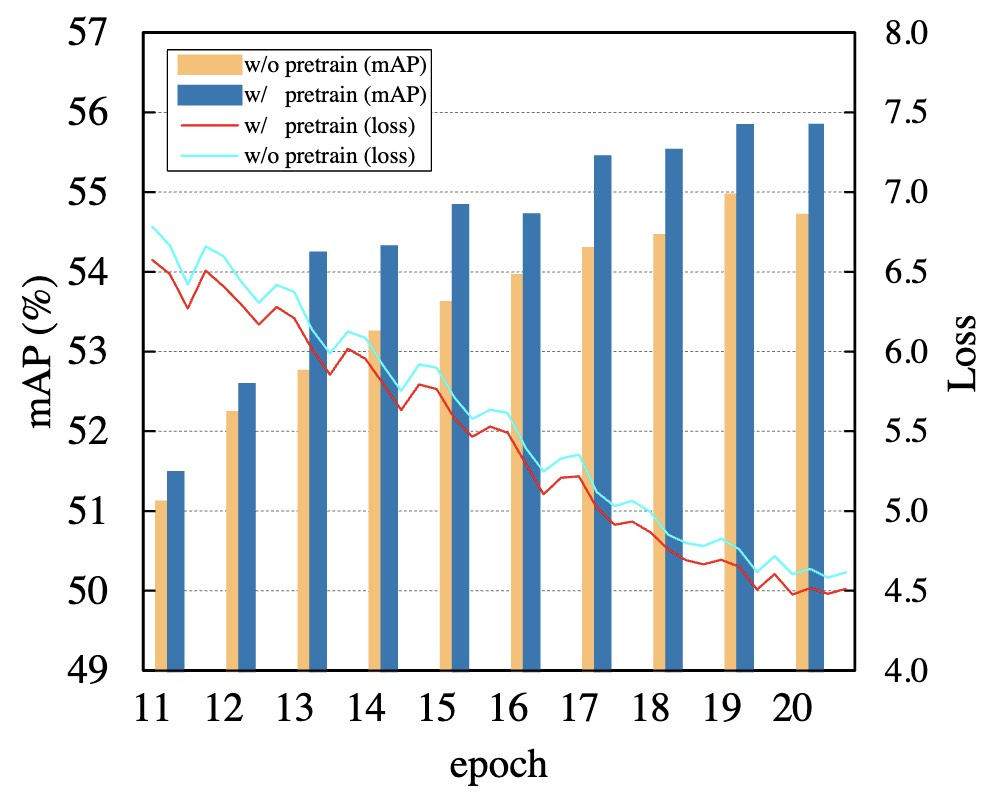
实验结果已经很好地证明了,论文中设计的网络结构继承了来自ImageNet上预训练得到的知识信息,无论是mAP还是训练损失,加载了预训练模型的效果都优于不采用预训练模型的效果
总结
目前,尽管基于点云的感知算法已经取得了很大的进步,但是针对Pillar-base算法模型中的2D主干网络依旧采用随机初始化的方式,没有使用到来自ImageNet预训练的网络模型,同时基于点云的算法模型也没得到不同尺度规模带来的优势
PillarNeSt是一个很好的解决方案,可以解决上述提到的两个问题。希望这篇解析能对大家有所帮助
原文链接:https://mp.weixin.qq.com/s/NJoAOyTuk9INQRJtJKz__g








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。