


用Scrapy和MongoDB实现基于时间序列的数据记录和分析
随着大数据和数据挖掘技术的快速发展,人们越来越注重时间序列的数据的记录和分析。而在网络爬虫方面,Scrapy是一款非常优秀的爬虫框架,而MongoDB则是一款非常优秀的NoSQL数据库。本文将介绍如何使用Scrapy和MongoDB实现基于时间序列的数据记录和分析。一、Scrapy的安装和使用Scrapy是Python语言实现的Web爬虫框架。我们可以使用以
随着大数据和数据挖掘技术的快速发展,人们越来越注重时间序列的数据的记录和分析。而在网络爬虫方面,Scrapy是一款非常优秀的爬虫框架,而MongoDB则是一款非常优秀的NoSQL数据库。本文将介绍如何使用Scrapy和MongoDB实现基于时间序列的数据记录和分析。
一、Scrapy的安装和使用
Scrapy是Python语言实现的Web爬虫框架。我们可以使用以下命令安装Scrapy:
pip install scrapy
安装完成后,我们就可以使用Scrapy来编写我们的爬虫了。下面我们将通过一个简单的爬虫例子来了解Scrapy的使用。
1、创建Scrapy项目
在命令行终端中,通过以下命令创建一个新的Scrapy项目:
scrapy startproject scrapy_example
项目创建完成后,我们可以通过以下命令进入到项目的根目录:
cd scrapy_example
2、编写爬虫
我们可以通过以下命令创建一个新的爬虫:
scrapy genspider example www.example.com
这里的example是自定义的爬虫名称,www.example.com是爬取的网站域名。Scrapy会生成一个默认的爬虫模板文件,我们可以编辑这个文件,来进行爬虫的编写。
在这个例子中,我们爬取一个简单的网页,并将网页上的文字内容保存到一个文本文件中。这个爬虫代码如下:
import scrapy

class ExampleSpider(scrapy.Spider):
    name = "example"
    start_urls = ["https://www.example.com/"]

    def parse(self, response):
        filename = "example.txt"
        with open(filename, "w") as f:
            f.write(response.text)
        self.log(f"Saved file {filename}")
3、运行爬虫
运行爬虫之前,我们先设置一下Scrapy的配置。在项目的根目录下,找到settings.py文件,将ROBOTSTXT_OBEY设置为False,这样我们的爬虫就可以爬取任何网站了。
ROBOTSTXT_OBEY = False
接下来,我们就可以通过以下命令运行这个爬虫了:
scrapy crawl example
运行结束后,我们就可以在项目的根目录下看到一个example.txt的文件,里面保存了我们爬取的网页文本内容。
二、MongoDB的安装和使用
MongoDB是一款非常优秀的NoSQL数据库。我们可以使用以下命令安装MongoDB:
sudo apt-get install mongodb
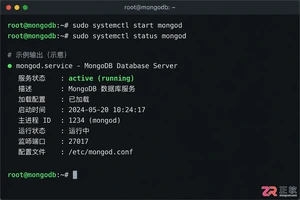
安装完成后,我们需要启动MongoDB服务。在命令行终端中输入以下命令:
sudo service mongodb start
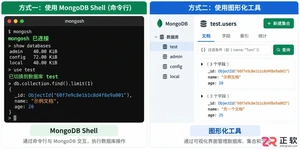
成功启动MongoDB服务后,我们就可以通过MongoDB Shell来操作数据了。
1、创建数据库
在命令行终端中输入以下命令,连接到MongoDB数据库:
mongo
连接成功后,我们可以使用以下命令创建一个新的数据库:
use scrapytest
这里的scrapytest就是我们自定义的数据库名称。
2、创建集合
在MongoDB中,我们使用集合(Collection)来存储数据。我们可以使用以下命令创建一个新的集合:
db.createCollection("example")这里的example就是我们自定义的集合名称。
3、插入数据
在Python中,我们可以使用pymongo库来访问MongoDB数据库。我们可以使用以下命令安装pymongo库:
pip install pymongo
安装完成后,我们就可以使用以下代码插入数据:
import pymongo

client = pymongo.MongoClient(host="localhost", port=27017)
db = client["scrapytest"]
collection = db["example"]
data = {"title": "example", "content": "Hello World!"}
collection.insert_one(data)
这里的data就是我们要插入的数据,包含了title和content两个字段。
4、查询数据
我们可以使用以下代码查询数据:
import pymongo

client = pymongo.MongoClient(host="localhost", port=27017)
db = client["scrapytest"]
collection = db["example"]
result = collection.find_one({"title": "example"})
print(result["content"])
这里的查询条件是"title": "example",表示查询title字段等于example的数据。查询结果会包含整个数据文档,我们可以通过result["content"]来获取content字段的值。
三、Scrapy和MongoDB的结合使用
在实际的爬虫应用中,我们常常需要将爬取到的数据保存到数据库中,并对数据进行时间序列的记录和分析。Scrapy和MongoDB的结合使用,可以很好地满足这个需求。
在Scrapy中,我们可以使用pipelines来处理爬取到的数据,并将数据保存到MongoDB中。
1、创建pipeline
我们可以在Scrapy项目的根目录下创建一个名为pipelines.py的文件,在这个文件中定义我们的pipeline。在这个例子中,我们将爬取到的数据保存到MongoDB中,并加入一个timestamp字段,表示数据记录的时间戳。代码如下:
import pymongo
from datetime import datetime

class ScrapyExamplePipeline:
    def open_spider(self, spider):
        self.client = pymongo.MongoClient("localhost", 27017)
        self.db = self.client["scrapytest"]

    def close_spider(self, spider):
        self.client.close()

    def process_item(self, item, spider):
        collection = self.db[spider.name]
        item["timestamp"] = datetime.now()
        collection.insert_one(dict(item))
        return item
这个pipeline会在爬虫每爬取到一个item时被调用。我们将爬取到的item转换为一个字典,并加入一个timestamp字段,然后将整个字典保存到MongoDB中。
2、配置pipeline
在Scrapy项目的根目录下找到settings.py文件,将ITEM_PIPELINES设置为我们刚刚定义的pipeline:
ITEM_PIPELINES = {
   "scrapy_example.pipelines.ScrapyExamplePipeline": 300,
}
这里的300是pipeline的优先级,表示该pipeline在所有的pipeline中的执行顺序。
3、修改爬虫代码
修改我们刚刚编写的爬虫代码,将item传递给pipeline。
import scrapy

class ExampleSpider(scrapy.Spider):
    name = "example"
    start_urls = ["https://www.example.com/"]

    def parse(self, response):
        for text in response.css("p::text"):
            yield {"text": text.extract()}
这里我们简单爬取了网页上的文字内容,并将内容保存到了一个text字段中。Scrapy会将这个item传递给定义好的pipeline进行处理。
4、查询数据
现在,我们已经可以将爬取到的数据保存到MongoDB中了。我们还需要实现时间序列的记录和分析。我们可以使用MongoDB的查询和聚合操作来实现。
查找指定时间段内的数据:
import pymongo
from datetime import datetime

client = pymongo.MongoClient("localhost", 27017)
db = client["scrapytest"]
collection = db["example"]
start_time = datetime(2021, 1, 1)
end_time = datetime(2021, 12, 31)
result = collection.find({"timestamp": {"$gte": start_time, "$lte": end_time}})
for item in result:
    print(item["text"])
这里我们查找了2021年的全部数据。
统计每个小时内的记录数:
import pymongo

client = pymongo.MongoClient("localhost", 27017)
db = client["scrapytest"]
collection = db["example"]
pipeline = [
    {"$group": {"_id": {"$hour": "$timestamp"}, "count": {"$sum": 1}}},
    {"$sort": {"_id": 1}},
]
result = collection.aggregate(pipeline)
for item in result:
    print(f"{item['_id']}: {item['count']}")
这里我们使用MongoDB的聚合操作来统计每个小时内的记录数。
通过Scrapy和MongoDB的结合使用,我们可以方便地实现时间序列的数据记录和分析。这种方案的优点是具有较强的扩展性和灵活性,可以适用于各种不同的应用场景。不过,由于本方案的实现可能涉及到一些较为复杂的数据结构和算法,所以在实际应用中需要进行一定程度的优化和调整。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。