


Transformers回顾 :从BERT到GPT4
人工智能已成为近年来最受关注的话题之一,由于神经网络的发展,曾经被认为纯粹是科幻小说中的服务现在正在成为现实。从对话代理到媒体内容生成,人工智能正在改变我们与技术互动的方式。特别是机器学习(ML)模型在自然语言处理(NLP)领域取得了重大进展。一个关键的突破是引入了“自注意力”和用于序列处理的Transformers架构,这使得之前主导该领域的几个关键问题得以解决。在本文中,我们将研究革命性的Transformers架构以及它如何改变NLP,我们还将全面回顾从BERT到Alpaca的Transformer
人工智能已成为近年来最受关注的话题之一,由于神经网络的发展,曾经被认为纯粹是科幻小说中的服务现在正在成为现实。从对话代理到媒体内容生成,人工智能正在改变我们与技术互动的方式。特别是机器学习 (ML) 模型在自然语言处理 (NLP) 领域取得了重大进展。一个关键的突破是引入了“自注意力”和用于序列处理的Transformers架构,这使得之前主导该领域的几个关键问题得以解决。
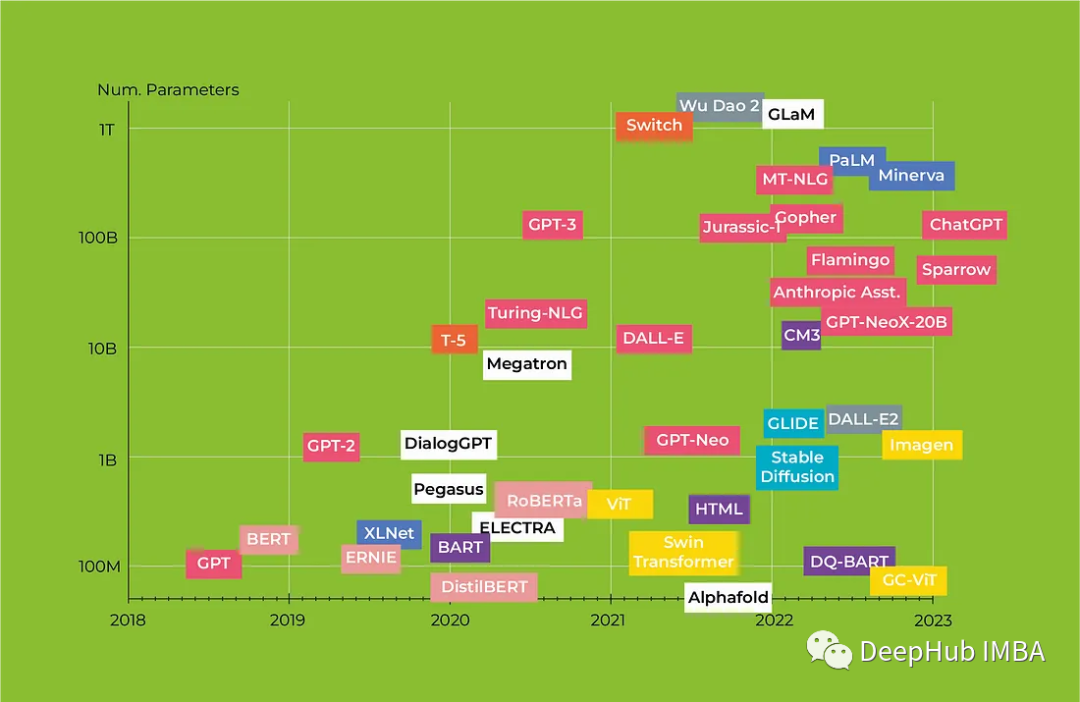
在本文中,我们将研究革命性的Transformers架构以及它如何改变NLP,我们还将全面回顾从BERT到Alpaca的Transformers模型,重点介绍每种模型的主要特征及其潜在应用。
类似bert的文本模型
第一部分是基于Transformer编码器的模型,用于向量化、分类、序列标记、QA(问答)、NER(命名实体识别)等。
1、BERT Google / 2018
Transformer 编码器,wordpiece tokenization(30K 词汇量)。输入嵌入由三个向量组成:标记向量、可训练位置向量和片段向量(第一个文本或第二个文本)。模型输入是 CLS 标记嵌入、第一个文本的嵌入和第二个文本的嵌入。
BERT 有两个训练任务:Masked Language Modeling (MLM) 和 Next Sentence Prediction (NSP)。在 MLM 中,15% 的令牌被屏蔽,80% 被 MASK 令牌替换,10% 被随机令牌替换,10% 保持不变。模型会预测正确的 令牌,而损失仅在这 15% 的屏蔽令牌上计算。在 NSP 中,模型预测第二个文本是否跟在第一个文本之后。预测是在 CLS 令牌的输出向量上进行的。
为了加快训练速度,首先90%的训练在序列长度为 128 个标记上进行,然后剩下的10% 的时间在 512 个标记上训练模型以获得更有效的位置嵌入。
2、RoBERTa Facebook / 2019
BERT的改进版本,它只在MLM上训练(因为NSP被认为不太有用),训练序列更长(512个令牌)。使用动态屏蔽(当再次处理相同的数据时,不同的令牌被屏蔽),训练超参数是精心选择的。
3、XLM Facebook / 2019
训练多语言模型的方法之一是使用不同的基本模型(目前最流行的模型是基于RoBERTa的XLM-R)。在最初的XLM中,所有语言都有一个共享的BPE词汇表。
XLM 有两个训练任务:MLM和翻译。翻译本质上与一对文本上的 MLM 相同,但文本是彼此的平行翻译,具有随机掩码和段嵌入编码语言。
4、Transformer-XL Carnegie Mellon University / 2019
该模型设计用于处理长序列,主要有两个思想:片段的循环处理和相对位置编码。
长文本被分成几个片段,每次处理一个片段。前一段的输出被缓存,在计算当前段中的自我关注时,键和值是基于当前段和前一段的输出计算的(只是简单地连接在一起)。梯度也只在当前段内计算。
这种方法不适用于绝对位置。所以模型中重新参数化了注意力权重公式。绝对的位置编码向量被一个固定的矩阵取代,该矩阵基于标记位置之间距离的正弦值和对所有位置共有的可训练向量。
5、ERNIE 清华大学,华为 / 2019
将知识图谱中有关命名实体的信息嵌入到 BERT 中。输入由一组文本标记和一组实体标记组成(每个标记代表整个实体)。文本标记由 BERT 编码。在 BERT 之上,有一组 K 编码器块(约占网络参数的 3%)。在这些块中:
- 文本标记的更新向量和实体标记的原始向量首先独立地计算自注意力;
- 实体向量与它们在文本中出现的第一个标记相匹配;
- 使用GeLU 激活,并且用于获得文本标记的新隐藏表示;
- 文本和实体标记的新向量从隐藏表示中获得,并作为输入传递给下一个编码器块。
在预训练期间,计算三种损失:MLM、NSP 和来自令牌的实体预测(如自编码器),自编码器使用下面规则:
- 在 5% 的情况下,实体被替换为错误的实体,但匹配被保留,模型必须预测正确的实体;
- 在 15% 的情况下,匹配被移除,模型必须仅基于文本来预测实体;
- 在其他情况下,是正常的。
预训练模型可以像常规 BERT 模型一样进行微调(有 CLS 令牌)。也可以使用额外的程序进行微调以确定实体及其类型之间的关系。
6、XLNet Carnegie Mellon University / 2019
因为BERT训练过程存在问题:
- 在训练期间,损失计算仅计算掩码标记。
- 只有个别标记被屏蔽,一个屏蔽标记的预测不会影响其他标记的预测。
- 模型在训练期间主动看到的实际应用程序中没有 MASK 令牌。
XLNet 基于 Transformer-XL,除了替换语言建模 (PLM) 任务外,它学习在短的上下文中预测标记,而不是直接使用 MASK。这确保了梯度会计算所有标记并消除了对特殊掩码标记的需要。
上下文中的标记被打乱(比如:可以根据第 i-2个和第i+1个标记预测第 i 个标记),但它们的位置仍然是已知的。这无法通过当前的位置编码(包括 Transformer-XL)实现。当尝试在给定上下文的一部分的情况下预测令牌的概率时,模型不应该知道本身的令牌,但应该知道令牌在上下文中的位置。为了解决这个问题,他们将self-attention 分为两个流:
- 在每个标记位置,有两个向量而不是一个:内容向量和查询向量。
- 内容向量包含有关令牌的完整信息,而查询向量仅包含位置信息。
- token 的两个向量都是基于上下文向量计算的,但是 self-attention 中的查询向量是使用过去的内容向量计算的,内容向量是使用过去的查询向量计算的。
- query vector 不接收关于相应 token 的内容的信息,但知道上下文的所有信息,而 content vector 包含完整的信息。
在微调期间,如果忽略查询向量,模型将像常规的 Transformer-XL 一样工作。
在实践中该模型的要求上下文必须足够长,以便模型能够正确学习。它在与 RoBERTa 相同数量的数据上学习,结果相似,但由于实现的复杂性,该模型并没有像 RoBERTa 那样流行。
7、ALBERT Google / 2019
在不牺牲质量的情况下简化BERT:
- 在不同的编码器块中使用共同的参数,并且已经证明可以共享自注意力的权重,但是分离全连接层的权重会导致质量下降。
- 与BERT相比,使用了更小的输入嵌入和更大的隐藏层向量。这可以通过在网络输入处使用一个额外的投影矩阵来实现,这样也可以将嵌入的大小与隐藏表示的大小解耦。
- 模型的参数减少了18倍,运行速度提高了1.7倍。
模型在MLM和句子顺序预测(SOP)上进行训练。
8、DistilBERT Google / 2019
另一种优化BERT的方法是蒸馏:
- 编码器块的数量减半
- 三个损失成分:MLM、与教师模型输出的交叉熵,以及相应层输出之间的余弦距离。
- 模型比教师模型小40%,速度快60%,并且在各种任务上保持了97%的质量。
9、LaBSE Google / 2020
基于BERT的多语言矢量化模型。它在MLM和TLM上进行训练(20%的标记被屏蔽),然后对其进行微调。它支持100多种语言,包含500K个标记的词汇表。
10、ELECTRA Google, Stanford University / 2020
使用生成对抗方法加速BERT训练:
- 训练了两个类bert模型:一个小型生成器和一个主鉴别器
- 生成器在MLM上进行训练,然后填充掩码令牌
- 鉴别器被训练来预测由生成器生成的文本的原创性(替换检测任务)
- 训练完成后,去掉生成器,用鉴别器进行微调
训练数据的数量与RoBERTa或XLNet相同,并且模型比BERT、RoBERTa和ALBERT更快地学习到相似的质量水平。训练时间越长,它的表现就越好。
11、DeBERTa Microsoft / 2020
另一种将标记向量的内容和位置分离为两个单独的向量的模型:
- 位置向量在所有层之间共享,并且是相对的,即标记之间的每个可能距离都有一个。
- 为它们添加了两个新的权重矩阵K_pos和Q_pos。
- 对注意力权重计算进行修改,简化为三个乘积的和:Q_cont * K_cont + Q_cont * K_pos + K_cont * Q_pos
- 与ALBERT中一样,使用投影矩阵将嵌入大小与隐藏标记表示向量的大小解耦。
类似GPT 和T5的而模型
基于完整Transformers的模型。它的应用范围非常广泛:除了上一节的任务外,它还包括会话代理、机器翻译、逻辑和数学推理、代码分析和生成,以及基本上文本生成。最大和“最智能”的模型通常基于解码器架构。此类模型通常在 few-shot 和 zero-shot 模式下无需微调即可表现良好。
1、GPT-2 OpenAI / 2018
解码器在因果LM的任务上进行训练(根据左侧上下文预测下一个令牌)。从体系结构的角度来看,有一些小的变化:从每个解码器块中移除交叉注意层,并使用了LayerNorm
使用的标记器是字节级BPE (50K词汇表),没有使用类似的子字符串例如(“dog”、“dog!”、“dog.”)。最大序列长度为 1024。层输出缓存所有先前生成的标记。
2、T5 Google / 2019
在MLM上进行完整的预训练(15%的令牌被屏蔽),跨度由代码掩码(
LayerNorm在自注意力层和全连接层输入之前应用。使用相对位置编码:
位置由可学习的嵌入编码,其中每个“嵌入”只是在计算注意力权重时添加相应logit的标量。
矩阵B是跨层共享的,但对于不同的自注意力注头是不同的。
每一层考虑令牌之间的128个距离,其余的归零,这样可以对比训练期间看到的序列更长的序列进行推理。
标记化使用sentencepece (32K词汇表)完成,在预训练期间最大序列长度为512。
3、BART Facebook / 2019
另一个完整的transformers,但是用GeLU取代了ReLU。训练它从噪声文本(AE去噪)中预测原始文本,噪声类型如下:
- 令牌屏蔽
- 删除令牌
- 令牌填充
- 句子中令牌顺序颠倒
- 使随机令牌成为序列的开始
使用字节级BPE(词汇表大小为50K)
4、CTRL Salesforce / 2019
使用前缀代码令牌(例如,
5、GPT-3 OpenAI / 2020
这是一个具有Sparse Transformer架构的GPT-2模型,并且增加了2048个令牌的序列长度。还记的那句话吗:别问,问就是GPT3
6、mT5 Google / 2020
基于T5模型,具有类似的训练,但使用多语言数据。ReLU激活被替换为GeGLU,词汇表扩展到250K个标记。
7、GLAM Google / 2021
这个模型在概念上类似于Switch Transformer,但更侧重于在少样本的模式下工作,而不是微调。不同规模的模型使用32到256个专家层,K=2。使用来自Transformer-XL的相对位置编码。在处理令牌时,只有不到10%的网络参数被激活。
8、 LaMDA Google / 2021
类似gpt的模型。该模型是一个会话模型,在因果LM上进行了预训练,并在生成和判别任务上进行了微调。该模型还可以对外部系统(搜索、翻译)的调用。
9、GPT-NeoX-20B EleutherAI / 2022
这个模型类似于GPT-J,也使用旋转位置编码。模型权重使用float16表示。最大序列长度为2048。
10、BLOOM BigScience / 2022
这是46种语言和13种编程语言的最大开源模型。为了训练模型,使用一个名为ROOTS的大型聚合数据集,其中包括大约500个开放数据集。
11、PaLM Google / 2022
这是一个大型多语言解码器模型,使用Adafactor进行训练,在预训练时禁用dropout,在微调时使用0.1。
12、LLaMA Meta / 2023
用于科学研究的开源大型gpt类LM,已用于训练多个指令模型。该模型使用了pre-LayerNorm、SwiGLU激活和RoPE位置嵌入。因为开源所以这是弯道超车的主要模型之一。
文本的指导模型
这些模型抓哟用于校正模型输出(例如 RLHF)以提高对话和任务解决期间的响应质量。
1、InstructGPT OpenAI / 2022
这项工作调整GPT-3以有效地遵循指示。该模型在一个由提示和答案组成的数据集上进行微调,这些提示和答案是人类根据一套标准认为好的。基于InstructGPT,OpenAI 创建了一个被我们现在熟知的模型ChatGPT。
2、Flan-T5 Google / 2022
适用于T5的指导模型。在某些任务中,Flan-T5 11B在没有这种微调的情况下优于PaLM 62B。这些模型已经作为开源发布。
3、Sparrow DeepMind / 2022
基本模型是通过在选定的高质量对话上对Chinchilla进行微调获得的,前80%的层被冻结。然后该模型被进一步训练,使用一个大提示来引导它进行对话。有几个奖励模型也在Chinchilla的基础上进行训练。该模型可以访问搜索引擎并检索最多500个字符的片段,这些片段可以成为响应。
在推理过程中,奖励模型用于对候选人进行排序。候选项要么由模型生成,要么从搜索中获得,然后最好的一个成为响应。
4、Alpaca Stanford University / 2023
上面LLaMA 的指导模型。主要重点是使用GPT-3构建数据集的过程:
- 目标是获得一组Task-Input-Output三元组,其中Input可以为空。
- 人类会生成175个带有答案的任务提示,这些提示被输入到GPT-3中,GPT-3会生成新的任务。
- 生成过程是迭代的,在每个步骤中,都提供了一些来自人类的任务示例和一些来自先前生成的任务示例。
- GPT-3将生成的任务分为分类任务或非分类任务,并根据此生成不同的输入和输出。
- 三元组根据质量和与数据库中现有三元组的不相似度进行过滤。
总共生成了52K个唯一的三元组,并对LLaMA 7B进行了微调。
5、Koala Berkeley University / 2023
这是在指令数据上对LLaMA进行微调,但与上面的Alpaca不同的是,它不仅在GPT-3等大型模型生成的数据上进行微调。还数据集的组成为:
- 30k个关于数学、诗歌和对话的说明和回答样本;
- 52K个Alpaca 数据集的样本;
- 160K对用户对有用性和危害偏好的模型响应;
- 20K对带有用户问题和评分的模型回答;
- 93K个总结,用户对其质量评分;
与GPT-3相比,没有质量的增加。但是在盲测中,用户更喜欢Koala 的回答,而不是Alpaca 的回答。
从文本生成图像的模型
基于文本描述的图像生成器。扩散模型与transformers 相结合在这一领域占据主导地位,不仅可以生成图像,还可以进行内容操作和分辨率增强。
1、DALL-E OpenAI / 2021
这项工作分两个阶段进行:对图像的标记进行训练,然后学习文本和图像的联合生成模型。
在第一阶段,训练dVAE,其中将图像从256x256x3空间转换为32x32xdim并返回,其中dim是隐藏表示向量的维度。总共有8192个这样的标记向量,这些标记向量将在模型中进一步使用。
使用的主要模型是稀疏transformer 解码器。文本令牌和图像令牌作为输入,模型学习联合分布(Causal LM),之后可以基于文本生成图像令牌。dVAE基于这些相同的令牌生成一个映像。文本标记的损失权重是1/8,图像标记的权重损失是7/8。
对于文本标记,有常规嵌入和位置嵌入,对于图像标记,有常规的、按列定位的和按行定位的嵌入。文本标记序列的最大长度为256,标记化为BPE (16K词汇表)。
2、GLIDE OpenAI / 2021
一种在像素级操作并由文本控制的扩散模型(DM)。它基于U-Net架构,具有卷积、注意和残差连接。使用不同的方法来控制生成。使用CLIP获得的图像向量和文本向量的标量积
3、Latent Diffusion [Stable Diffusion] CompVis [Stability AI] / 2021 [2022]
在像素空间中工作的扩散模型,主要包含2个模型:
- 一种用于从潜在空间降维和生成的VAE自编码器
- 内部表征的DM
自编码器以类似gan的方式进行训练,在其结果上使用鉴别器,并将额外的正则化表示与标准正态分布的接近程度。
结果在潜在空间中进入DM解码:如果条件是一个向量,则在步骤的输入处与潜在向量连接,如果是一个向量序列,则用于不同U-Net层的交叉注意。对于文本提示使用CLIP向量。
这个通用的模型可以被训练用于不同的任务:文本到图像,着色,绘画,超分辨率。
4、Imagen Google / 2022
Imagen背后的主要思想是增加文本编码器的大小比增加DM的大小可以给生成模型带来更多的好处。所以CLIP被替换为T5-XXL。
从图像生成文本的模型
本节中的模型通常被称为多模态模型,因为它们在生成文本的同时能够分析不同性质的数据。生成的文本可以是自然语言,也可以是一组命令,例如机器人的命令。
1、CoCa Google / 2022
一个单独的图像编码器(ViT或CNN) +一个共享解码器,其中前半部分处理文本,后半部分与图像编码器的输出共同处理文本。
288x288的图像被切成18x18的块,编码器将其转换为向量+基于所有这些向量的共享注意力池向量。
解码器的前半部分的输出是文本向量和序列末尾的CLS标记向量,使用sentencepece (64K词汇表)进行标记化。文本和图像矢量通过交叉注意在解码器的后半部分合并。
两个损失的权重分别:
- 图像的注意力池向量与图像描述对的文本的CLS标记向量之间的相似性。
- 整个解码器输出的自回归损失(以图像为条件)。
在微调过程中,图像编码器可以被冻结,只有注意力池可以被微调。
2、PaLM-E Google / 2023
图像由ViT编码,输出向量以及文本令牌和命令被输入PaLM, PaLM生成输出文本。
PaLM-E用于所有任务,包括 VQA、对象检测和机器人操作。
3、GPT-4 OpenAI / 2023
这是一个具有少量已知细节的封闭模型。据推测,它有一个具有稀疏注意力和多模态输入的解码器。它使用自回归训练和微调RLHF,序列长度从8K到32K。
它已经在人类考试中进行了零样本和少样本的测试,并达到了类似人类的水平。它可以立即和逐步解决基于图像的问题(包括数学问题),理解和解释图像,并可以分析和生成代码。还适用于不同的语言,包括小语种。
总结
下面是简短结论。它们可能不完整,或者根本不正确,所以仅供参考。
自动显卡不能挖矿以后,各种大型模型蜂拥而至,模型的基数一直在增长,但是简单的层的增加和数据集的增长被各种更好的技术替代,这些技术允许质量改进(使用外部数据和工具,改进网络结构和新的微调技术)。但是越来越多的工作表明训练数据的质量比数量更重要:正确选择和形成数据集可以减少训练时间并提高结果质量。
OpenAI现在正在走向闭源,他们已经尝试过不释放GPT-2的权重但没有成功。但是GPT4是黑盒,近几个月来改进和优化开源模型的微调成本和推理速度的趋势在很大程度上降低了大型私有模型作为产品的价值,开源模型在质量上也正迅速赶上巨头,这又可以弯道超车了。
最后开源模型的总结如下:
- 在编码器模型块中,XLM-RoBERTa 和 LaBSE 模型被认为是可靠的多语言解决方案;
- 在开放的生成模型中,最有趣的是 LLaMA 和来自 EleutherAI 的模型(都有它们所有的微调版本)、Dolly-2、BLOOM(同样有指令微调选项);
- 代码方面,SantaCoder的模型还不错,但是总体来说质量也明显落后于ChatGPT/GPT-4;
- Transformer-XL 和 Sparse Transformer 实现了其他模型中使用的技术,可以仔细研究;
以上,仅供参考。










火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,