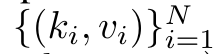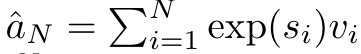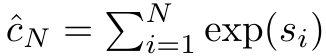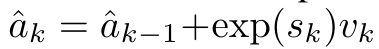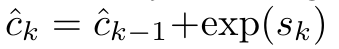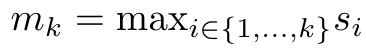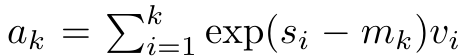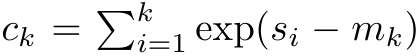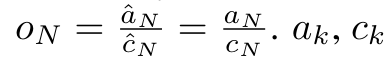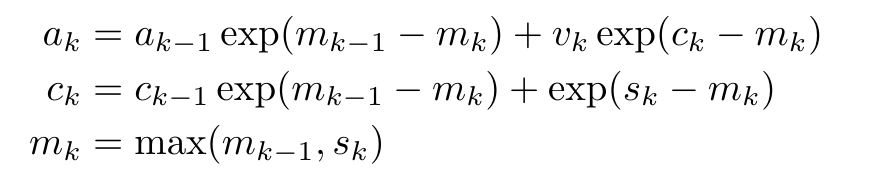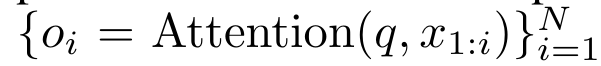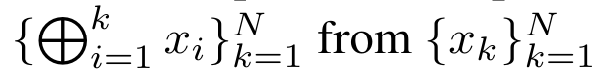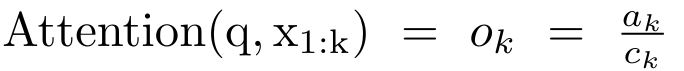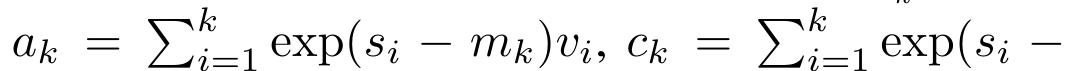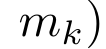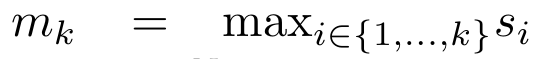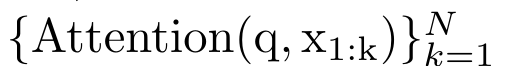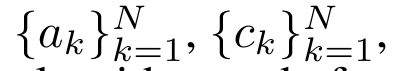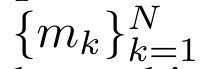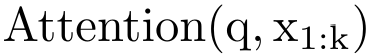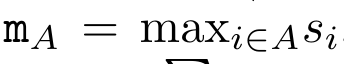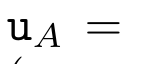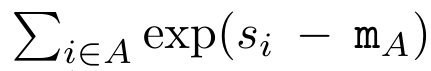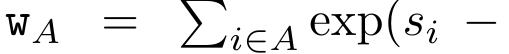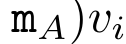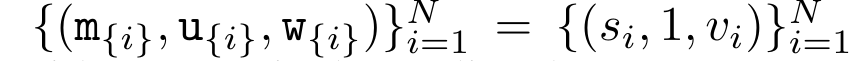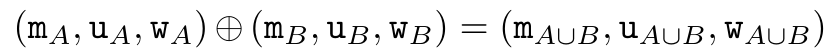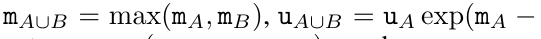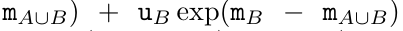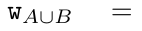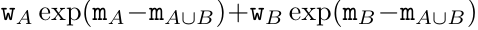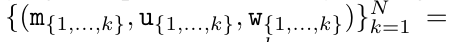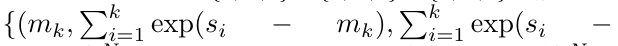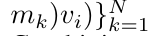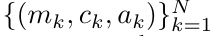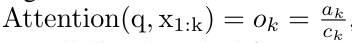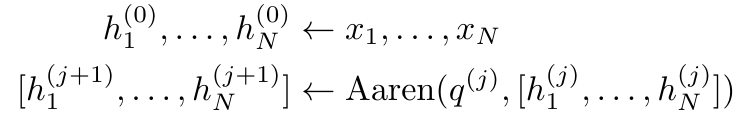展开菜单
首页 精品内容 本月促销 装机必备 Windows PDF教程 macOS软件 IOS软件 Android AI 专题
全部分类

当前位置:

首页 > 业界资讯 > Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存

Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存

序列建模的进展具有极大的影响力,因为它们在广泛的应用中发挥着重要作用,包括强化学习(例如,机器人和自动驾驶)、时间序列分类(例如,金融欺诈检测和医学诊断)等。在过去的几年里,Transformer的出现标志着序列建模中的一个重大突破,这主要得益于Transformer提供了一种能够利用GPU并行处理的高性能架构。然而,Transformer在推理时计算开销很大,主要在于内存和计算需求呈二次扩展,从而限制了其在低资源环境中的应用(例如,移动和嵌入式设备)。尽管可以采用KV缓存等技术提高推理效率,但Trans
本文目录
    序列建模的进展具有极大的影响力,因为它们在广泛的应用中发挥着重要作用,包括强化学习(例如,机器人和自动驾驶)、时间序列分类(例如,金融欺诈检测和医学诊断)等。

    在过去的几年里,Transformer 的出现标志着序列建模中的一个重大突破,这主要得益于 Transformer 提供了一种能够利用 GPU 并行处理的高性能架构。

    然而,Transformer 在推理时计算开销很大,主要在于内存和计算需求呈二次扩展,从而限制了其在低资源环境中的应用(例如,移动和嵌入式设备)。尽管可以采用 KV 缓存等技术提高推理效率,但 Transformer 对于低资源领域来说仍然非常昂贵,原因在于:(1)随 token 数量线性增加的内存,以及(2)缓存所有先前的 token 到模型中。在具有长上下文(即大量 token)的环境中,这一问题对 Transformer 推理的影响更大。 

    为了解决这个问题,加拿大皇家银行 AI 研究所 Borealis AI、蒙特利尔大学的研究者在论文《Attention as an RNN 》中给出了解决方案。值得一提的是,我们发现图灵奖得主 Yoshua Bengio 出现在作者一栏里。

    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存

    • 论文地址:https://arxiv.org/pdf/2405.13956
    • 论文标题:Attention as an RNN

    具体而言,研究者首先检查了 Transformer 中的注意力机制,这是导致 Transformer 计算复杂度呈二次增长的组件。该研究表明注意力机制可以被视为一种特殊的循环神经网络(RNN),具有高效计算的多对一(many-to-one)RNN 输出的能力。利用注意力的 RNN 公式,该研究展示了流行的基于注意力的模型(例如 Transformer 和 Perceiver)可以被视为 RNN 变体。

    然而,与 LSTM、GRU 等传统 RNN 不同,Transformer 和 Perceiver 等流行的注意力模型虽然可以被视为 RNN 变体。但遗憾的是,它们无法高效地使用新 token 进行更新。


    为了解决这个问题,该研究引入了一种基于并行前缀扫描(prefix scan)算法的新的注意力公式,该公式能够高效地计算注意力的多对多(many-to-many)RNN 输出,从而实现高效的更新。

    在此新注意力公式的基础上,该研究提出了 Aaren([A] ttention [a] s a [re] current neural [n] etwork),这是一种计算效率很高的模块,不仅可以像 Transformer 一样并行训练,还可以像 RNN 一样高效更新。

    实验结果表明,Aaren 在 38 个数据集上的表现与 Transformer 相当,这些数据集涵盖了四种常见的序列数据设置:强化学习、事件预测、时间序列分类和时间序列预测任务,同时在时间和内存方面更加高效。 

    方法介绍

    为了解决上述问题,作者提出了一种基于注意力的高效模块,它能够利用 GPU 并行性,同时又能高效更新。

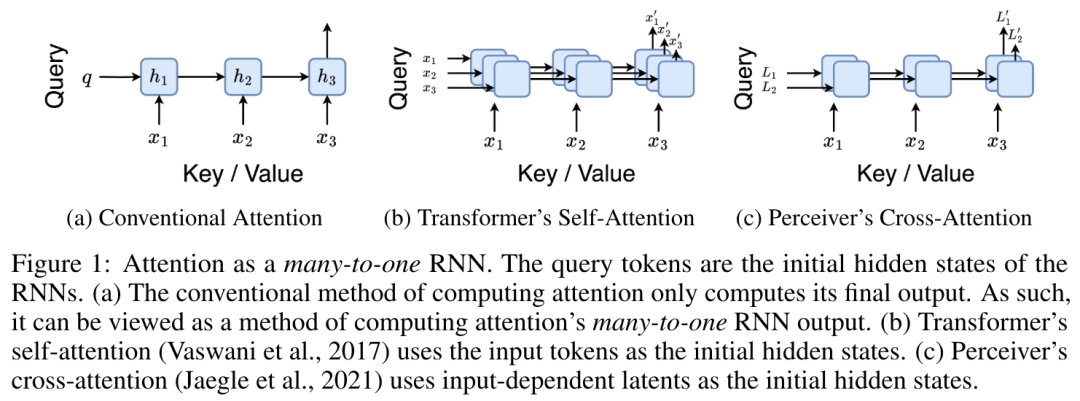
    首先,作者在第 3.1 节中表明,注意力可被视为一种 RNN,具有高效计算多对一 RNN(图 1a)输出的特殊能力。利用注意力的 RNN 形式,作者进一步说明,基于注意力的流行模型,如 Transformer(图 1b)和 Perceiver(图 1c),可以被视为 RNN。然而,与传统的 RNN 不同的是,这些模型无法根据新 token 有效地更新自身,从而限制了它们在数据以流的形式到达的序列问题中的潜力。
    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存

    为了解决这个问题,作者在第 3.2 节中介绍了一种基于并行前缀扫描算法的多对多 RNN 计算注意力的高效方法。在此基础上,作者在第 3.3 节中介绍了 Aaren—— 一个计算效率高的模块,它不仅可以并行训练(就像 Transformer),还可以在推理时用新 token 高效更新,推理只需要恒定的内存(就像传统 RNN)。

    将注意力视为一个多对一 RNN

    查询向量 q 的注意力可被视为一个函数,它通过 N 个上下文 token x_1:N 的键和值Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存将其映射到单一输出 o_N = Attention (q, k_1:N , v_1:N ) 。给定 s_i = dot (q,k_i),输出 o_N 可表述为:  
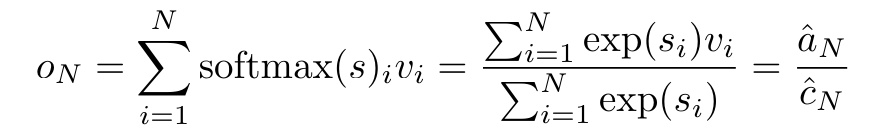
    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存


    其中分子为 Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存,分母为Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存。将注意力视为 RNN,可以在 k = 1,...,...... 时,以滚动求和的方式迭代计算Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存和Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存。然而,在实践中,这种实现方式并不稳定,会因有限的精度表示和可能非常小或非常大的指数(即 exp (s))而遇到数值问题。为了缓解这一问题,作者用累积最大值项Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存 来重写递推公式,计算Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存和Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存。值得注意的是,最终结果是相同的Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存,m_k 的循环计算如下:

    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存

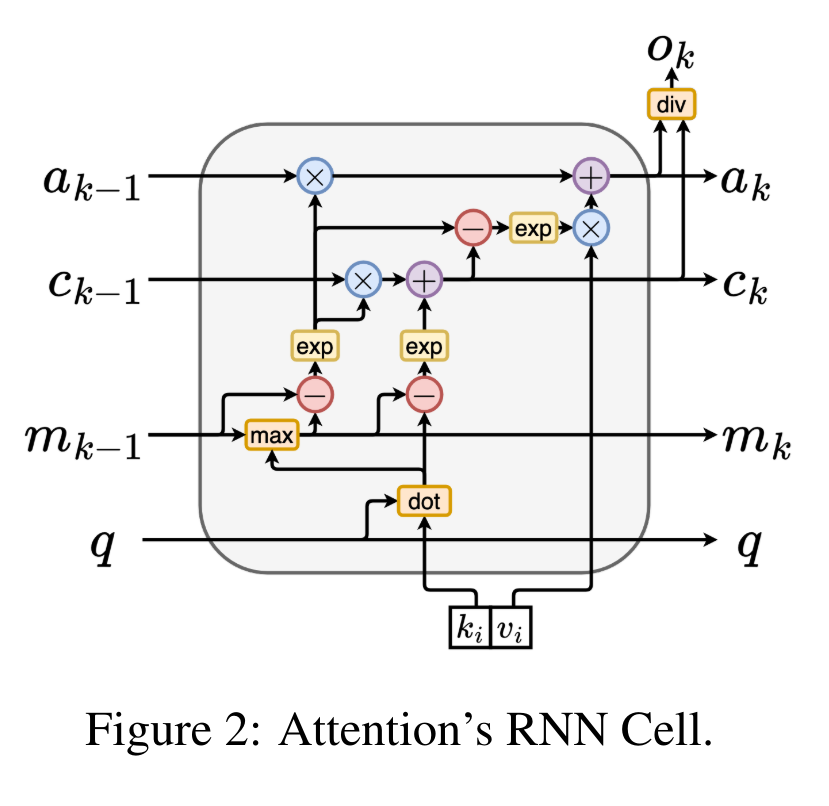
    通过从 a_(k-1)、c_(k-1) 和 m_(k-1) 对 a_k、c_k 和 m_k 的循环计算进行封装,作者引入了一个 RNN 单元,它可以迭代计算注意力的输出(见图 2)。注意力的 RNN 单元以(a_(k-1), c_(k-1),  m_(k-1), q)作为输入,并计算(a_k, c_k, m_k, q)。注意,查询向量 q 在 RNN 单元中被传递。注意力 RNN 的初始隐藏状态为 (a_0, c_0, m_0, q) = (0, 0, 0, q)。Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存
    计算注意力的方法:通过将注意力视为一个 RNN,可以看到计算注意力的不同方法:在 O (1) 内存中逐个 token 循环计算(即顺序计算);或以传统方式计算(即并行计算),需要线性 O (N) 内存。由于注意力可以被看作是一个 RNN,因此计算注意力的传统方法也可以被看作是计算注意力多对一 RNN 输出的高效方法,即 RNN 的输出以多个上下文 token 为输入,但在 RNN 结束时只输出一个 token(见图 1a)。最后,也可以将注意力计算为一个逐块处理 token 的 RNN,而不是完全按顺序或完全并行计算,这需要 O (b) 内存,其中 b 是块的大小。

    将现有的注意力模型视为 RNN。通过将注意力视为 RNN,现有的基于注意力的模型也可以被视为 RNN 的变体。例如,Transformer 的自注意力是 RNN(图 1b),上下文 token 是其初始隐藏状态。Perceiver 的交叉注意力是 RNN(图 1c),其初始隐藏状态是与上下文相关的潜变量。通过利用其注意力机制的 RNN 形式,这些现有模型可以高效地计算其输出存储。

    然而,当将现有的基于注意力的模型(如 Transformers)视为 RNN 时,这些模型又缺乏传统 RNN(如 LSTM 和 GRU)中常见的重要属性。

    值得注意的是,LSTM 和 GRU 能够仅在 O (1) 常量内存和计算中使用新 token 有效地更新自身,相比之下, Transformer 的 RNN 视图(见图 1b)会通过将一个新的 token 作为初始状态添加一个新的 RNN 来处理新 token。这个新的 RNN 处理所有先前的 token,需要 O (N) 的线性计算量。

    在 Perceiver 中,由于其架构的原因,潜变量(图 1c 中的 L_i)是依赖于输入的,这意味着它们的值在接收新 token 时会发生变化。由于其 RNN 的初始隐藏状态(即潜变量)发生变化,Perceiver 因此需要从头开始重新计算其 RNN,需要 O (NL) 的线性计算量,其中 N 是 token 的数量,L 是潜变量的数量。 

    将注意力视为一个多对多 RNN

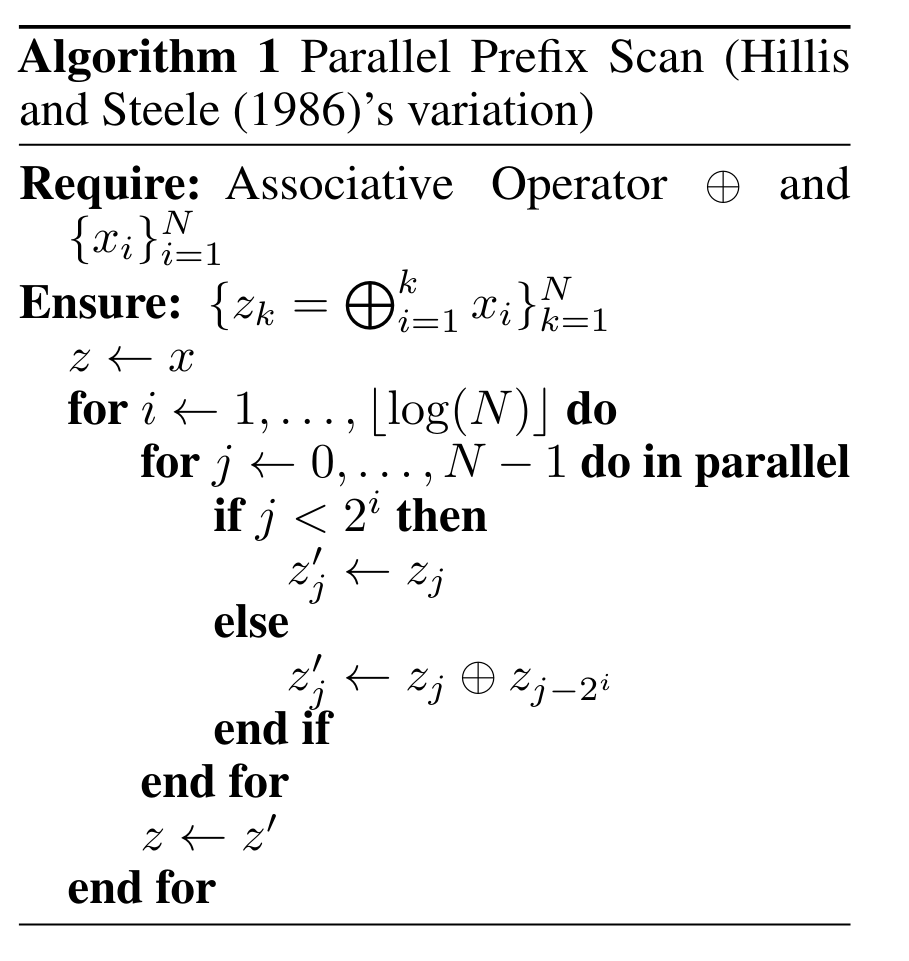
    针对这些局限性,作者建议开发一种基于注意力的模型,利用 RNN 公式的能力来执行高效更新。为此,作者首先引入了一种高效的并行化方法,将注意力作为多对多 RNN 计算,即并行计算Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存的方法。为此,作者利用并行前缀扫描算法(见算法 1),这是一种通过关联算子 ⊕ 从 N 个连续数据点计算 N 个前缀的并行计算方法。该算法可高效计算Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存

    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存
    回顾Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存,其中 Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存,Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存为了高效计算Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存,可以通过并行扫描算法计算Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存和Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存,然后结合 a_k 和 c_k 计算Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存。


    为此,作者提出了以下关联算子⊕,该算子作用于形式为(m_A、u_A、w_A)的三元组,其中 A 是一组索引,Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存,Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存,Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存。并行扫描算法的输入为Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存。该算法递归应用算子 ⊕,其工作原理如下:

    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存,其中,Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存,Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存。

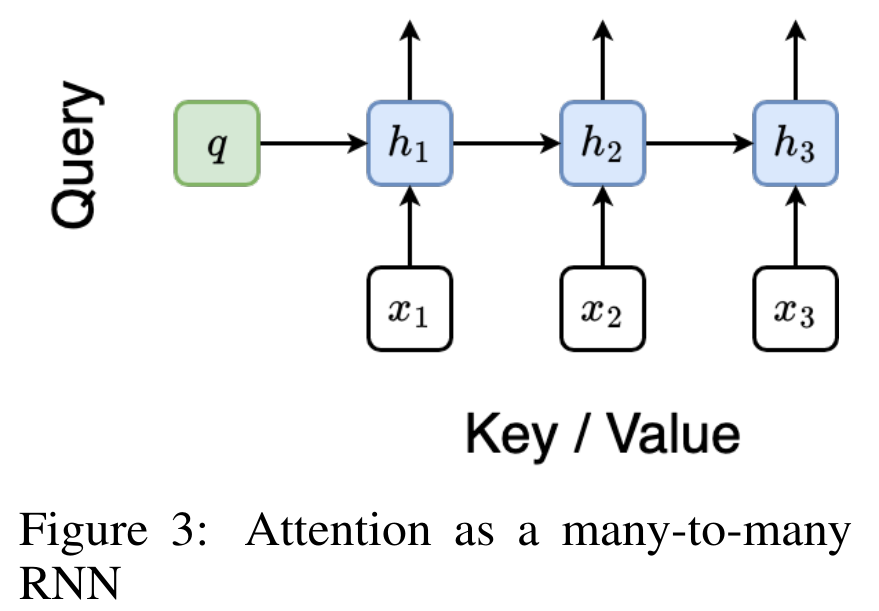
    在完成递归应用算子后,算法输出Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存。也被称作Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存。结合输出元组的最后两个值,检索Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存从而产生一种高效的并行方法,将注意力计算为多对多 RNN(图 3)。
    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存

    Aaren:[A] ttention [a] s a [re] current neural [n] etwork

    Aaren 的接口与 Transformer 相同,即将 N 个输入映射到 N 个输出,而第 i 个输出是第 1 到第 i 个输入的聚合。此外,Aaren 还自然可堆叠,并且能够计算每个序列 token 的单独损失项。然而,与使用因果自注意力的 Transformers 不同,Aaren 使用上述计算注意力的方法作为多对多 RNN,使其更加高效。Aaren 形式如下:

    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存

    与 Transformer 不同,在 Transformer 中查询是输入到注意力的 token 之一,而在 Aaren 中,查询 token q 是在训练过程中通过反向传播学习得到的。 

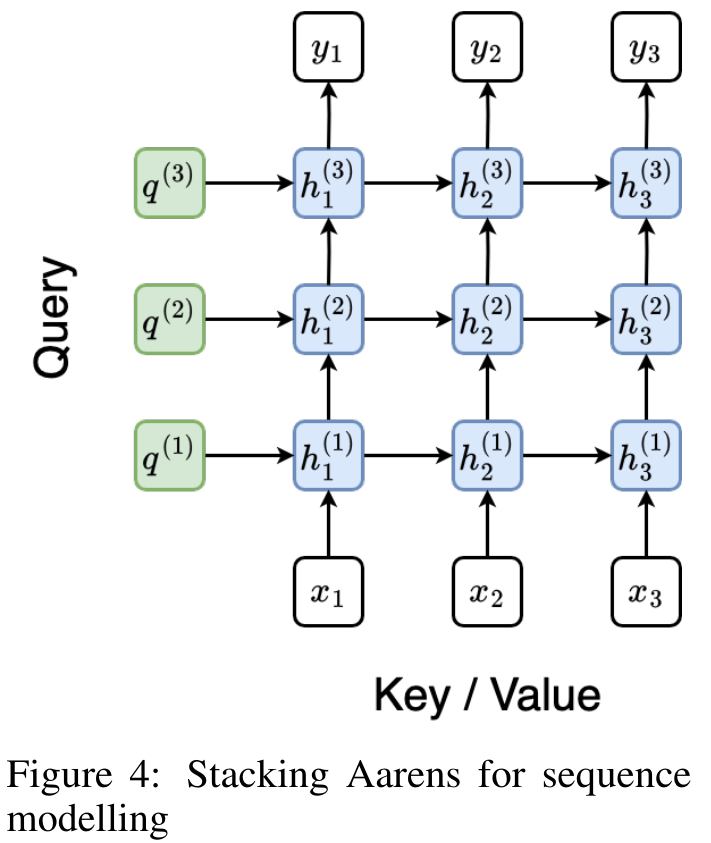
    下图展示了一个堆叠 Aaren 模型的例子,该模型的输入上下文 token 为 x_1:3,输出为 y_1:3。值得注意的是,由于 Aaren 利用了 RNN 形式的注意力机制,堆叠 Aarens 也相当于堆叠 RNN。因此,Aarens 也能够高效地用新 token 进行更新,即 y_k 的迭代计算仅需要常量计算,因为它仅依赖于 h_k-1 和 x_k。

    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存

    基于 Transformer 的模型需要线性内存(使用 KV 缓存时)并且需要存储所有先前的 token ,包括中间 Transformer 层中的那些,但基于 Aaren 的模型只需要常量内存,并且不需要存储所有先前的 token ,这使得 Aarens 在计算效率上显著优于 Transformer。 

    实验

    实验部分的目标是比较 Aaren 和 Transformer 在性能和所需资源(时间和内存)方面的表现。为了进行全面比较,作者在四个问题上进行了评估:强化学习、事件预测、时间序列预测和时间序列分类。

    强化学习

    作者首先比较了 Aaren 和 Transformer 在强化学习方面的表现。强化学习在机器人、推荐引擎和交通控制等交互式环境中很受欢迎。

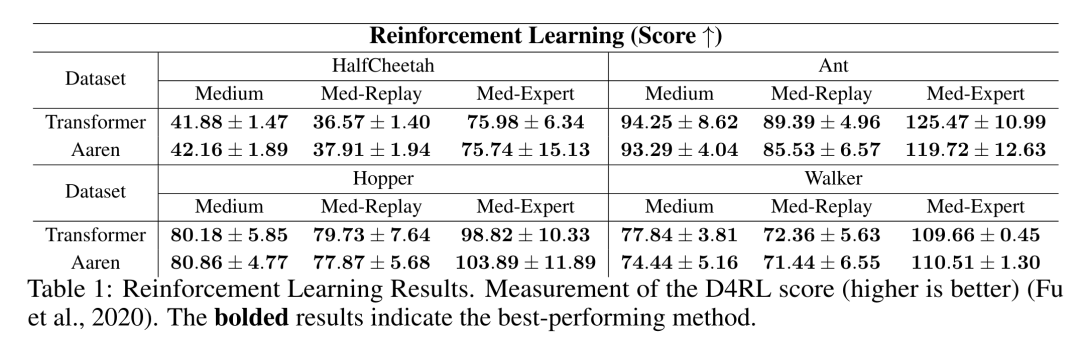
    表 1 中的结果表明,在所有 12 个数据集和 4 种环境中,Aaren 与 Transformer 的性能都不相上下。不过,与 Transformer 不同的是,Aaren 也是一种 RNN,因此能够在持续计算中高效处理新的环境交互,从而更适合强化学习。
    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存

    事件预测

    接下来,作者比较了 Aaren 和 Transformer 在事件预测方面的表现。事件预测在许多现实环境中都很流行,例如金融(如交易)、医疗保健(如患者观察)和电子商务(如购买)。

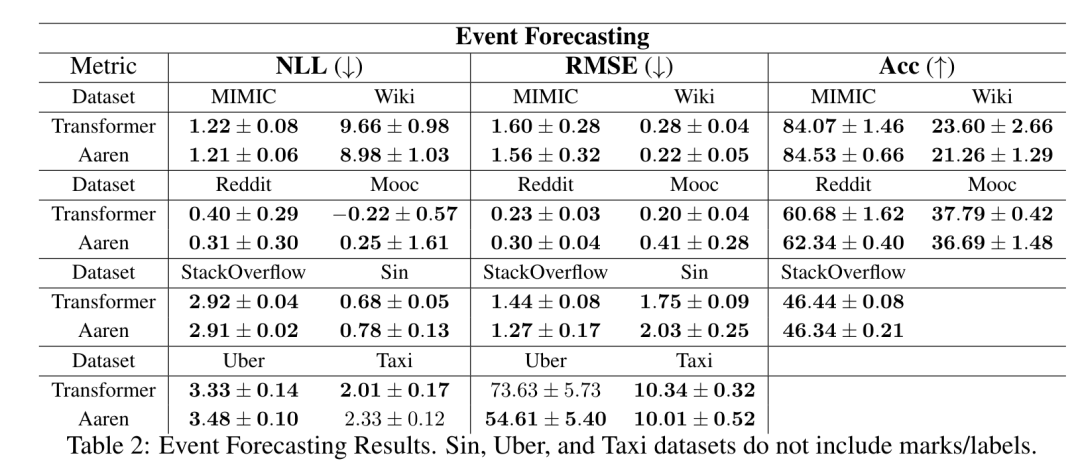
    表 2 中的结果显示,Aaren 在所有数据集上的表现都与 Transformer 相当。Aaren 能够高效处理新输入,这在事件预测环境中尤为有用,因为在这种环境中,事件会以不规则流的形式出现。
    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存
    时间序列预测

    然后,作者比较了 Aaren 和 Transformer 在时间序列预测方面的表现。时间序列预测模型通常用在与气候(如天气)、能源(如供需)和经济(如股票价格)相关的领域。

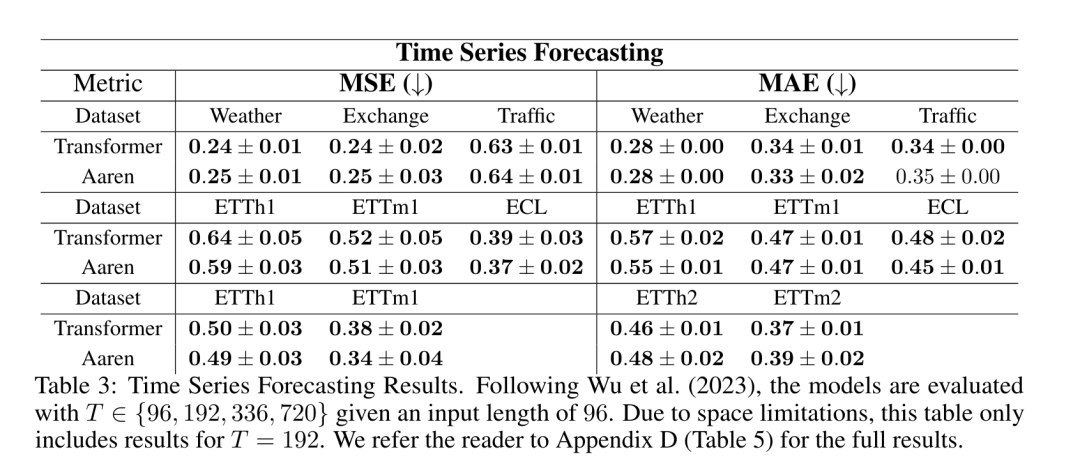
    表 3 中的结果显示,在所有数据集上,Aaren 与 Transformer 的性能相当。不过,与 Transformer 不同的是,Aaren 能高效处理时间序列数据,因此更适合与时间序列相关的领域。
    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存
    时间序列分类

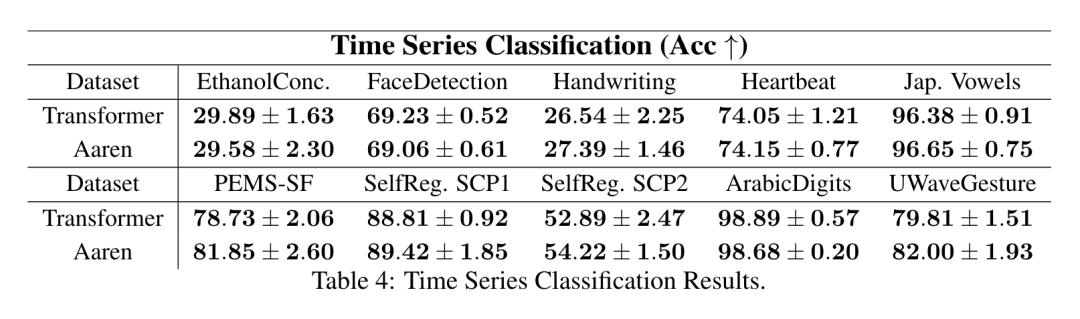
    接下来,作者比较了 Aaren 和 Transformer 在时间序列分类方面的表现。时间序列分类在许多重要的应用中很常见,例如模式识别(如心电图)、异常检测(如银行欺诈)或故障预测(如电网波动)。

    从表 4 中可以看出,在所有数据集上,Aaren 与 Transformer 的表现不相上下。
    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存
    分析

    最后,作者比较了 Aaren 和 Transformer 所需的资源。
    Bengio等人新作:注意力可被视为RNN,新模型媲美Transformer,但超级省内存
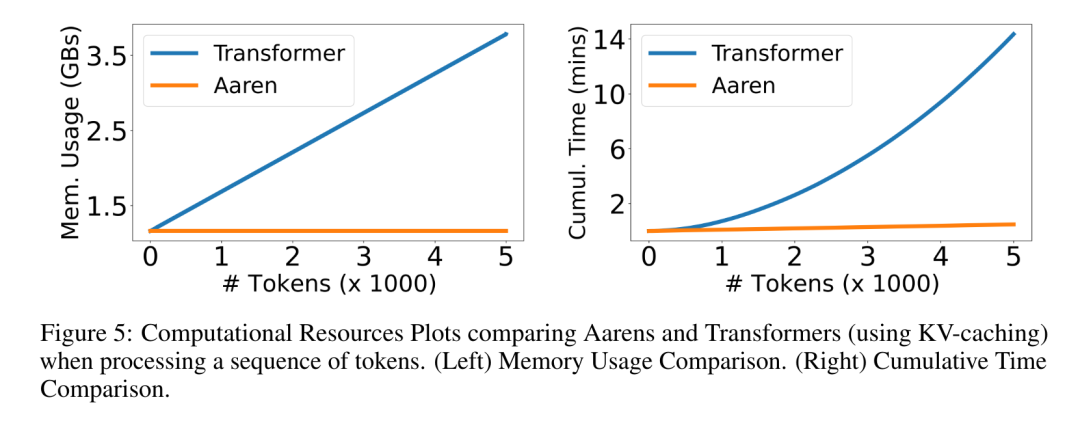
    内存复杂性:在图 5(左)中,作者比较了 Aaren 和 Transformer(使用 KV 缓存)在推理时的内存使用情况。可以看到,伴随 KV 缓存技术的使用,Transformer 的内存使用量呈线性增长。相比之下,Aaren 只使用恒定的内存,无论 token 数量如何增长,因此它的效率要高得多。

    时间复杂度:在图 5(右图)中,作者比较了 Aaren 和 Transformer(使用 KV 缓存)按顺序处理一串 token 所需的累计时间。对于 Transformer,累计计算量是 token 数的二次方,即 O (1 + 2 + ... + N) = O (N^2 )。相比之下,Aaren 的累计计算量是线性的。在图中,可以看到模型所需的累计时间也是类似的结果。具体来说,Transformer 所需的累计时间呈二次增长,而 Aaren 所需的累计时间呈线性增长。

    参数数量:由于要学习初始隐藏状态 q,Aaren 模块需要的参数略多于 Transformer 模块。不过,由于 q 只是一个向量,因此差别不大。通过在同类模型中进行实证测量,作者发现 Transformer 使用了 3, 152, 384 个参数。相比之下,等效的 Aaren 使用了 3, 152, 896 个参数,参数增加量仅为 0.016%—— 对于内存和时间复杂性的显著差异来说,这只是微不足道的代价。
    本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系bd@zhengruan.com
    作者最新文章
    业界资讯 理论
    相关文章 更多
    精品专题 更多
    装机必备

    正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

    Windows

    正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

    PDF教程

    正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。

    macOS软件

    正软商城macOS软件专区,精选适用于Mac电脑的办公、设计、影音、效率、开发和系统工具,提供软件功能介绍、macOS兼容版本、正版授权及购买下载服务。

    IOS软件

    正软商城iOS软件专区,精选适用于iPhone和iPad的办公、学习、影音、设计、效率及AI应用,提供功能介绍、适用设备、系统要求和正版获取方式等信息。

    AI

    正软商城AI软件专区,汇集AI写作、AI绘画、AI视频、AI办公、AI编程、AI翻译、智能客服和数据分析等人工智能工具,提供功能介绍、适用平台、收费方式及正版购买信息。

    Mac软件 更多
    Adobe Acrobat Pro macOS版
    Adobe Acrobat Pro macOS版

    Adobe Acrobat Pro 是面向办公、法务、财务、教育及出版用户的专业PDF处理软件,可在Mac上创建、编辑、转换、合并和保护文档,并提供OCR文字识别、表单、批注、内容比较、敏感信息遮盖及电子签名功能。
    Blender
    Blender

    Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

    Shapr3D macOS版
    Shapr3D macOS版

    Shapr3D是一款面向工业设计、机械工程、建筑概念和三维打印工作流的CAD软件。Mac版采用Parasolid建模内核,支持草图约束、实体建模、工程图、可视化渲染及常见CAD格式交换,并可通过账户在多台设备之间同步项目。

    Adobe Illustrator macOS版
    Adobe Illustrator macOS版

    Adobe Illustrator 是 Adobe 推出的专业矢量图形设计软件,适合在 Mac 上制作标志、图标、插画、包装、信息图及印刷版面。它以路径和锚点构建可无损缩放的图形,并提供钢笔、形状、文字、图像描摹、渐变、画板及生成式功能。

    Adobe InDesign macOS版
    Adobe InDesign macOS版

    Adobe InDesign 是面向印刷品与数字出版物的专业版面设计软件,可在 Mac 上制作书籍、杂志、宣传册、海报、报告及交互式文档。它提供精细的文字样式、网格、母版、长文档管理和印前输出能力。
    Affinity Designer macOS版
    Affinity Designer macOS版

    Affinity Designer 的矢量设计能力现已整合进 Affinity by Canva,可在 Mac 上进行标志、图标、插画、界面原型及印刷品设计。个人用户使用免费 Canva 账户即可使用完整的矢量、像素和版面工具。
    Archicad macOS版
    Archicad macOS版

    Archicad是Graphisoft推出的建筑信息模型设计软件,可在Mac上完成概念设计、参数化建模、图纸编制、工程量统计、渲染展示及团队协同。模型与平立剖面、明细表和布局保持关联,适合建筑师、室内设计师、BIM团队及相关专业学生使用。
    AutoCAD LT macOS版
    AutoCAD LT macOS版

    AutoCAD LT是Autodesk推出的专业二维CAD设计与文档编制软件,Mac版本提供原生界面、多点触控及分屏查看体验。用户可精确创建和编辑DWG图形,完成图层管理、尺寸标注、表格、PDF参考、外部参照及打印输出。

    AutoCAD macOS版
    AutoCAD macOS版

    AutoCAD for Mac 是 Autodesk 面向 macOS 提供的专业计算机辅助设计软件,支持精确的二维绘图、标注、布局输出以及实体、曲面和网格建模。软件采用适配 Mac 操作习惯的界面,可处理 DWG 图纸。
    Autodesk Fusion macOS版
    Autodesk Fusion macOS版

    Autodesk Fusion 是面向产品设计与制造的一体化云连接平台,在 Mac 上提供参数化建模、自由曲面、装配、工程图、仿真、PCB 设计和 CAM 加工等工具。它适合机械工程师、工业设计师、创客及制造团队使用。
    Autodesk Maya macOS版
    Autodesk Maya macOS版

    Autodesk Maya是一套面向影视动画、游戏开发和视觉特效制作的专业三维创作软件,集多边形与曲面建模、角色绑定、关键帧动画、动力学模拟、程序化特效及Arnold渲染于一体,并提供脚本、插件和开放式制作管线支持。
    Blender macOS版
    Blender macOS版

    Blender是一款免费开源的综合三维创作软件,可在Mac上完成建模、数字雕刻、材质制作、角色绑定、动画、物理模拟、渲染、合成及视频剪辑。软件提供Cycles与Eevee渲染工具,并支持几何节点、蜡笔绘制和Python扩展。

    WINDOWS 更多
    AutoCAD Windows版
    AutoCAD Windows版

    AutoCAD 是 Autodesk 推出的专业计算机辅助设计软件,Windows 版支持精确二维绘图、三维实体与曲面建模、图纸标注、布局发布和任务自动化,并包含多套行业专业化工具组合,适用于建筑、机械、电气、工程建设及制造设计人员。

    Adobe Acrobat Pro Windows版
    Adobe Acrobat Pro Windows版

    Adobe Acrobat Pro 是面向专业 PDF 工作的综合解决方案,可在 Windows 中创建、编辑、转换、比较、整理和保护文档,并支持表单、电子签名、扫描件文字识别及敏感信息永久遮盖。订阅还包含网页、移动服务和云端协作能力,

    Blender
    Blender

    Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

    3dmax(3ds max)
    3dmax(3ds max)

    Autodesk 3ds Max 是一款专业的三维建模、动画与渲染软件,广泛应用于建筑可视化、游戏开发、影视动画、广告设计和产品展示等领域。

    Adobe InDesign Windows版
    Adobe InDesign Windows版

    Adobe InDesign 是面向印刷与数字出版的专业页面排版工具,可制作书籍、杂志、宣传册、海报、交互式 PDF 和电子书。它提供精细的文字样式、多页面管理、印前检查及多格式输出能力,并能与 Photoshop、Illustrator

    Adobe Illustrator Windows版
    Adobe Illustrator Windows版

    Adobe Illustrator 是用于绘制矢量图形、插画、图标、徽标和版式的专业设计工具。它以路径和锚点为核心,作品放大后仍能保持清晰,并提供画板、文字、渐变、图像描摹及精确变换等功能,适合品牌视觉、印刷物料、数字界面和商业插画创作。

    Figma Windows版
    Figma Windows版

    Figma 是面向产品设计与开发团队的云端协作平台,可在 Windows 桌面客户端中完成界面绘制、组件管理、交互原型、评论评审和开发交付。文件保存在云端,多名成员能够同步编辑并共享设计系统;官方同时提供免费 Starter 方案及按席位计

    Affinity Designer Windows版
    Affinity Designer Windows版

    Affinity Designer 是面向矢量图形、数字插画和界面设计的专业创作工具,可在矢量、像素与导出工作区之间快速切换。它提供曲线编辑、形状构建、画板、排版、图层和专业色彩管理,并支持常见设计文件的导入及多种印刷、网页格式输出。
    Cinema 4D Windows版
    Cinema 4D Windows版

    Cinema 4D是Maxon推出的专业三维创作软件,将建模、动画、MoGraph动态图形、粒子与动力学模拟、材质灯光及Redshift渲染整合在统一工作环境中,适用于广告包装、影视特效、产品和建筑可视化、游戏素材等制作场景。
    Blender Windows版
    Blender Windows版

    Blender 是免费开源的三维创作套件,在 Windows 上提供建模、雕刻、材质、动画、物理模拟、合成、跟踪、视频剪辑及 Cycles、EEVEE 渲染工具。它适合个人创作者、学生和小型工作室,
    Autodesk Maya Windows版
    Autodesk Maya Windows版

    Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,
    SketchUp Pro Windows版
    SketchUp Pro Windows版

    SketchUp Pro 是面向建筑、室内、景观、施工和产品设计等专业场景的三维建模工具,提供桌面建模、LayOut 二维文档、模型资源库、扩展程序及云端协作能力。其操作逻辑直观,适合从概念推敲、空间规划到图纸表达和方案汇报的完整工作流程。