


Mysql数据库中的group by原理是什么?
1.使用groupby的简单例子groupby一般用于分组统计,它表达的逻辑就是根据一定的规则,进行分组。我们先从一个简单的例子,一起来复习一下哈。假设用一张员工表,表结构如下:CREATETABLE`staff`(`id`bigint(11)NOTNULLAUTO_INCREMENTCOMMENT'主键id',`id_card`varchar(20)NOTNULLCOMMENT'身份证号码',`name`varchar(64)NOTNULLCOMMENT'姓名&#
1. 使用group by的简单例子
group by一般用于分组统计,它表达的逻辑就是根据一定的规则,进行分组。我们先从一个简单的例子,一起来复习一下哈。
假设用一张员工表,表结构如下:
CREATE TABLE `staff` (
  `id` bigint(11) NOT NULL AUTO_INCREMENT COMMENT '主键id',
  `id_card` varchar(20) NOT NULL COMMENT '身份证号码',
  `name` varchar(64) NOT NULL COMMENT '姓名',
  `age` int(4) NOT NULL COMMENT '年龄',
  `city` varchar(64) NOT NULL COMMENT '城市',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=15 DEFAULT CHARSET=utf8 COMMENT='员工表';
表存量的数据如下:
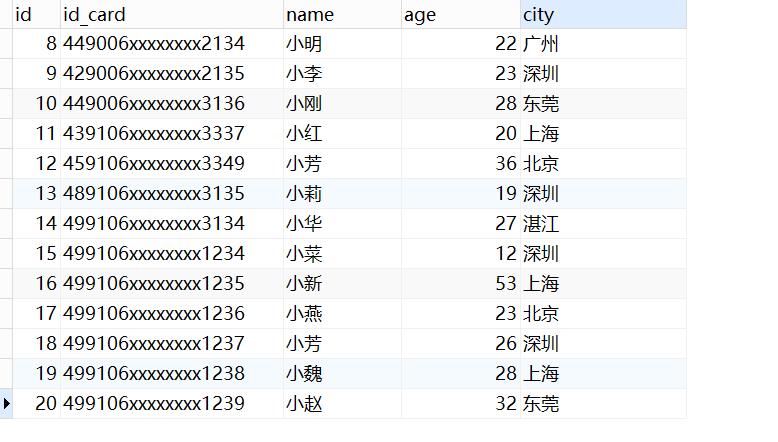
我们现在有这么一个需求:统计每个城市的员工数量。对应的 SQL 语句就可以这么写:
select city ,count(*) as num from staff group by city;
执行结果如下:
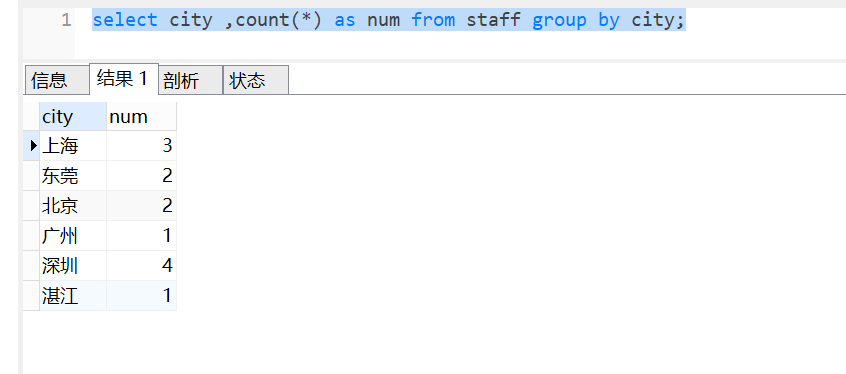
这条SQL语句的逻辑很清楚啦,但是它的底层执行流程是怎样的呢?
2. group by 原理分析
2.1 explain 分析
我们先用explain查看一下执行计划
explain select city ,count(*) as num from staff group by city;
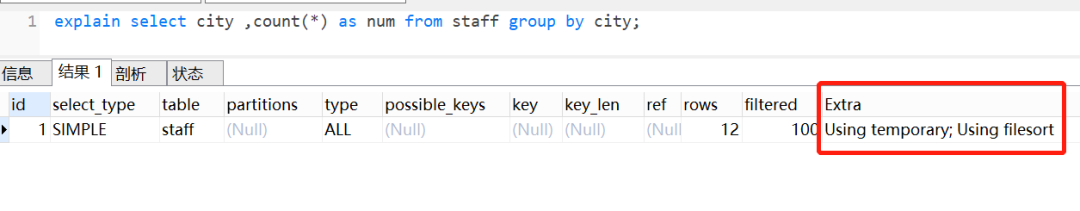
Extra 这个字段的Using temporary表示在执行分组的时候使用了临时表
Extra 这个字段的Using filesort表示使用了排序
group by 怎么就使用到临时表和排序了呢?我们来看下这个SQL的执行流程
2.2 group by 的简单执行流程
explain select city ,count(*) as num from staff group by city;
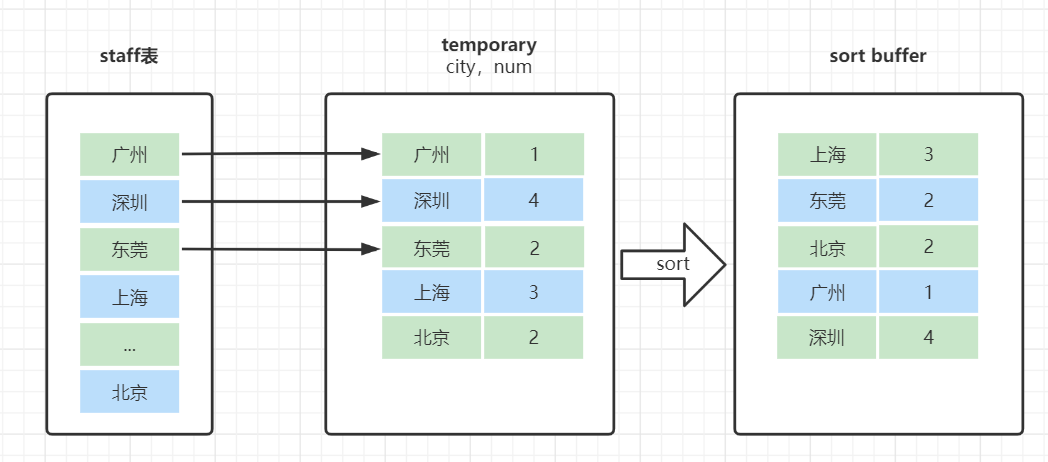
我们一起来看下这个SQL的执行流程哈
创建内存临时表,表里有两个字段city和num;
全表扫描staff的记录,依次取出city = 'X'的记录。
判断临时表中是否有为 city='X'的行,没有就插入一个记录 (X,1);
如果临时表中有city='X'的行的行,就将x 这一行的num值加 1;
遍历完成后,再根据字段city做排序,得到结果集返回给客户端。
这个流程的执行图如下:
临时表的排序是怎样的呢?
就是把需要排序的字段,放到sort buffer,排完就返回。在这里注意一点哈,排序分全字段排序和rowid排序
如果是全字段排序,需要查询返回的字段,都放入sort buffer,根据排序字段排完,直接返回
如果是rowid排序,只是需要排序的字段放入sort buffer,然后多一次回表操作,再返回。
怎么确定走的是全字段排序还是rowid 排序排序呢?由一个数据库参数控制的,max_length_for_sort_data
对排序有兴趣深入了解的小伙伴,可以看我这篇文章哈。
看一遍就理解:order by详解
3. where 和 having的区别
group by + where 的执行流程
group by + having 的执行流程
同时有where、group by 、having的执行顺序
3.1 group by + where 的执行流程
有些小伙伴觉得上一小节的SQL太简单啦,如果加了where条件之后,并且where条件列加了索引呢,执行流程是怎样?
好的,我们给它加个条件,并且加个idx_age的索引,如下:
select city ,count(*) as num from staff where age> 30 group by city;
//加索引
alter table staff add index idx_age (age);
再来expain分析一下:
explain select city ,count(*) as num from staff where age> 30 group by city;
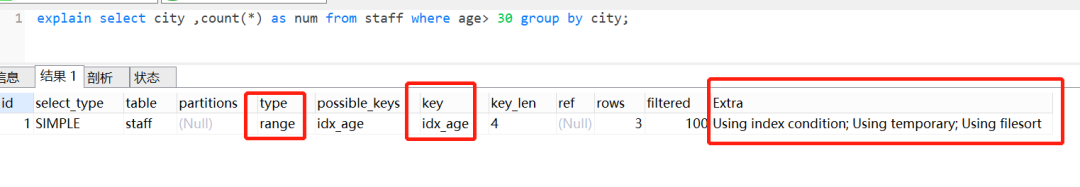
从explain 执行计划结果,可以发现查询条件命中了idx_age的索引,并且使用了临时表和排序
Using index condition:
表示索引下推优化,根据索引尽可能的过滤数据,然后再返回给服务器层根据where其他条件进行过滤。这里单个索引为什么会出现索引下推呢?explain出现并不代表一定是使用了索引下推,只是代表可以使用,但是不一定用了。大家如果有想法或者有疑问,可以加我微信讨论哈。
执行流程如下:
创建内存临时表,表里有两个字段city和num;
扫描索引树idx_age,找到大于年龄大于30的主键ID
通过主键ID,回表找到city = 'X'
判断临时表中是否有为 city='X'的行,没有就插入一个记录 (X,1);
如果临时表中有city='X'的行的行,就将x 这一行的num值加 1;
继续重复2,3步骤,找到所有满足条件的数据,
最后根据字段city做排序,得到结果集返回给客户端。
3.2 group by + having 的执行
如果你要查询每个城市的员工数量,获取到员工数量不低于3的城市,having可以很好解决你的问题,SQL酱紫写:
select city ,count(*) as num from staff group by city having num >= 3;
查询结果如下:
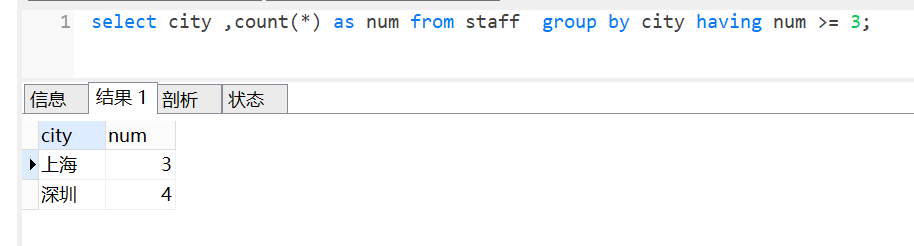
having称为分组过滤条件,它对返回的结果集操作。
3.3 同时有where、group by 、having的执行顺序
如果一个SQL同时含有where、group by、having子句,执行顺序是怎样的呢。
比如这个SQL:
select city ,count(*) as num from staff where age> 19 group by city having num >= 3;
执行where子句查找符合年龄大于19的员工数据
group by子句对员工数据,根据城市分组。
对group by子句形成的城市组,运行聚集函数计算每一组的员工数量值;
最后用having子句选出员工数量大于等于3的城市组。
3.4 where + having 区别总结
having子句用于分组后筛选,where子句用于行条件筛选
having一般都是配合group by 和聚合函数一起出现如(count(),sum(),avg(),max(),min())
where条件子句中不能使用聚集函数,而having子句就可以。
having只能用在group by之后,where执行在group by之前
4. 使用 group by 注意的问题
使用group by 主要有这几点需要注意:
group by一定要配合聚合函数一起使用嘛?
group by的字段一定要出现在select中嘛
group by导致的慢SQL问题
4.1 group by一定要配合聚合函数使用嘛?
group by 就是分组统计的意思,一般情况都是配合聚合函数如(count(),sum(),avg(),max(),min())一起使用。
count() 数量
sum() 总和
avg() 平均
max() 最大值
min() 最小值
如果没有配合聚合函数使用可以吗?
我用的是Mysql 5.7 ,是可以的。不会报错,并且返回的是,分组的第一行数据。
比如这个SQL:
select city,id_card,age from staff group by city;
查询结果是
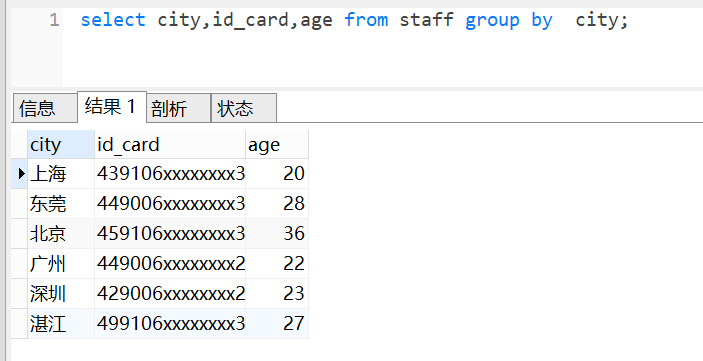
大家对比看下,返回的就是每个分组的第一条数据
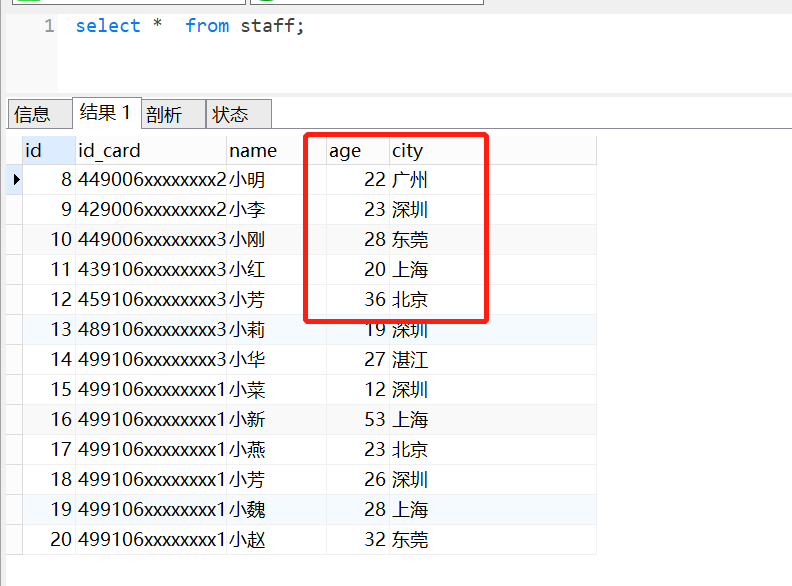
当然,平时大家使用的时候,group by还是配合聚合函数使用的,除非一些特殊场景,比如你想去重,当然去重用distinct也是可以的。
4.2 group by 后面跟的字段一定要出现在select中嘛。
不一定,比如以下SQL:
select max(age) from staff group by city;
执行结果如下:
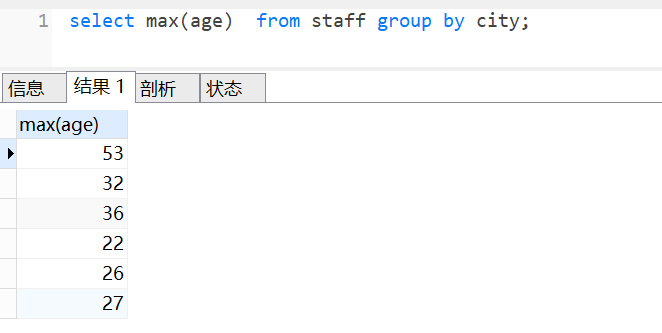
分组字段city不在select 后面,并不会报错。当然,这个可能跟不同的数据库,不同的版本有关吧。大家使用的时候,可以先验证一下就好。有一句话叫做,纸上得来终觉浅,绝知此事要躬行。
4.3 group by导致的慢SQL问题
到了最重要的一个注意问题啦,group by使用不当,很容易就会产生慢SQL 问题。因为它既用到临时表,又默认用到排序。有时候还可能用到磁盘临时表。
如果执行过程中,会发现内存临时表大小到达了上限(控制这个上限的参数就是tmp_table_size),会把内存临时表转成磁盘临时表。
如果数据量很大,很可能这个查询需要的磁盘临时表,就会占用大量的磁盘空间。
这些都是导致慢SQL的x因素,我们一起来探讨优化方案哈。
5. group by的一些优化方案
从哪些方向去优化呢?
方向1:既然它默认会排序,我们不给它排是不是就行啦。
方向2:既然临时表是影响group by性能的X因素,我们是不是可以不用临时表?
我们一起来想下,执行group by语句为什么需要临时表呢?group by的语义逻辑,就是统计不同的值出现的个数。如果这个这些值一开始就是有序的,我们是不是直接往下扫描统计就好了,就不用临时表来记录并统计结果啦?
group by 后面的字段加索引
order by null 不用排序
尽量只使用内存临时表
使用SQL_BIG_RESULT
5.1 group by 后面的字段加索引
如何保证group by后面的字段数值一开始就是有序的呢?当然就是加索引啦。
我们回到一下这个SQL
select city ,count(*) as num from staff where age= 19 group by city;
它的执行计划
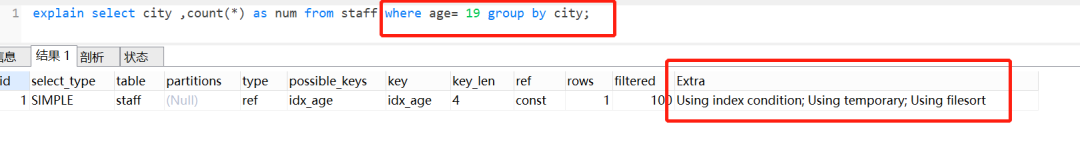
如果我们给它加个联合索引idx_age_city(age,city)
alter table staff add index idx_age_city(age,city);
再去看执行计划,发现既不用排序,也不需要临时表啦。
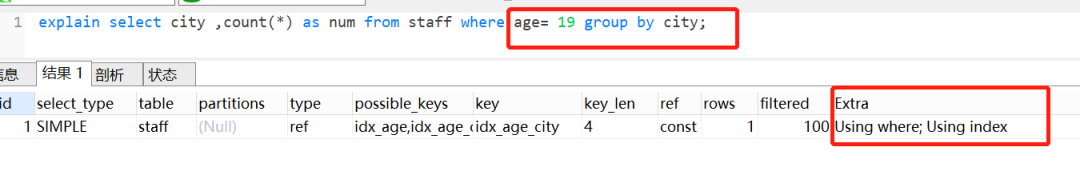
加合适的索引是优化group by最简单有效的优化方式。
5.2 order by null 不用排序
并不是所有场景都适合加索引的,如果碰上不适合创建索引的场景,我们如何优化呢?
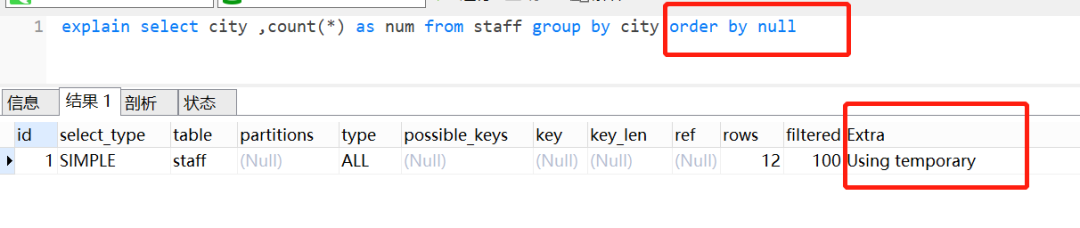
如果你的需求并不需要对结果集进行排序,可以使用order by null。
select city ,count(*) as num from staff group by city order by null
执行计划如下,已经没有filesort啦
5.3 尽量只使用内存临时表
如果group by需要统计的数据不多,我们可以尽量只使用内存临时表;因为如果group by 的过程因为内存临时表放不下数据,从而用到磁盘临时表的话,是比较耗时的。因此可以适当调大tmp_table_size参数,来避免用到磁盘临时表。
5.4 使用SQL_BIG_RESULT优化
如果数据量实在太大怎么办呢?总不能无限调大tmp_table_size吧?但也不能眼睁睁看着数据先放到内存临时表,随着数据插入发现到达上限,再转成磁盘临时表吧?这样就有点不智能啦。
因此,如果预估数据量比较大,我们使用SQL_BIG_RESULT 这个提示直接用磁盘临时表。MySQl优化器发现,磁盘临时表是B+树存储,存储效率不如数组来得高。因此会直接用数组来存
示例SQl如下:
select SQL_BIG_RESULT city ,count(*) as num from staff group by city;
执行计划的Extra字段可以看到,执行没有再使用临时表,而是只有排序
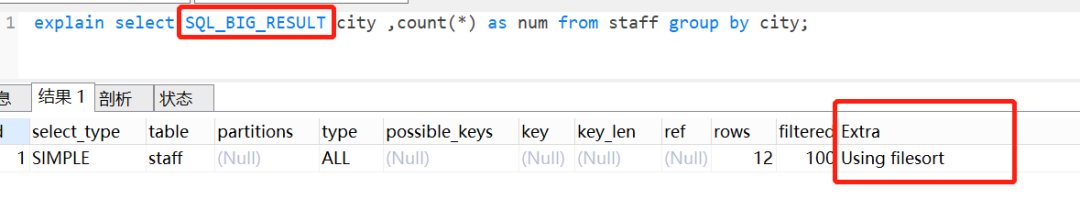
执行流程如下:
初始化 sort_buffer,放入city字段;
扫描表staff,依次取出city的值,存入 sort_buffer 中;
扫描完成后,对 sort_buffer的city字段做排序
排序完成后,就得到了一个有序数组。
根据有序数组,统计每个值出现的次数。
6. 一个生产慢SQL如何优化
最近遇到个生产慢SQL,跟group by相关的,给大家看下怎么优化哈。
表结构如下:
CREATE TABLE `staff` (
  `id` bigint(11) NOT NULL AUTO_INCREMENT COMMENT '主键id',
  `id_card` varchar(20) NOT NULL COMMENT '身份证号码',
  `name` varchar(64) NOT NULL COMMENT '姓名',
  `status` varchar(64) NOT NULL COMMENT 'Y-已激活 I-初始化 D-已删除 R-审核中',
  `age` int(4) NOT NULL COMMENT '年龄',
  `city` varchar(64) NOT NULL COMMENT '城市',
  `enterprise_no` varchar(64) NOT NULL COMMENT '企业号',
  `legal_cert_no` varchar(64) NOT NULL COMMENT '法人号码',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=15 DEFAULT CHARSET=utf8 COMMENT='员工表';
查询的SQL是这样的:
select * from t1 where status = #{status} group by #{legal_cert_no} 















火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,