


MySQL索引优化的常用方法有哪些?
这篇文章主要介绍“MySQL索引优化的方法”,在日常操作中,相信很多人在MySQL索引优化的方法问题上存在疑惑,小编查阅了各式资料,整理出简单好用的操作方法,希望对大家解答”MySQL索引优化的方法”的疑惑有所帮助!接下来,请跟着小编一起来学习吧!1.数据准备#1.建立员工表,并创建name,age,position索引,id为自增主键CREATETABLE`employees`(`id`int(11)NOTNULLAUTO_INCREMENT,`name`varchar(24)NOTNULLDEFAUL
这篇文章主要介绍“MySQL索引优化的方法”,在日常操作中,相信很多人在MySQL索引优化的方法问题上存在疑惑,小编查阅了各式资料,整理出简单好用的操作方法,希望对大家解答”MySQL索引优化的方法”的疑惑有所帮助!接下来,请跟着小编一起来学习吧!
1.数据准备
#1.建立员工表,并创建name,age,position索引,id为自增主键
CREATE TABLE `employees` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `name` varchar(24) NOT NULL DEFAULT '' COMMENT '姓名',
  `age` int(11) NOT NULL DEFAULT '0' COMMENT '年龄',
  `position` varchar(20) NOT NULL DEFAULT '' COMMENT '职位',
  `hire_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '入职时间',
  PRIMARY KEY (`id`),
  KEY `idx_name_age_position` (`name`,`age`,`position`) USING BTREE
) ENGINE=InnoDB AUTO_INCREMENT=100010 DEFAULT CHARSET=utf8 COMMENT='员工记录表'

# 2.前面插入三条数据,并建立employees_min_copy表插入这三条数据
INSERT INTO employees (name,age,`position`,hire_time) VALUES
('LiLei',22,'manager','2021-08-17 21:00:55')
,('HanMeimei',23,'dev','2021-08-17 21:00:55')
,('Lucy',23,'dev','2021-08-17 21:00:55')
;
#3.再通过执行计划向表中插入十万条数据
#3.1建立存储过程,往employees表中插入数据(MySQL8.0版本)
DELIMITER $$
USE `zhebase`$$
DROP PROCEDURE IF EXISTS `batch_insert_employees`$$
CREATE PROCEDURE `batch_insert_employees`(IN `start_number` BIGINT,IN `counts` BIGINT)
BEGIN
    DECLARE start_number BIGINT DEFAULT start_number;
    DECLARE stop_number BIGINT DEFAULT start_number;
    SET stop_number=start_number + counts;
    WHILE start_number < stop_number DO
        INSERT INTO employees(name,age,position,hire_time) VALUES(CONCAT('zhang',start_number),start_number,'dev',now());
        SET start_number=start_number+1;
    END WHILE ;
    COMMIT;
END$$
DELIMITER ;

#3.2执行存储过程插入十万条数据
CALL batch_insert_employees(1,100000);
2.实例一
1.联合索引第一个字段用范围不会走索引
EXPLAIN SELECT * FROM employees WHERE name > 'LiLei' AND age = 22 AND position ='manager';

原因:MySQL 内部可能觉得第一个字段就用范围,结果集应该很大,还需要回表,回表效率不高,不如直接采用全表扫描 但是我们可以强制走索引
EXPLAIN SELECT * FROM employees force index(idx_name_age_position) WHERE name > 'LiLei' AND age = 22 AND position ='manager';

-- 关闭查询缓存
set global query_cache_size=0;
set global query_cache_type=0;
-- 执行时间0.321s
SELECT * FROM employees WHERE name > 'LiLei';
-- 执行时间0.458s
SELECT * FROM employees force index(idx_name_age_position) WHERE name > 'LiLei';

使用了强制走索引让联合索引第一个字段范围查找也走索引,扫描的行rows看上去也少了点,但是最终查找效率不一定比全表扫描高,因为回表效率不高
对于这种情况,如果可以使用覆盖索引,就使用覆盖索引进行优化
EXPLAIN SELECT name,age,position FROM employees WHERE name > 'LiLei' AND age = 22 AND position ='manager';

2.in 和 or 在表数据量比较大的情况会走索引,在表记录不多的情况下会选择全表扫描
EXPLAIN SELECT * FROM employees
WHERE name in ('LiLei','HanMeimei','Lucy')
AND age = 22
AND position ='manager';
#表数据量大走索引,数据量小全表扫描
EXPLAIN SELECT * FROM employees
WHERE (name = 'LiLei' or name = 'HanMeimei')
AND age = 22
AND position ='manager';
将十万行数据的employees表复制一份插入几行数据,再进行查询

发现进行了全表扫描

3.like xx% 无论数据量多少一般情况都会走索引
EXPLAIN SELECT * FROM employees WHERE name like 'LiLei%' AND age = 22 AND position ='manager';

MySQL 底层使用索引下推(Index Condition Pushdown,ICP) 来对 like xx%进行优化。
索引下推: 对于辅助的联合索引(idx_name_age_position),通常按照最左前缀原则,SELECT * FROM employees WHERE name like 'LiLei%' AND age = 22 AND position ='manager' 因为在 name 是范围查询,过滤完后,age 和 position 是无序的,后续索引无法使用,只会走name字段索引。
MySQL5.6 以前: 先在索引树中匹配 name 是 'LiLei' 开头的索引,然后根据索引下的主键进行回表操作,在主键索引上在匹配 age 和 position
MySQL 5.6以后: 引入索引下推,先在索引树种匹配 name 是 'LiLei' 开头的索引,同时将该所与树通有的所有条件字段进行判断,过滤掉不符合条件的记录再回表匹配其他条件及查询整行数据。
优点: 过滤掉不符合条件的记录之后再回表,可以有效的减少回表次数,提高查询效率。
MySQL 范围查找为什么没有使用索引下推优化? 可能因为范围查找结果集一般较大,like xx%在大多数情况下,过滤后结果集较小。而结果集大的时候,每次检索出来都要匹配后面的字段,不一定比立即回表要快。但是也不是绝对的,有些时候 Like xx%也不会走索引下推。
3.MySQL如何选择合适的索引?
先来看两条 SQL 语句:
# MySQL直接使用全表扫描
EXPLAIN select * from employees where name > 'a';
# MySQL走索引
EXPLAIN select * from employees where name > 'zzz';
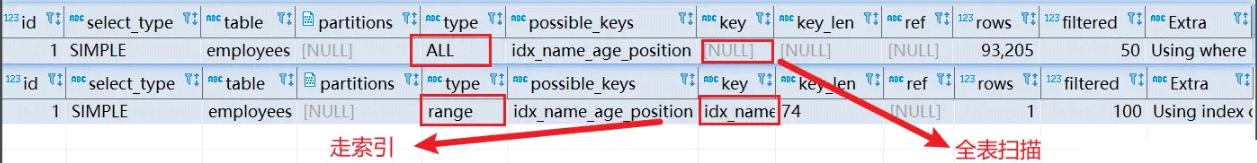
我们发现第一条 SQL 进行了全表扫描,第二条 SQL 走了索引。对应第一条SQL,MySQL 通过计算执行成本发现走索引成本比全部扫描更高(走索引需要遍历 name 字段,再进行回表操作查出最终数据,比直接查聚簇索引树更慢)。对于这种情况可以使用覆盖索引进行优化。至于 MySQL 如何选择最终索引,可以用 Trace 工具进行查看。但开启trace工具会影响 MySQL 性能,用完之后需立即关闭。
#开启trace
set session optimizer_trace="enabled=on",end_markers_in_json=on;
#关闭trace
set session optimizer_trace="enabled=off";
#使用trace
select * from employees where name > 'a' order by position;
select * from information_schema.OPTIMIZER_TRACE;

下面是执行后的Trace中的内容:
{
  "steps": [
    {
      #第一阶段:SQL准备阶段,格式化sql
      "join_preparation": {
        "select#": 1,
        "steps": [
          {
            "expanded_query": "/* select#1 */ select `employees`.`id` AS `id`,`employees`.`name` AS `name`,`employees`.`age` AS `age`,`employees`.`position` AS `position`,`employees`.`hire_time` AS `hire_time` from `employees` where (`employees`.`name` > 'a') order by `employees`.`position` limit 0,200"
          }
        ] /* steps */
      } /* join_preparation */
    },
    {
      #第二阶段:SQL优化阶段
      "join_optimization": {
        "select#": 1,
        "steps": [
          {
            #条件处理
            "condition_processing": {
              "condition": "WHERE",
              "original_condition": "(`employees`.`name` > 'a')",
              "steps": [
                {
                  "transformation": "equality_propagation",
                  "resulting_condition": "(`employees`.`name` > 'a')"
                },
                {
                  "transformation": "constant_propagation",
                  "resulting_condition": "(`employees`.`name` > 'a')"
                },
                {
                  "transformation": "trivial_condition_removal",
                  "resulting_condition": "(`employees`.`name` > 'a')"
                }
              ] /* steps */
            } /* condition_processing */
          },
          {
            "substitute_generated_columns": {
            } /* substitute_generated_columns */
          },
          {
            #表依赖详情
            "table_dependencies": [
              {
                "table": "`employees`",
                "row_may_be_null": false,
                "map_bit": 0,
                "depends_on_map_bits": [
                ] /* depends_on_map_bits */
              }
            ] /* table_dependencies */
          },
          {
            "ref_optimizer_key_uses": [
            ] /* ref_optimizer_key_uses */
          },
          {
            #预估表的访问成本
            "rows_estimation": [
              {
                "table": "`employees`",
                "range_analysis": {
                  "table_scan": { --全表扫描情况
                    "rows": 93205, --扫描行数
                    "cost": 9394.9 --查询成本
                  } /* table_scan */,
                  #查询可能使用的索引
                  "potential_range_indexes": [
                    {
                      "index": "PRIMARY",  --主键索引
                      "usable": false, -- 是否使用
                      "cause": "not_applicable"
                    },
                    {
                      #辅助索引
                      "index": "idx_name_age_position",
                      "usable": true,
                      "key_parts": [
                        "name",
                        "age",
                        "position",
                        "id"
                      ] /* key_parts */
                    }
                  ] /* potential_range_indexes */,
                  "setup_range_conditions": [
                  ] /* setup_range_conditions */,
                  "group_index_range": {
                    "chosen": false,
                    "cause": "not_group_by_or_distinct"
                  } /* group_index_range */,
                  "skip_scan_range": {
                    "potential_skip_scan_indexes": [
                      {
                        "index": "idx_name_age_position",
                        "usable": false,
                        "cause": "query_references_nonkey_column"
                      }
                    ] /* potential_skip_scan_indexes */
                  } /* skip_scan_range */,
                  #分析各个索引使用成本
                  "analyzing_range_alternatives": {
                    "range_scan_alternatives": [
                      {
                        "index": "idx_name_age_position",
                        "ranges": [
                          "a < name" --索引使用范围
                        ] /* ranges */,
                        "index_dives_for_eq_ranges": true,
                        "rowid_ordered": false, --使用该索引获取的记录是否按照主键排序
                        "using_mrr": false,
                        "index_only": false, --是否使用覆盖索引
                        "rows": 46602, --索引扫描行数
                        "cost": 16311, --索引使用成本
                        "chosen": false, --是否选择该索引
                        "cause": "cost"
                      }
                    ] /* range_scan_alternatives */,
                    "analyzing_roworder_intersect": {
                      "usable": false,
                      "cause": "too_few_roworder_scans"
                    } /* analyzing_roworder_intersect */
                  } /* analyzing_range_alternatives */
                } /* range_analysis */
              }
            ] /* rows_estimation */
          },
          {
            "considered_execution_plans": [
              {
                "plan_prefix": [
                ] /* plan_prefix */,
                "table": "`employees`",
                "best_access_path": { --最优访问路径
                  "considered_access_paths": [ --最终选择的访问路径
                    {
                      "rows_to_scan": 93205,
                      "filtering_effect": [
                      ] /* filtering_effect */,
                      "final_filtering_effect": 0.5,
                      "access_type": "scan", --访问类型:为scan,全表扫描
                      "resulting_rows": 46602,
                      "cost": 9392.8,
                      "chosen": true  --确定选择
                    }
                  ] /* considered_access_paths */
                } /* best_access_path */,
                "condition_filtering_pct": 100,
                "rows_for_plan": 46602,
                "cost_for_plan": 9392.8,
                "chosen": true
              }
            ] /* considered_execution_plans */
          },
          {
            "attaching_conditions_to_tables": {
              "original_condition": "(`employees`.`name` > 'a')",
              "attached_conditions_computation": [
                {
                  "table": "`employees`",
                  "rechecking_index_usage": {
                    "recheck_reason": "low_limit",
                    "limit": 200,
                    "row_estimate": 46602
                  } /* rechecking_index_usage */
                }
              ] /* attached_conditions_computation */,
              "attached_conditions_summary": [
                {
                  "table": "`employees`",
                  "attached": "(`employees`.`name` > 'a')"
                }
              ] /* attached_conditions_summary */
            } /* attaching_conditions_to_tables */
          },
          {
            "optimizing_distinct_group_by_order_by": {
              "simplifying_order_by": {
                "original_clause": "`employees`.`position`",
                "items": [
                  {
                    "item": "`employees`.`position`"
                  }
                ] /* items */,
                "resulting_clause_is_simple": true,
                "resulting_clause": "`employees`.`position`"
              } /* simplifying_order_by */
            } /* optimizing_distinct_group_by_order_by */
          },
          {
            "reconsidering_access_paths_for_index_ordering": {
              "clause": "ORDER BY",
              "steps": [
              ] /* steps */,
              "index_order_summary": {
                "table": "`employees`",
                "index_provides_order": false,
                "order_direction": "undefined",
                "index": "unknown",
                "plan_changed": false
              } /* index_order_summary */
            } /* reconsidering_access_paths_for_index_ordering */
          },
          {
            "finalizing_table_conditions": [
              {
                "table": "`employees`",
                "original_table_condition": "(`employees`.`name` > 'a')",
                "final_table_condition   ": "(`employees`.`name` > 'a')"
              }
            ] /* finalizing_table_conditions */
          },
          {
            "refine_plan": [
              {
                "table": "`employees`"
              }
            ] /* refine_plan */
          },
          {
            "considering_tmp_tables": [
              {
                "adding_sort_to_table_in_plan_at_position": 0
              } /* filesort */
            ] /* considering_tmp_tables */
          }
        ] /* steps */
      } /* join_optimization */
    },
    {
      #第三阶段:SQL执行阶段
      "join_execution": {
        "select#": 1,
        "steps": [
          {
            "sorting_table_in_plan_at_position": 0,
            "filesort_information": [
              {
                "direction": "asc",
                "table": "`employees`",
                "field": "position"
              }
            ] /* filesort_information */,
            "filesort_priority_queue_optimization": {
              "limit": 200,
              "chosen": true
            } /* filesort_priority_queue_optimization */,
            "filesort_execution": [
            ] /* filesort_execution */,
            "filesort_summary": {
              "memory_available": 262144,
              "key_size": 40,
              "row_size": 186,
              "max_rows_per_buffer": 201,
              "num_rows_estimate": 285696,
              "num_rows_found": 100003,
              "num_initial_chunks_spilled_to_disk": 0,
              "peak_memory_used": 38994,
              "sort_algorithm": "std::stable_sort",
              "unpacked_addon_fields": "using_priority_queue",
              "sort_mode": ""
            } /* filesort_summary */
          }
        ] /* steps */
      } /* join_execution */
    }
  ] /* steps */
}
由 Trace字段可知,全表扫描的 cost_for_plan = 9394.9 小于使用索引 cost_for_plan = 16311,故最终选择全表扫描。
4.常见 SQL 深入优化
4.1.Order by与Group by优化
# 案例1
explain select * from employees where name = 'Lucy' and position = 'dev' order by age;
分析: 案例1 由最左前缀法则分析出索引中间不能出现断层,只使用了 name 索引前缀,也可以从key_len = 3n + 2 看出。age 索引列用在排序过程中,因为Extra字段里没有 Using filesort 而是 Using index condition 。

#案例2
explain select * from employees where name = 'Lucy'  order by position;
分析: 案例2 索引查询使用了 name 索引前缀,但排序由于跳过了 age 所以Extra字段出现了 Using filesort 。
#案例3
explain select * from employees where name = 'Lucy'  order by age, position;

分析: 案例3 查询时使用了 name 索引,age 和 postion 用于排序,不会出现 Using filesort
#案例4
explain select * from employees where name = 'Lucy'  order by position,age;

分析: 案例4 查询时使用了 name 索引,age 和 postion 顺序与创建索引树不一致,出现了 Using filesort

#案例5
explain
select * from employees
where name = 'Lucy'
and age = 22
order by position,age;

分析: 案例5 查询时使用了 name 索引,age 和 postion 顺序与创建索引树不一致,但 name、age 为常量,MySQL 会自动优化,不会出现 Using filesort
#案例6
explain select * from employees where name = 'Lucy' order byage,position desc;

分析: 案例6 排序顺序一样,但 order by 默认升序,导致与索引的排序方式不同,出现了 Using filesort 。 MySQL8.0 以上版本有降序索引可以支持这种查询。
#案例7
explain select * from employees where name = 'Lucy' or name = 'LiLei' order by age;

分析: 案例7 对于排序来说,多个相等条件也是范围查询,出现了 Using filesort 。
#案例8
#SQL-1
explain select * from employees where name > 'zzz' order by name;
#SQL-2
explain select * from employees where name > 'a' order by name;

分析: 案例8 原因同前面的例子,可以使用覆盖索引优化。
MySQL排序总结:
1、MySQL支持两种方式的排序 filesort 和 index,Using index是指MySQL扫描索引本身完成排序。Using filesort 是指MySQL扫描聚簇索引(整张表)进行排序。index效率高,filesort效率低。
2、order by 满足两种情况会使用 Using index(不绝对)
a.order by 语句使用索引最左前列。
b.使用 where 子句与 order by 子句条件列组合满足索引最左前列。
3、尽量在索引列上完成排序,遵循最左前缀法则。
4、如果 order by 的条件不在索引列上,就会产生Using filesort。
5、能用覆盖索引尽量用覆盖索引
6、group by 与 order by 很类似,其实质是先排序后分组(group by 底层:先执行一次 order by 再进行分组),遵照索引创建顺序的最左前缀法则。对于group by的优化如果不需要排序的可以加上order by null 禁止排序。注意,where高于having,能写在where中的限定条件就不要去having限定了。
Using filesort 文件排序原理 filesort文件排序方式有:
单路排序:是一次性取出满足条件行的所有字段,然后在 sort buffer 中进行排序。用trace工具得到sort_mode信息显示< sort_key, additional_fields >或者< sort_key, packed_additional_fields >
双路排序(又叫回表排序模式) :先根据相应的条件取出相应的排序字段和可以直接定位行数据的行 ID,然后在 sort buffer 中进行排序,排序完后需要再次取回其它需要的字段。用trace工具得到sort_mode信息显示< sort_key, rowid >
MySQL 通过比较系统变量 max_length_for_sort_data(默认1024字节) 的大小和需要查询的字段总大小来判断使用哪种排序模式。
字段的总长度 < max_length_for_sort_data ,使用单路排序
字段的总长度 >max_length_for_sort_data ,使用双路排序
select * from employees where name = 'Lucy' order by position;
"join_execution": {    --Sql执行阶段
        "select#": 1,
        "steps": [
          {
            "filesort_information": [
              {
                "direction": "asc",
                "table": "`employees`",
                "field": "position"
              }
            ] /* filesort_information */,
            "filesort_priority_queue_optimization": {
              "usable": false,
              "cause": "not applicable (no LIMIT)"
            } /* filesort_priority_queue_optimization */,
            "filesort_execution": [
            ] /* filesort_execution */,
            "filesort_summary": {                      --文件排序信息
              "rows": 10000,                           --预计扫描行数
              "examined_rows": 10000,                  --参与排序的行
              "number_of_tmp_files": 3,                --使用临时文件的个数,如果为0代表全部使用的sort_buffer内存排序,否则使用的磁盘文件排序
              "sort_buffer_size": 262056,              --排序缓存的大小,单位Byte
              "sort_mode": ""       --排序方式,此处是路排序
            } /* filesort_summary */
          }
        ] /* steps */
      } /* join_execution */
单路排序会把所有需要查询的字段都放到 sort buffer 中排序,而双路排序只会把主键和需要排序的字段放到 sort buffer 中进行排序,然后再通过主键回到原表查询需要的字段。
单路排序过程:
a.从索引 name 找到第一个满足 name = 'Lucy' 条件的主键 id
b.回表根据主键 id 取出整行,取出所有字段的值,存入 sort_buffer 中
c.从索引name找到下一个满足 name = 'Lucy' 条件的主键 id
d.重复步骤 2、3 直到不满足 name = 'Lucy'
e.对 sort_buffer 中的数据按照字段 position 进行排序
f.返回结果
双路排序过程:
a.从索引 name 找到第一个满足 name ='Lucy' 的主键 id
b.根据主键 id 取出整行,把排序字段 position 和主键 id 这两个字段放到 sort buffer 中
c.从索引 name 取下一个满足 name = 'Lucy' 记录的主键 id
d.重复 3、4 直到不满足 name = 'Lucy'
e.对 sort_buffer 中的字段 position 和主键 id 按照字段 position 进行排序
f.遍历排序好的 id 和字段 position,按照 id 的值回到原表中取出所有字段的值返回
4.2.分页查询优化
select * from employees limit 10000,10
这条 SQL 语句实际查询了 10010 条记录,然后丢弃了前面的 10000 条记录,所以,在 数据量很大时,执行效率是非常非常低的。一般需要对分页查询进行优化。 优化方法: 1.根据自增且连续的主键排序的分页查询
select * from employees where id > 90000 limit 5;
当一个表的主键连续且自增时,可以使用该方法进行优化,但如果自增不连续会造成数据丢失。
2.根据非主键字段排序的分页查询
#优化前
select * from employees ORDER BY name limit 90000,5;
#优化后
select * from employees e
inner join (select id from employees order by name limit 90000,5) ed
on e.id = ed.id;
先通过排序和分页操作先查出主键,然后根据主键查出对应的记录。

4.3.join关联查询优化
4.3.1.数据准备
#示例表
# 创建t1,t2表,主键id,单值索引a
CREATE TABLE `t1` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `a` int(11) DEFAULT NULL,
  `b` int(11) DEFAULT NULL,
  PRIMARY KEY (`id`),
  KEY `idx_a` (`a`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;
create table t2 like t1;
#存储过程往t1,t2表插入数据
DELIMITER $$
USE `zhebase`$$
DROP PROCEDURE IF EXISTS `batch_insert_t1`$$
CREATE PROCEDURE `batch_insert_t1`(IN `start_number` BIGINT,IN `counts` BIGINT)
BEGIN
    DECLARE start_number BIGINT DEFAULT start_number;
    DECLARE stop_number BIGINT DEFAULT start_number;
    SET stop_number=start_number + counts;
    WHILE start_number < stop_number DO
        INSERT INTO t1(a,b) VALUES(start_number,start_number);
        SET start_number=start_number+1;
    END WHILE ;
    COMMIT;
END$$
DELIMITER ;
DELIMITER $$
USE `zhebase`$$
DROP PROCEDURE IF EXISTS `batch_insert_t2`$$
CREATE PROCEDURE `batch_insert_t2`(IN `start_number` BIGINT,IN `counts` BIGINT)
BEGIN
    DECLARE start_number BIGINT DEFAULT start_number;
    DECLARE stop_number BIGINT DEFAULT start_number;
    SET stop_number=start_number + counts;
    WHILE start_number < stop_number DO
        INSERT INTO t2(a,b) VALUES(start_number,start_number);
        SET start_number=start_number+1;
    END WHILE ;
    COMMIT;
END$$
DELIMITER ;
#执行存储过程往t1表插入10000条记录,t2表插入100条记录
CALL batch_insert_t1(1,10000);
CALL batch_insert_t2(1,100);
4.3.2.MySQL 表关联常见的两种算法
嵌套循环连接 Nested-Loop Join(NLJ) 算法
基于块的嵌套循环连接 Block Nested-Loop Join(BNL)算法
MySQL对于被驱动表的关联字段没索引的关联查询,一般都会使用 BNL 算法。如果有索引一般选择 NLJ 算法,有索引的情况下 NLJ 算法比 BNL算法性能更高
1.嵌套循环连接 Nested-Loop Join(NLJ) 算法 原理:一次一行循环地从第一张表(驱动表)中读取行,在这行数据中取到关联字段,根据关联字段在另一张表(被驱动表)里取出满足条件的行,然后取出两张表的结果合集。
explain select * from t1 inner join t2 on t1.a= t2.a;
从执行计划可以了解的信息:
a.驱动表是 t2,被驱动表是 t1( inner join 时 SQL优化器会小表驱动大表,外连接则根据连接类型区分)
b.使用了 NLJ 算法。如果执行计划 Extra 中未出现 Using join buffer 则表示使用的 join 算法是 NLJ
整个过程会读取 t2 表的所有数据(扫描100行),然后遍历这每行数据中字段 a 的值,根据 t2 表中 a 的值索引扫描 t1 表中的对应行(扫描100次 t1 表的索引,1次扫描可以认为最终只扫描 t1 表一行完整数据,也就是总共 t1 表也扫描了100行)。因此整个过程扫描了 200 行 。
2. 基于块的嵌套循环连接 Block Nested-Loop Join(BNL)算法 原理:把驱动表的数据读入到 join_buffer 中,然后扫描被驱动表,把被驱动表每一行取出来跟 join_buffer 中的数据做对比
explain select * from t1 inner join t2 on t1.b= t2.b;

整个过程对表 t1 和 t2 都做了一次全表扫描,因此扫描的总行数为10000(表 t1 的数据总量) + 100(表 t2 的数据总量) = 10100。并且 join_buffer 里的数据是无序的,因此对表 t1 中的每一行,都要做 100 次判断,所以内存中的判断次数是 100 * 10000= 100 万次(非扫描次数) 。 注意: join_buffer 的大小是由参数 join_buffer_size 控制,默认256k。如果 t2 放不下就会使用分段策略(先从 t2 表取出部分数据,比对完就清空 join_buffer,再重新拿出来余下的部分进行比对)。
被驱动表的关联字段无索引为什么要选择使用 BNL 算法而不使用 NLJ 算法? 如第二条 SQL,如果使用 NLJ 算法扫描行数为 100 * 10000 = 100万,这个是磁盘扫描。使用 BNL 算法仅需扫描 100100 行。
对于表关联 SQL 的优化
尽量少关联(在阿里规范中,关联表不能超过三种,可以后端代码单独查询,循环关联)
小表驱动大表,写多表连接 SQL 时如果明确知道哪张表是小表可以用straight_join写法固定连接驱动方式,节约 MySQL 优化器判断时间.
select * from t2 straight_join t1 on t2.a = t1.a; 代表指定mysql选着 t2 表作为驱动表关联字段加索引,大表关联字段一定要加索引,尽量使得 MySQL 在进行 join 操作时选择NLJ算法
多表连接是非常难以优化的,最好95%的场景都使用单表来完成,复杂场景交个JAVA代码,大规模计算交给大数据工具,无需效率才考虑连接
4.4.in和exsits优化
原则:小表驱动大表
# in 先执行括号里面的
select * from A where id in (select id from B)
#exists 先执行括号外面的
#select * 可以用 select 1 替换,没有区别
#exists 子查询内部会进行优化,并非逐条对比
#exists 子查询往往也可以用 jion 来代替,何种最优需要具体问题具体分析
select * from A where exists (select 1 from B where B.id = A.id)
4.5.count(*)查询优化
注意:根据某个字段 count 不会统计字段为 null 的行
#扫描二级索引,按行累加
explain select count(1) from employees;
#扫描辅助索引按行累加(辅助索引比聚簇索引小)
explain select count(id) from employees;
#把 name 拿到内存,不为 null 就累加
explain select count(name) from employees;
#不取值,按行累加
explain select count(*) from employees;
四条语句的效率几乎可以忽略,效率对比如下: 字段有索引: count(* )≈count(1)>count(字段)>count(主键 id) 段)>count(主键 id) 字段无索引: count(*)≈count(1)>count(主键 id)>count(字段)
常见优化方法:
1.对于 MyISAM 存储引擎的表做不带 where 条件的 count 查询性能是很高的,数据总行数直接写在磁盘上,查询不需要计算。innodb 存储引擎的表则不会记录(因为有MVCC机制)
2.对与不用知道确切行的可以直接使用
show table status,它是一个估值,使用该查询效率很高3.将总数维护到 Redis 里面,插入或删除表数据行的时候同时维护 Redis 里的表总行数 key 的计数值(用 incr 或 decr 命令),但是这种方式可能不准,很难保证表操作和Redis 操作的事务一致性。
4.增加数据库计数表,插入或删除表数据行的时候同时维护计数表,且它们在同一个事务里操作
5.索引设计原则
1、代码先行,索引后上,先开发完主体业务代码,再把涉及到该表相关sql都要拿出来分析之后再建立索引。
2、联合索引尽量覆盖条件,可以设计一个或者两三个联合索引(单值索引要少建),让每一个联合索引都尽量去包含SQL语句里的 where、order by、group by 的字段,且这些联合索引字段顺序尽量满足 SQL查询的最左前缀原则。
3、不要在小基数字段上建立索引,无法进行快速的二分查找,不能能发挥出B+树快速二分查找的优势来,没有意义
4、尽量对字段类型较小的列设计索引,尽量对字段类型较小的列设计索引,比如 Tinyint 之类,字段类型较小的话,占用磁盘空间小,搜索的时性能更好。
5、长字符串可以采用前缀索引,比如针对某个字段的前20个字符建立索引,即:每个值的前20个字符放入索引树中,搜索时会先匹配前而是个字符,再回表到聚簇索引取出来完整的 name 字段值进行比较。但排序(order by 和 group by)时无法使用该索引。
6、where 与 order by 冲突时优先 where,大多数情况下根据索引进行 where 筛选一般筛选出来的数据比较少,然后做排序成本会更低。
7、基于慢SQL查询做优化,可以根据监控后台的一些慢SQL,针对这些慢 SQL 查询做特定的索引优化(MySQL有提供,只需设置具体参数)。








Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Xcode 是苹果面向 Mac 提供的官方集成开发环境,将代码编辑、项目构建、SwiftUI 实时预览、设备模拟、自动化测试、断点调试、性能分析和应用分发整合在同一套工作流中,适合开发与维护 iPhone、iPad、Mac、Apple Wa

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

PhpStorm 是 JetBrains 推出的专业 PHP 集成开发环境,可在 Mac 上完成代码编写、智能检查、重构、调试、测试和数据库管理。它支持主流 PHP 框架、Composer、Git、Docker 与远程解释器。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

Visual Studio Code 是微软提供的免费代码编辑器,支持 macOS,并为 Intel 与 Apple 芯片 Mac 提供适配版本。软件集代码编辑、调试、Git 源代码管理、集成终端和扩展市场于一体。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

Adobe Audition 是面向播客、影视后期、音乐制作及内容创作者的专业音频工作站,提供波形精修、多轨录制与混音、频谱编辑、降噪修复、响度匹配和效果处理工具,并可与 Adobe Premiere 协同完成视频声音制作。

Pro Tools 是 Avid 推出的专业数字音频工作站,覆盖多轨录音、无损剪辑、MIDI 编曲、插件处理、自动化混音及声音与画面同步等工作。它拥有 Intro、Artist、Studio 和 Ultimate 等方案。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,

WebStorm 是 JetBrains 面向 JavaScript、TypeScript 和现代 Web 技术打造的集成开发环境。它提供项目级代码分析、智能补全、安全重构、导航搜索,并集成调试、测试、终端、Git 与常用前端工具,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

Visual Studio Code 是微软推出的免费代码编辑器,Windows 版集成智能补全、代码导航、调试、终端和版本控制,并可通过扩展添加语言、格式化及远程开发能力。它启动较快、配置灵活,

REAPER 是 Cockos 推出的数字音频工作站,适用于录音、MIDI 编曲、音频编辑、混音、母带制作及声音设计。软件安装包小巧,支持多轨录制、灵活路由、自动化、第三方插件和脚本扩展,并提供完整功能的 60 天免费评估期。

Adobe Audition 是面向播客、影视后期、广播与音乐制作的专业音频工作站,提供波形编辑、多轨混音、频谱分析、录音、降噪修复和效果处理等功能。Windows 版通过 Adobe Creative Cloud 安装和管理,

Pro Tools 是 Avid 推出的专业数字音频工作站,提供多轨录音、音频剪辑、MIDI编曲、插件处理、自动化混音及影视声音制作能力。它适合音乐人、录音师、制作人和音频后期团队使用,并提供免费入门版、订阅方案及永久授权选择。