


一文带您了解SHAP:机器学习的模型解释
在机器学习和数据科学领域,模型的可解释性一直是研究者和实践者关注的焦点。随着深度学习和集成方法等复杂模型的广泛应用,理解模型的决策过程变得尤为重要。可解释人工智能(ExplainableAI|XAI)通过提高模型的透明度,帮助建立对机器学习模型的信任和信心。提高模型的透明度可以通过多种复杂模型的广泛应用等方法来实现,以及用于解释模型的决策过程。这些方法包括特征重要性分析、模型预测区间估计、局部可解释性算法等。特征重要性分析可以通过评估模型对输入特征的影响程度来解释模型的决策过程。模型预测区间估计可以提供模
在机器学习和数据科学领域,模型的可解释性一直是研究者和实践者关注的焦点。随着深度学习和集成方法等复杂模型的广泛应用,理解模型的决策过程变得尤为重要。可解释人工智能(Explainable AI | XAI)通过提高模型的透明度,帮助建立对机器学习模型的信任和信心。 提高模型的透明度可以通过多种复杂模型的广泛应用等方法来实现,以及用于解释模型的决策过程。这些方法包括特征重要性分析、模型预测区间估计、局部可解释性算法等。特征重要性分析可以通过评估模型对输入特征的影响程度来解释模型的决策过程。模型预测区间估计可以提供模型预测的确定性信息。局部可解释性算法可以帮
XAI是一套工具和框架,用于理解和解释机器学习模型如何做出决策。其中,Python中的SHAP(SHapley Additive explanations)库是一个非常有用的工具。SHAP库能够量化特征对单个预测及整体预测的贡献,并提供美观且易于使用的可视化功能。
接下来,我们将概括介绍下SHAP库的基础知识,以理解在Scikit-learn中构建的回归和分类模型的预测。
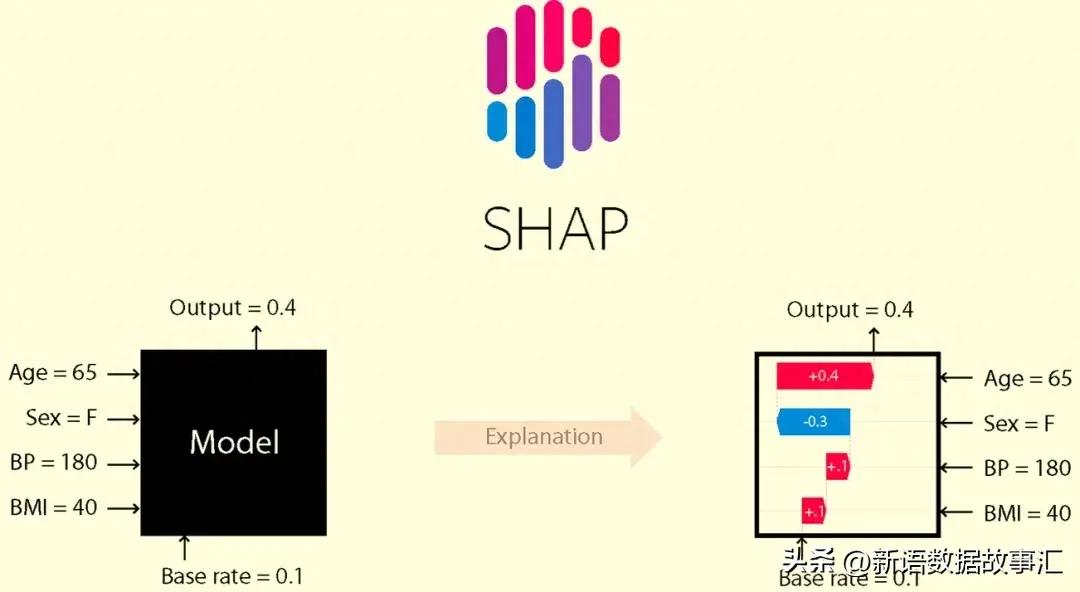
SHAP 和SHAP values
SHAP(Shapley Additive Explanations)是一种解释任何机器学习模型输出的博弈论方法。它利用经典的博弈论博弈值及其相关扩展,将最优的信用分配与局部解释相结合(详细信息和引用请参阅相关论文:https://github.com/shap/shap#citations)。SHAP通过计算每个特征对模型输出的贡献,从而提供最优的信用分配和局部解释。这种方法可以应用于各种模型类型,包括线性模型、树模型、深度学习模型等。SHAP的目标是提供一种直观且可解释的方式,帮助人们理解机器学习模型的决策过程,以及各个特征对于预测结果的影响程度。通过使用SHAP值和相关扩展,我们可以获得更准确、全面的特征重要性解释,并对模型的预
SHAP+ values可以帮助我们量化特征对预测的贡献。SHAP值越接近于零,表示该特征对预测的贡献越小;而SHAP值越远离零,表示该特征对预测的贡献越大。此外,SHAP值还可以告诉我们特征对预测的贡献大小。当SHAP值接近于零时,表示该特征对预测的贡献很小;而当SHAP值远离零时,
安装shap 包:
pip install shap-i https://pypi.tuna.tsinghua.edu.cn/simple
我们看下面的示例:如何在回归问题中获取特征的SHAP值。我们将从加载库和示例数据开始,然后快速构建一个模型来预测糖尿病的进展情况:
import numpy as npnp.set_printoptions(formatter={'float':lambda x:"{:.4f}".format(x)})import pandas as pdpd.options.display.float_format = "{:.3f}".formatimport seaborn as snsimport matplotlib.pyplot as pltsns.set(style='darkgrid', context='talk', palette='rainbow')from sklearn.datasets import load_diabetesfrom sklearn.model_selection import train_test_splitfrom sklearn.ensemble import (RandomForestRegressor, RandomForestClassifier)import shapshap.initjs()# Import sample datadiabetes = load_diabetes(as_frame=True)X = diabetes['data'].iloc[:, :4] # Select first 4 columnsy = diabetes['target']# Partition dataX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=1)print(f"Training features shape: {X_train.shape}")print(f"Training target shape: {y_train.shape}\n")print(f"Test features shape: {X_test.shape}")print(f"Test target shape: {y_test.shape}")display(X_train.head())# Train a simple modelmodel = RandomForestRegressor(random_state=42)model.fit(X_train, y_train)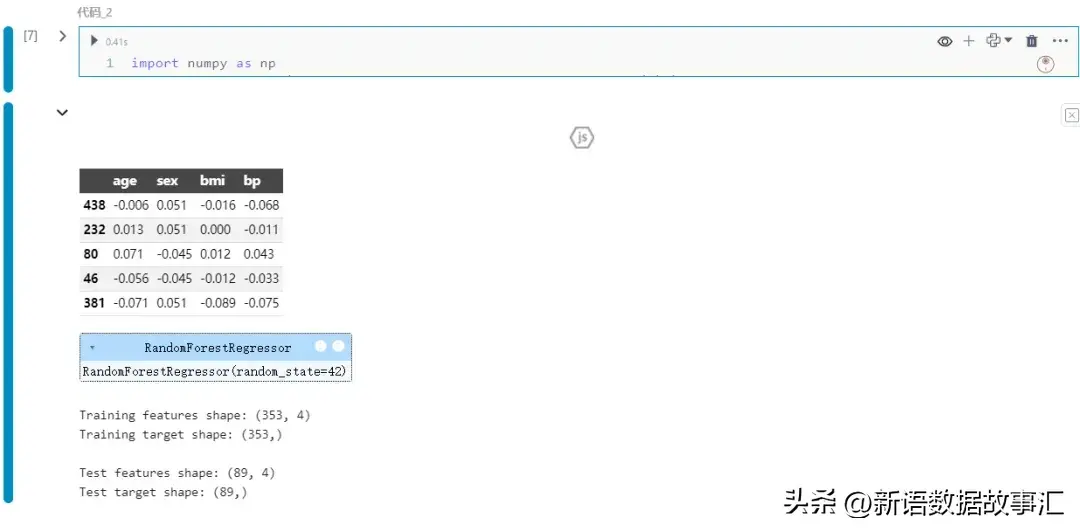
一种常见的获取SHAP值的方法是使用Explainer对象。接下来创建一个Explainer对象,并为测试数据提取shap_test值:
explainer = shap.Explainer(model)shap_test = explainer(X_test)print(f"Shap values length: {len(shap_test)}\n")print(f"Sample shap value:\n{shap_test[0]}")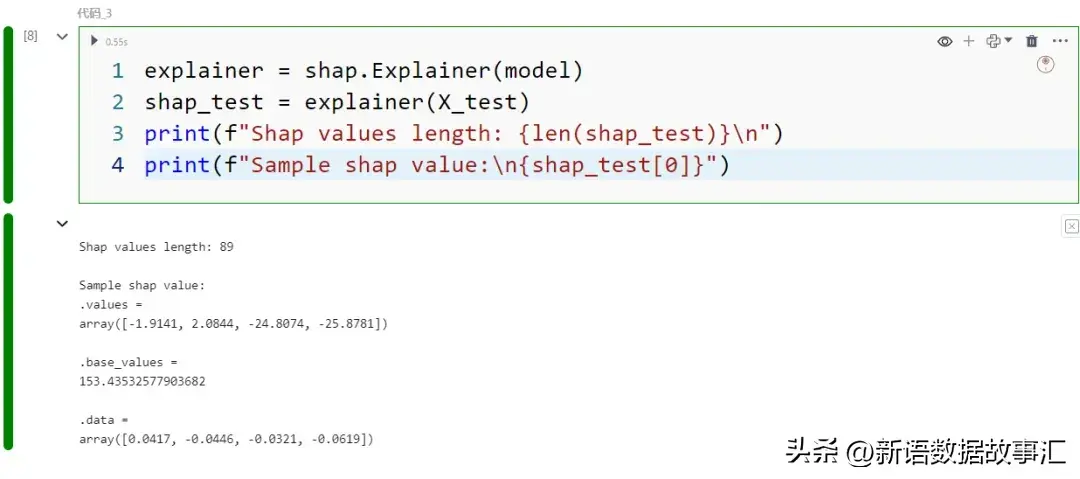
shap_test的长度为89,因为它包含了每个测试实例的记录。从查看第一个测试记录中,我们可以看到它包含三个属性:
shap_test[0].base_values:目标的基准值
shap_test[0].data:每个特征的值
shap_test[0].values:每个对象的SHAP值
- 基准值:基准值(shap_test.base_values),也称为期望值(explainer.expected_value),是训练数据中目标值的平均值。
print(f"Expected value: {explainer.expected_value[0]:.1f}")print(f"Average target value (training data): {y_train.mean():.1f}")print(f"Base value: {np.unique(shap_test.base_values)[0]:.1f}")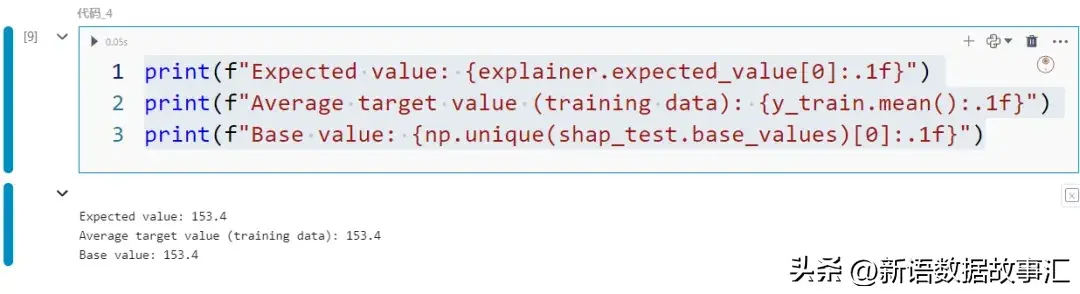
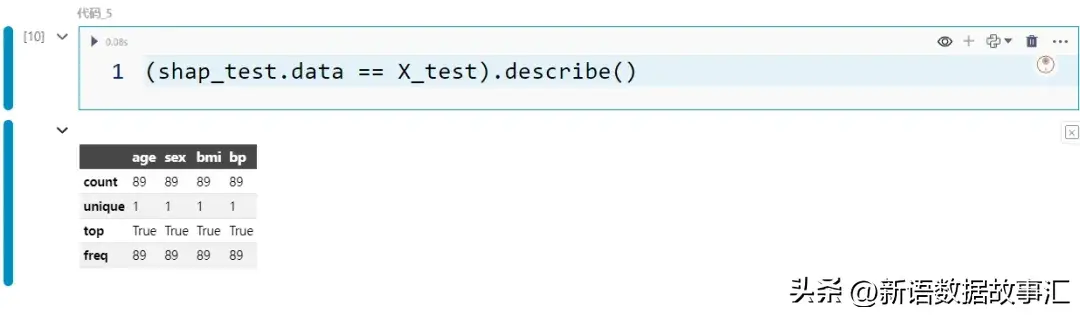
- shap_test.data 包含与 X_test 相同的值
(shap_test.data == X_test).describe()
- values:shap_test 最重要的属性是 values 属性,因为我们可以通过它访问 SHAP 值。让我们将 SHAP 值转换为 DataFrame,以便于操作:
shap_df = pd.DataFrame(shap_test.values, columns=shap_test.feature_names, index=X_test.index)shap_df
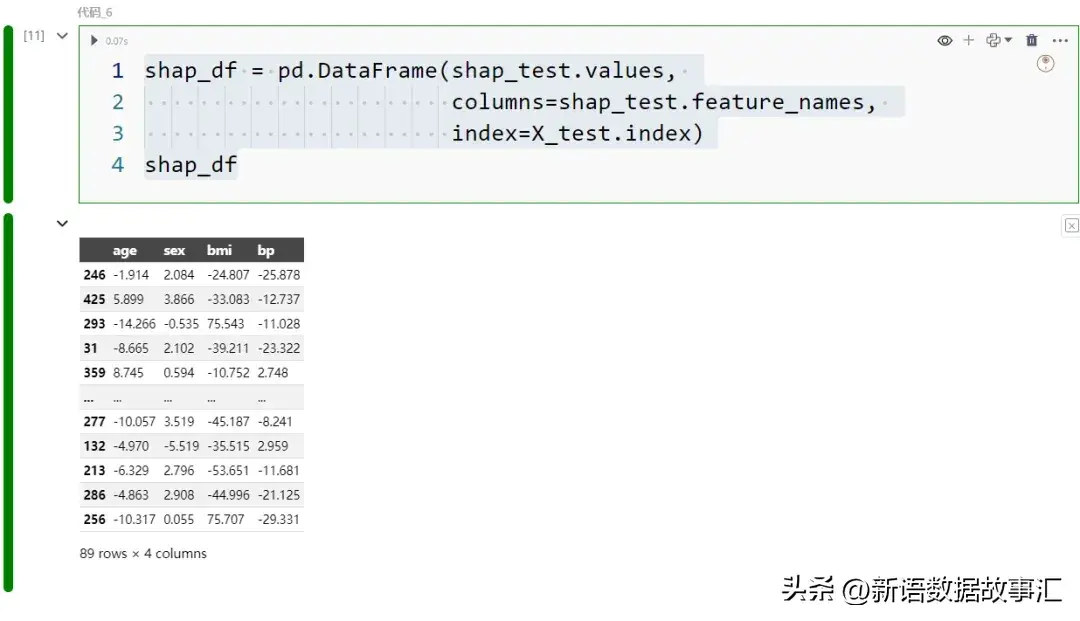
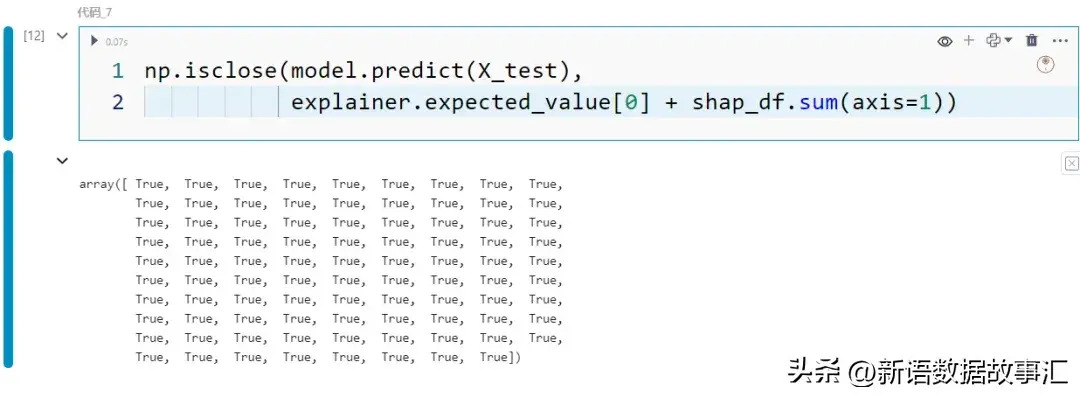
可以看到每条记录中每个特征的 SHAP 值。如果将这些 SHAP 值加到期望值上,就会得到预测值:
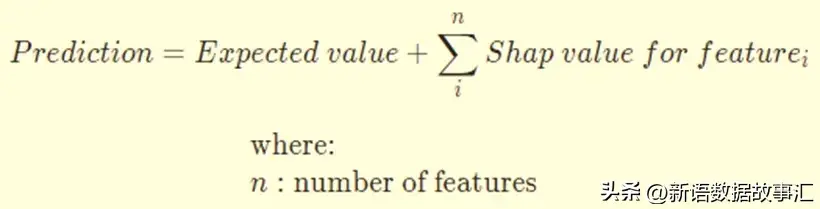
np.isclose(model.predict(X_test), explainer.expected_value[0] + shap_df.sum(axis=1))
现在我们已经有了 SHAP 值,可以进行自定义可视化,如下图所示,以理解特征的贡献:
columns = shap_df.apply(np.abs).mean()\ .sort_values(ascending=False).indexfig, ax = plt.subplots(1, 2, figsize=(11,4))sns.barplot(data=shap_df[columns].apply(np.abs), orient='h', ax=ax[0])ax[0].set_title("Mean absolute shap value")sns.boxplot(data=shap_df[columns], orient='h', ax=ax[1])ax[1].set_title("Distribution of shap values");plt.show()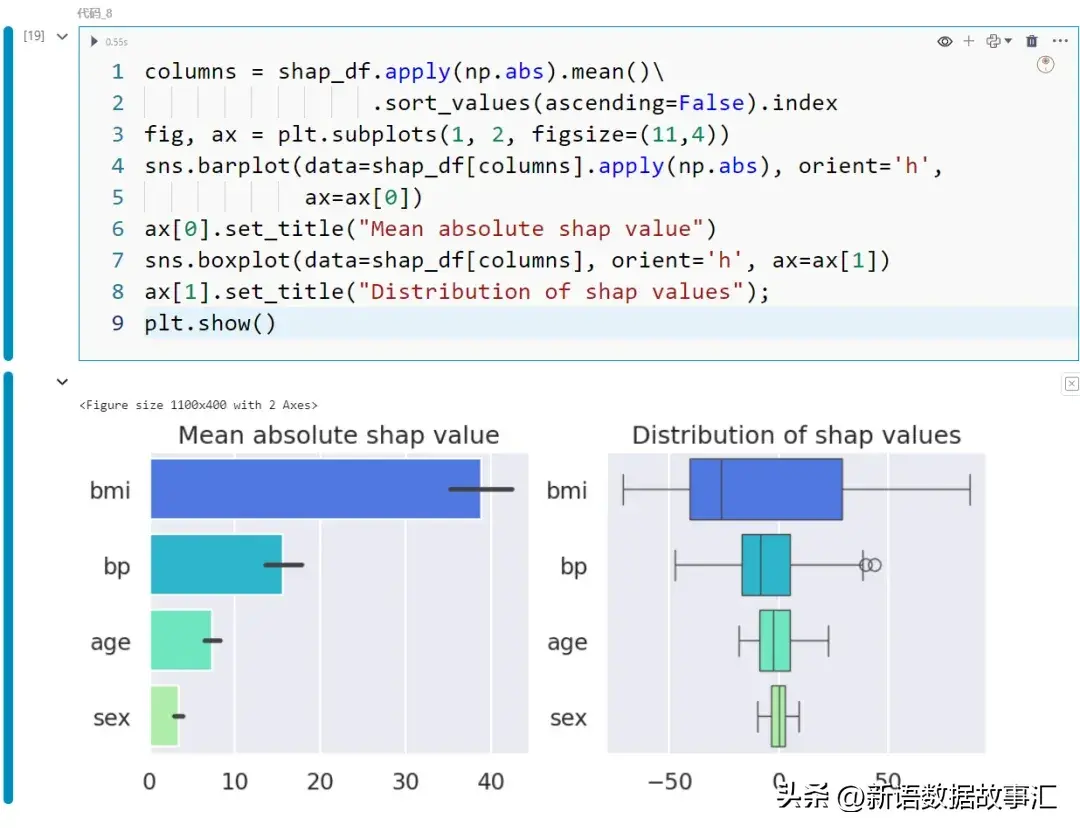
左侧子图显示了每个特征的平均绝对 SHAP 值,而右侧子图显示了各特征的 SHAP 值分布。从这些图中可以看出,bmi 在所使用的4个特征中贡献最大。
Shap 内置图表
虽然我们可以使用 SHAP 值构建自己的可视化图表,但 shap 包提供了内置的华丽可视化图表。在本节中,我们将熟悉其中几种选择的可视化图表。我们将查看两种主要类型的图表:
- 全局:可视化特征的整体贡献。这种类型的图表显示了特征在整个数据集上的汇总贡献。
- 局部:显示特定实例中特征贡献的图表。这有助于我们深入了解单个预测。
- 条形图/全局:对于之前显示的左侧子图,有一个等效的内置函数,只需几个按键即可调用:
shap.plots.bar(shap_test)
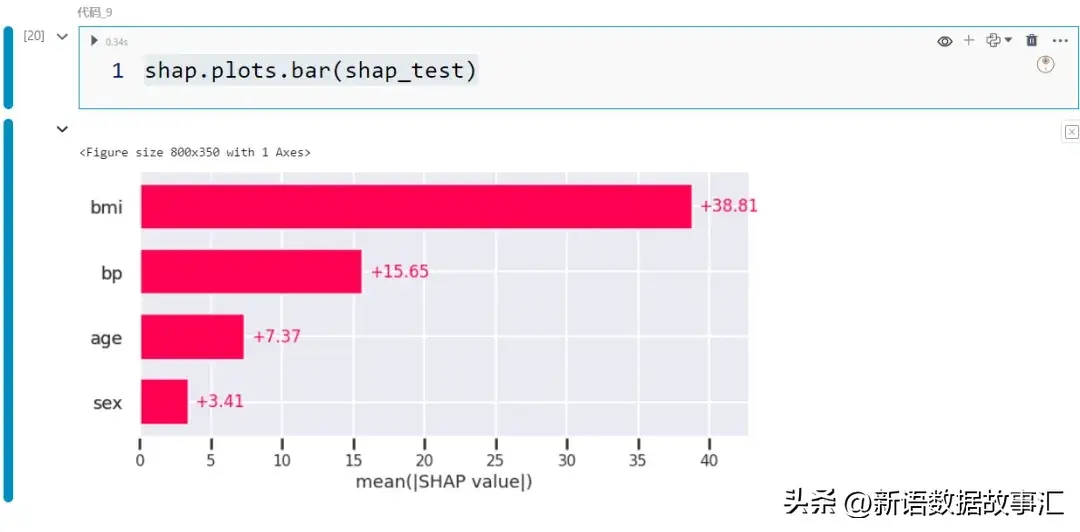
这个简单但有用的图表显示了特征贡献的强度。该图基于特征的平均绝对 SHAP 值而生成:shap_df.apply(np.abs).mean()。特征按照从上到下的顺序排列,具有最高平均绝对 SHAP 值的特征显示在顶部。
- 总结图/全局:另一个有用的图是总结图:
shap.summary_plot(shap_test)
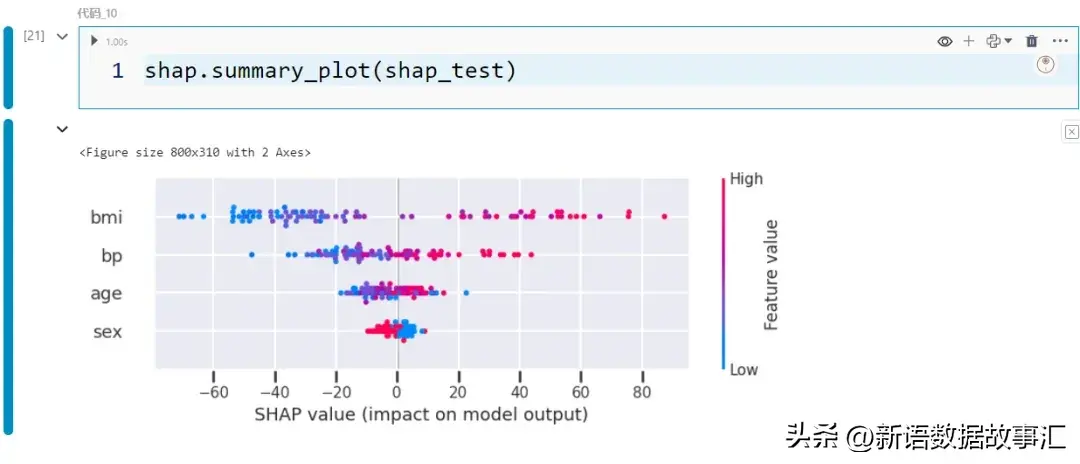
以下是解释这张图的指南:
- 图的横轴显示了特征的 SHAP 值分布。每个点代表数据集中的一个记录。例如,我们可以看到对于 BMI 特征,点的分布相当散乱,几乎没有点位于 0 附近,而对于年龄特征,点更加集中地分布在 0 附近。
- 点的颜色显示了特征值。这个额外的维度允许我们看到随着特征值的变化,SHAP 值如何变化。换句话说,我们可以看到关系的方向。例如,我们可以看到当 BMI 较高时(由热粉色点表示)SHAP 值倾向于较高,并且当 BMI 较低时(由蓝色点表示)SHAP 值倾向于较低。还有一些紫色点散布在整个光谱中。
- 热力图/全局:热力图是另一种可视化 SHAP 值的方式。与将 SHAP 值聚合到平均值不同,我们看到以颜色编码的个体值。特征绘制在 y 轴上,记录绘制在 x 轴上:
shap.plots.heatmap(shap_test)
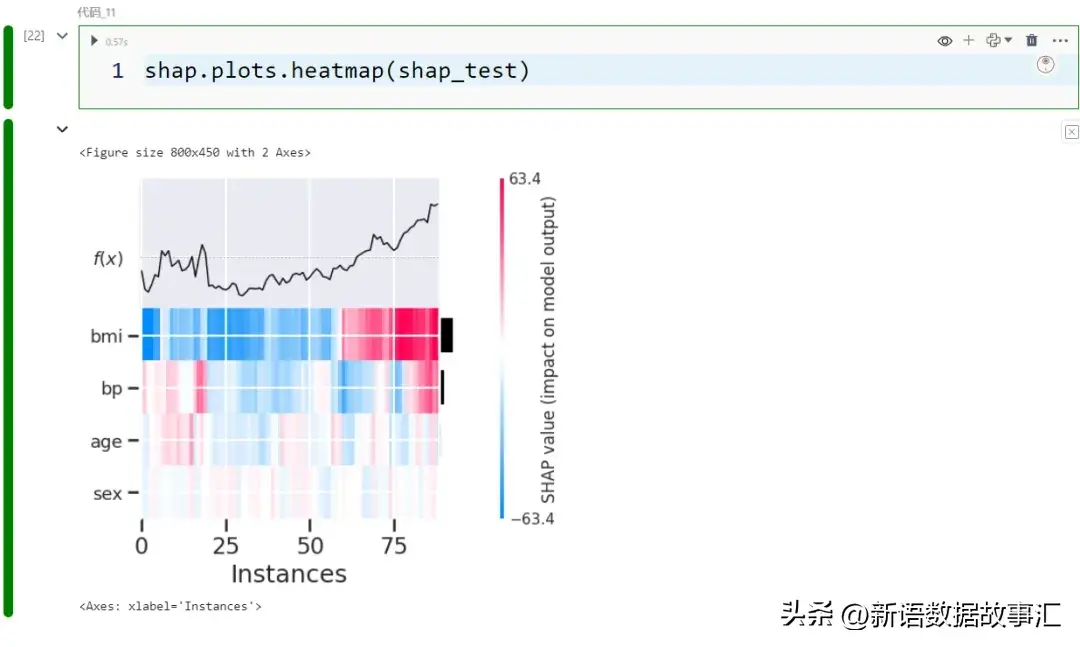
这个热力图的顶部还补充了每个记录的预测值(即 f(x))的线图。
- Force plot/全局:这个交互式图表允许我们通过记录查看 SHAP 值的构成。
shap.initjs()shap.force_plot(explainer.expected_value, shap_test.values, X_test)
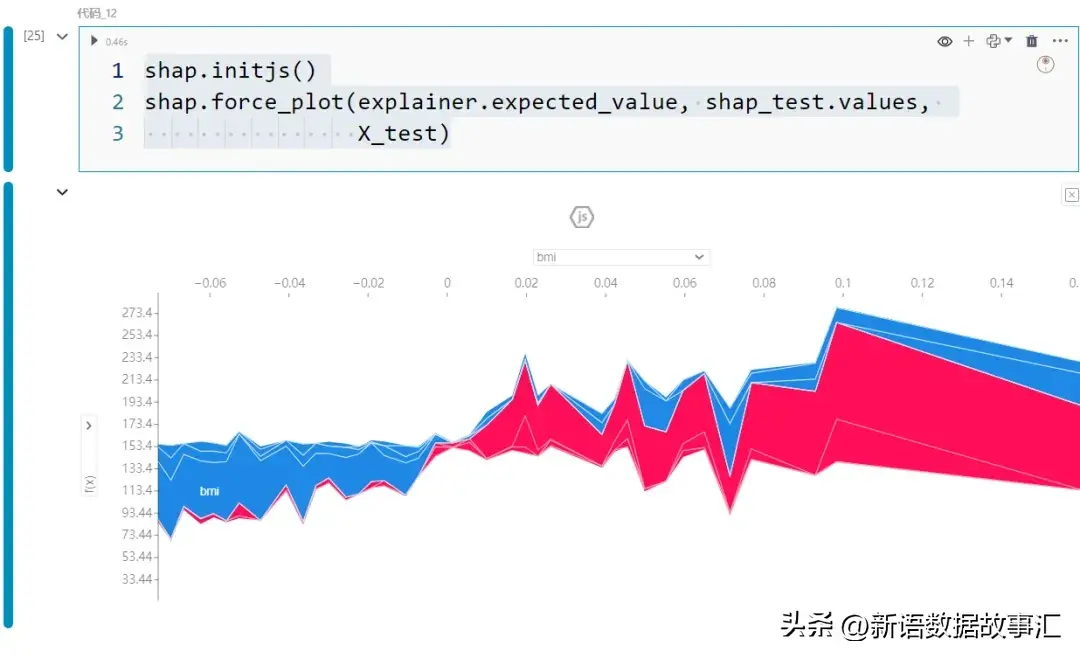
就像热力图一样,x 轴显示每个记录。正的 SHAP 值显示为红色,负的 SHAP 值显示为蓝色。例如,由于第一个记录的红色贡献比蓝色贡献多,因此该记录的预测值将高于期望值。
交互性允许我们改变两个轴。例如,y 轴显示预测值 f(x),x 轴根据输出(预测)值排序,如上面的快照所示。
- 条形图/局部:现在我们将看一下用于理解个别案例预测的图表。让我们从一个条形图开始:
shap.plots.bar(shap_test[0])
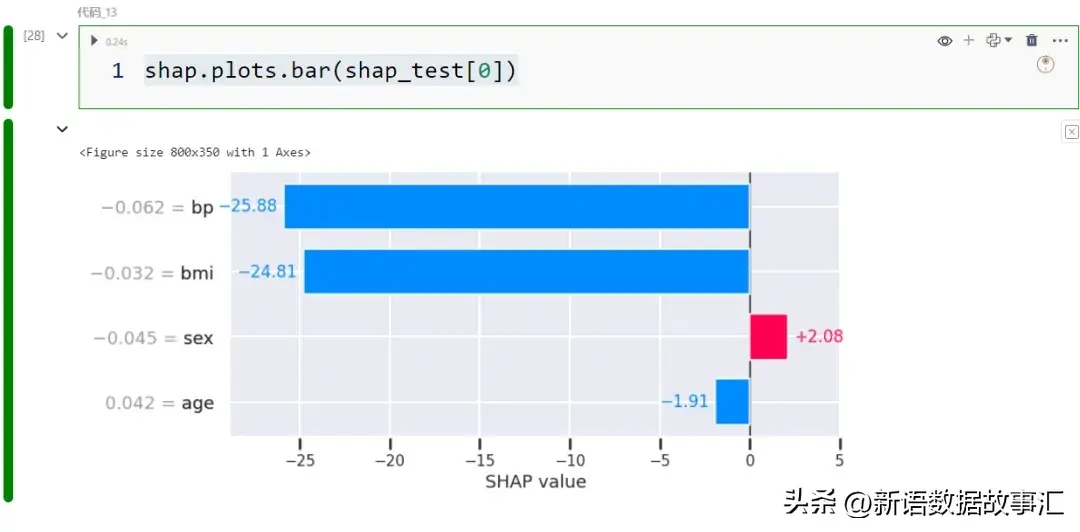
与“ 条形图/全局 ”中完全相同,只是这次我们将数据切片为单个记录。
- Force plot/局部:Force plot是单个记录的强制图。
shap.initjs()shap.plots.force(shap_test[0])
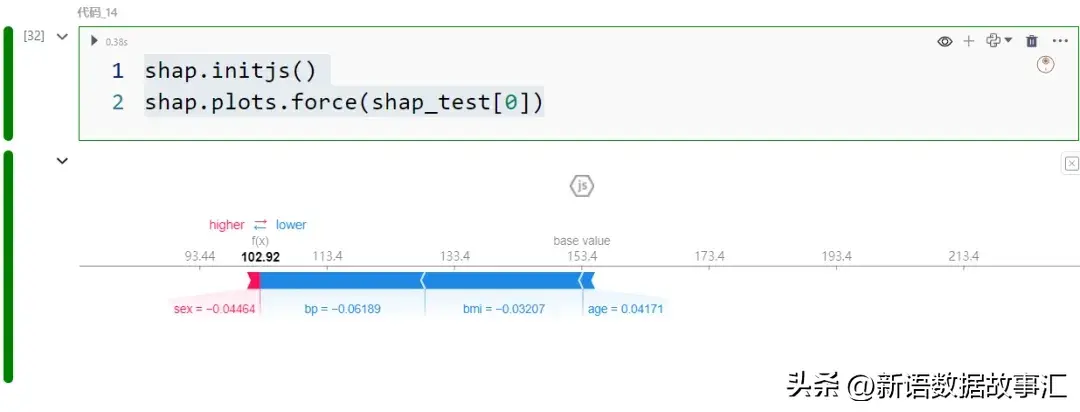
分类模型的SHAP values/图表
上面示例是回归模型,下面我们以分类模型展示SHAP values及可视化:
import numpy as npnp.set_printoptions(formatter={'float':lambda x:"{:.4f}".format(x)})import pandas as pdpd.options.display.float_format = "{:.3f}".formatimport seaborn as snsimport matplotlib.pyplot as pltsns.set(style='darkgrid', context='talk', palette='rainbow')from sklearn.datasets import load_diabetesfrom sklearn.model_selection import train_test_splitfrom sklearn.ensemble import RandomForestClassifierimport shapfrom sklearn.datasets import fetch_openml# 加载 Titanic 数据集titanic = fetch_openml('titanic', version=1, as_frame=True)df = titanic.frame# 选择特征和目标变量features = ['pclass', 'age', 'sibsp', 'parch', 'fare']df = df.dropna(subset=features + ['survived'])# 删除包含缺失值的行X = df[features]y = df['survived']# 分割数据集X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)# 训练随机森林分类器model = RandomForestClassifier(n_estimators=100, random_state=42)model.fit(X_train, y_train)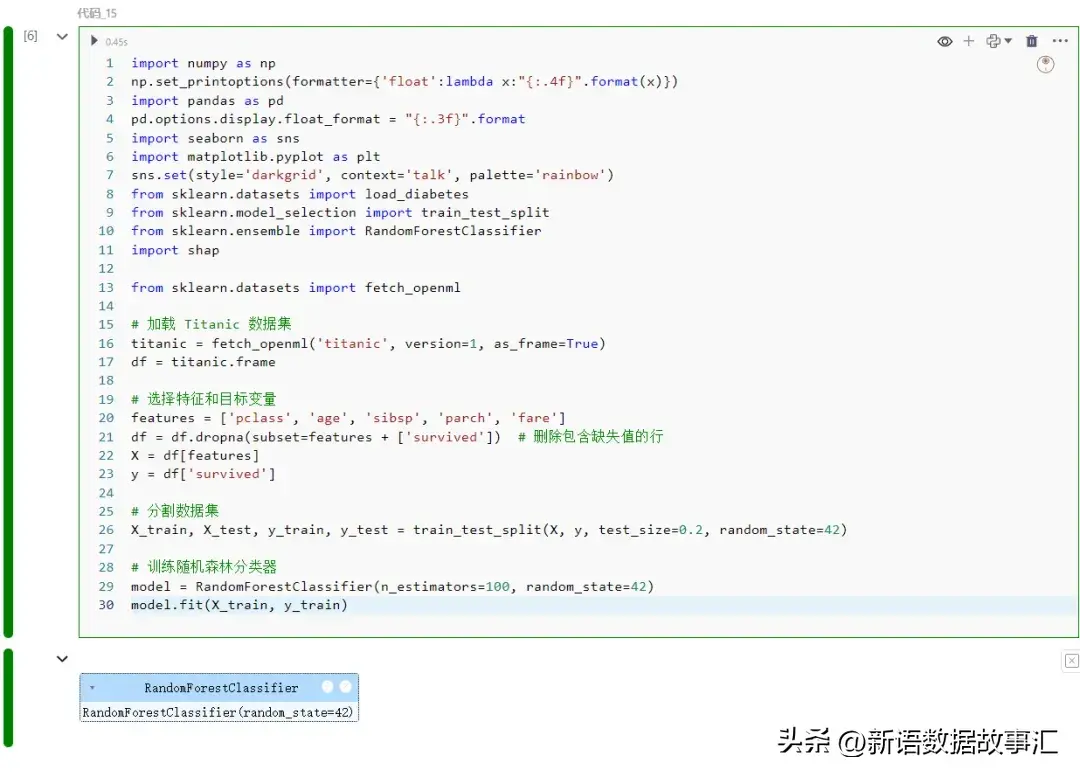
和回归模型一样的,shap values 值也是包括base_values 和values 值:
explainer = shap.Explainer(model)shap_test = explainer(X_test)print(f"Length of shap_test: {len(shap_test)}\n")print(f"Sample shap_test:\n{shap_test[0]}")print(f"Expected value: {explainer.expected_value[1]:.2f}")print(f"Average target value (training data): {y_train}")print(f"Base value: {np.unique(shap_test.base_values)[0]:.2f}")shap_df = pd.DataFrame(shap_test.values[:,:,1], columns=shap_test.feature_names, index=X_test.index)shap_df我们仔细检查一下将 shap 值之和添加到预期概率是否会给出预测概率:
np.isclose(model.predict_proba(X_test)[:,1], explainer.expected_value[1] + shap_df.sum(axis=1))
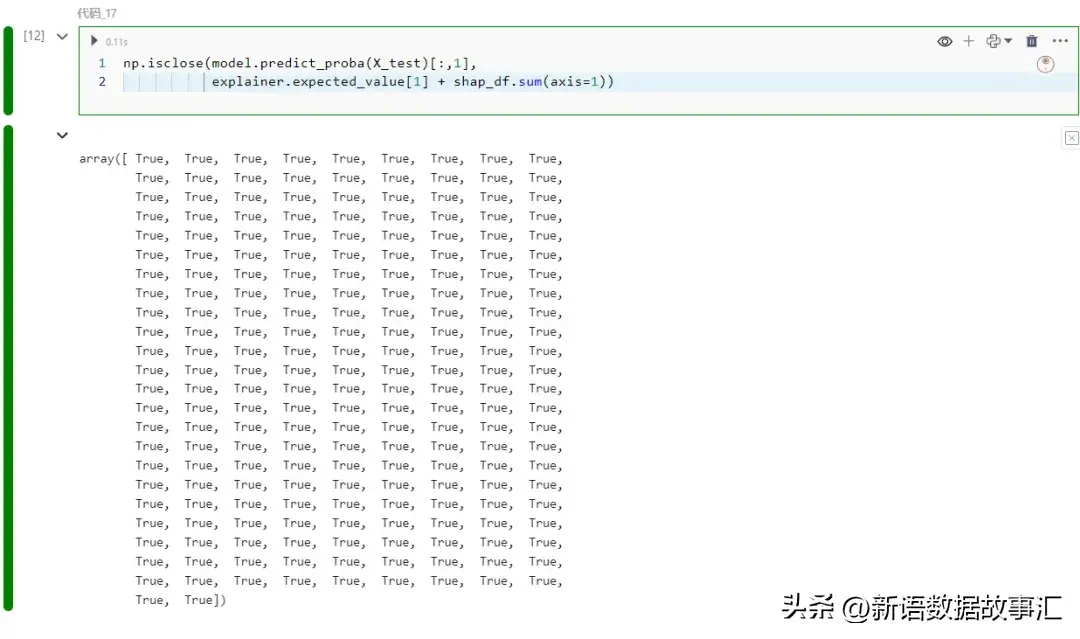
内置图与回归模型是一致的,比如:
shap.plots.bar(shap_test[:,:,1])
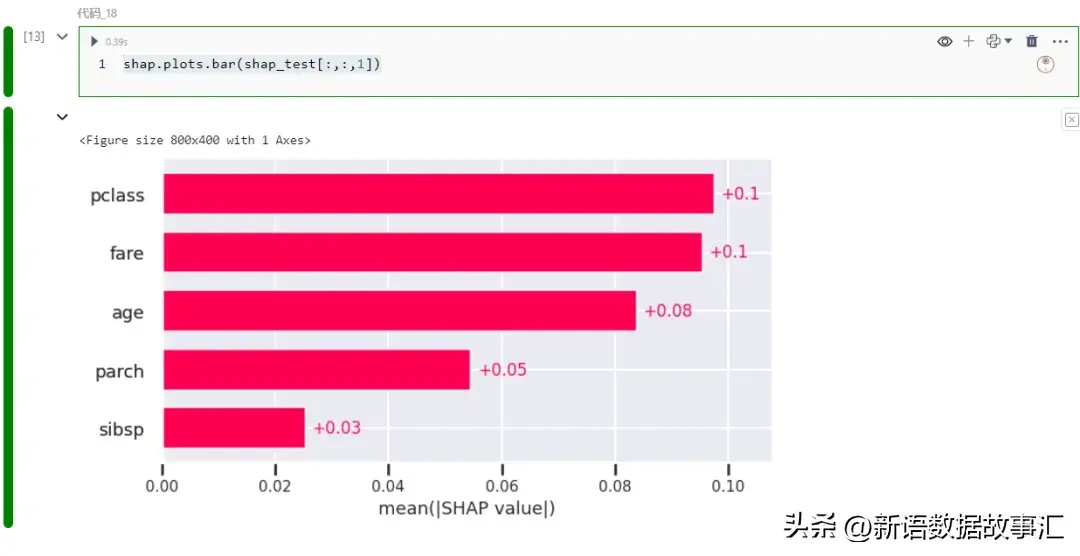
或者瀑布图如下:
shap.plots.waterfall(shap_test[:,:,1][0])
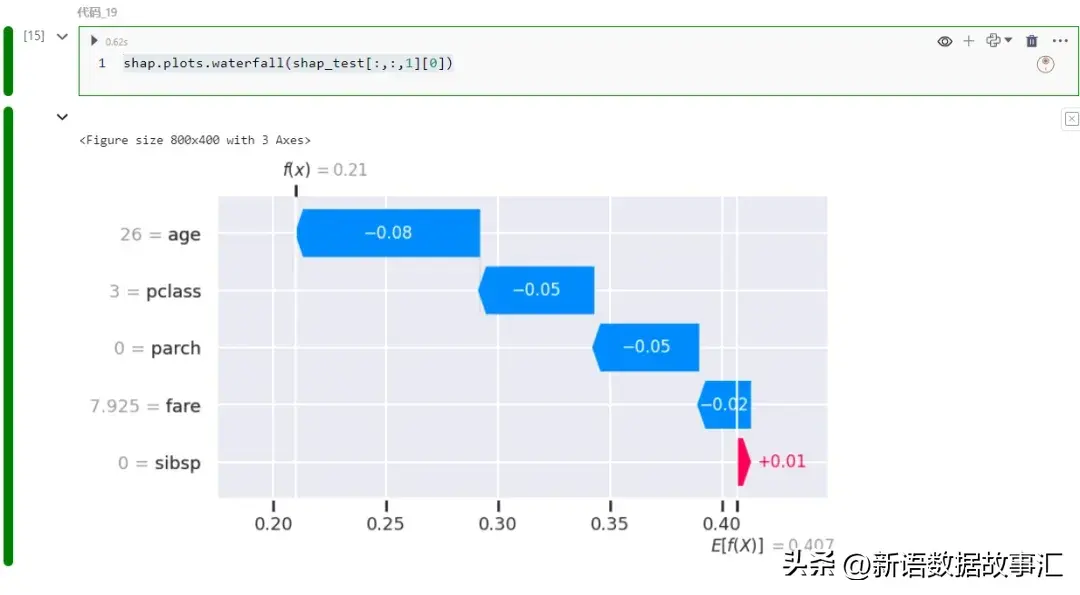
示例
看一个具体的用例。我们将找出模型对幸存者预测最不准确的例子,并尝试理解模型为什么会做出错误的预测:
test = pd.concat([X_test, y_test], axis=1)test['probability'] = model.predict_proba(X_test)[:,1]test['order'] = np.arange(len(test))test.query("survived=='1'").nsmallest(5, 'probability')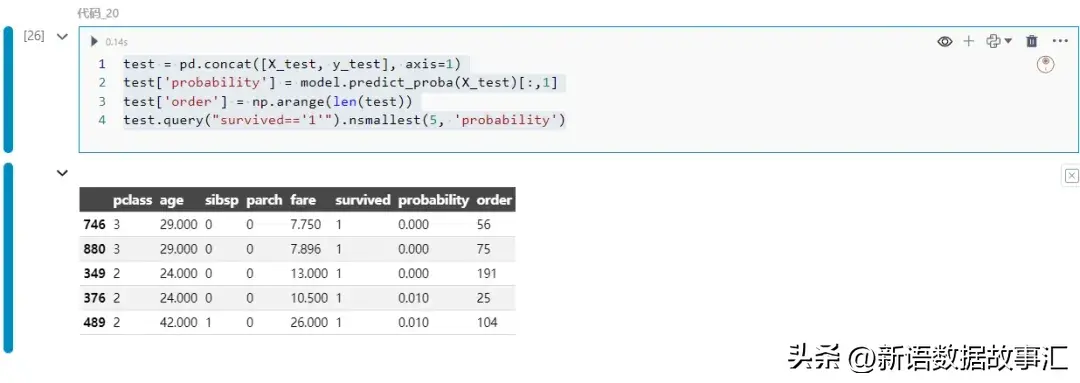
生存概率为第一个记录的746。让我们看看各个特征是如何对这一预测结果产生贡献的:
ind1 = test.query("survived=='1'")\ .nsmallest(1, 'probability')['order'].values[0]shap.plots.waterfall(shap_test[:,:,1][ind1])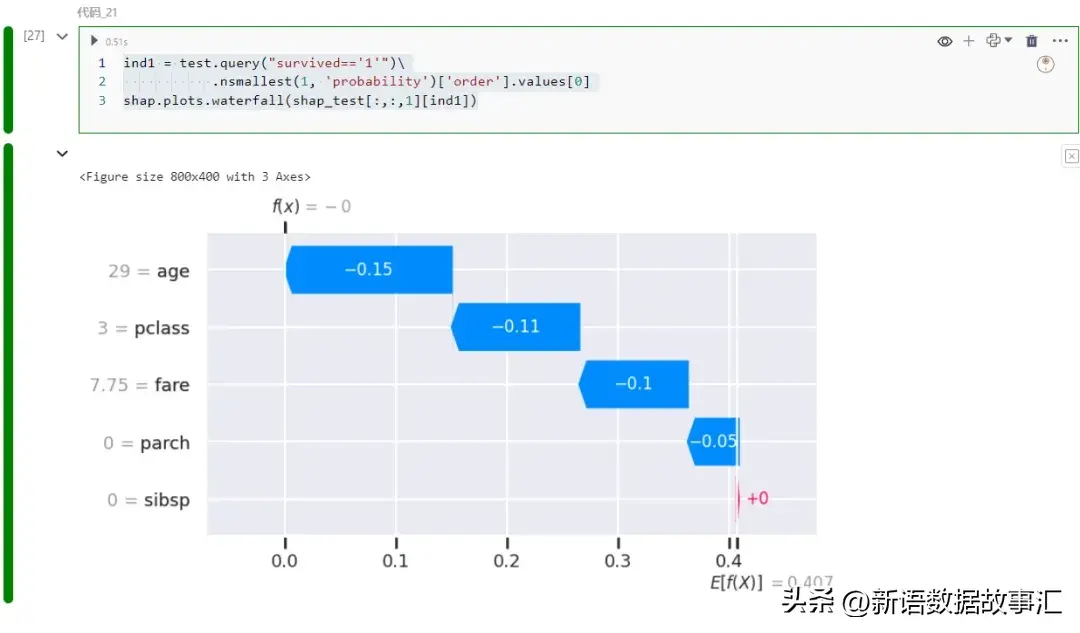
主要是客舱等级和年龄拉低了预测值。让我们在训练数据中找到类似的例子:
pd.concat([X_train, y_train], axis=1)[(X_train['pclass']==3) & (X_train['age']==29) & (X_train['fare'].between(7,8))]
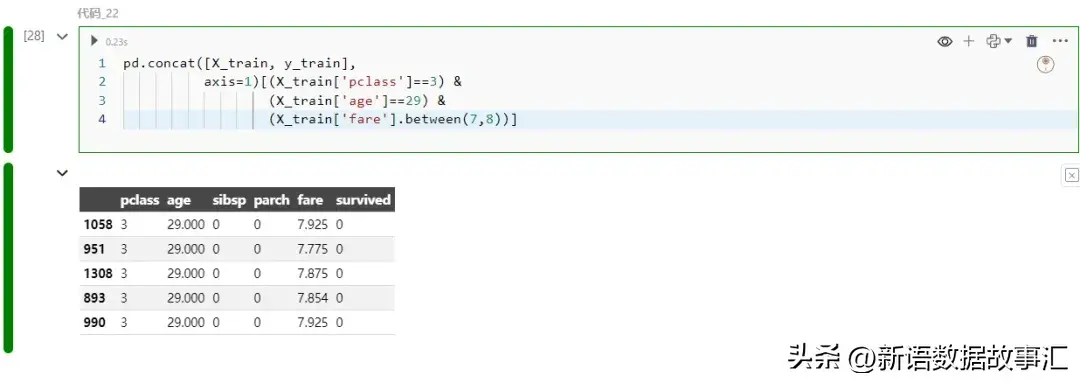
所有类似的训练实例实际上都没有幸存。现在,这就说得通了!这是一个小的分析示例,展示了 SHAP 如何有助于揭示模型为何会做出错误预测。
在机器学习和数据科学中,模型的可解释性一直备受关注。可解释人工智能(XAI)通过提高模型透明度,增强对模型的信任。SHAP库是一个重要工具,通过量化特征对预测的贡献,提供可视化功能。本文介绍了SHAP库的基础知识,以及如何使用它来理解回归和分类模型的预测。通过具体用例,展示了SHAP如何帮助解释模型错误预测。











火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,