


小红书从记忆机制解读信息检索,提出新范式获得 EACL Oral
近日,来自小红书搜索算法团队的论文《GenerativeDenseRetrieval:MemoryCanBeaBurden》被自然语言处理领域国际会议EACL2024接收为Oral,接受率为11.32%(144/1271)。他们在论文中提出了一种新颖的信息检索范式——生成式密集检索(GenerativeDenseRetrieval,GDR)。该范式能够很好地解决传统生成式检索(GenerativeRetrieval,GR)在处理大规模数据集时所面临的挑战。它是从记忆机制得到的灵感。在过往的实践中,GR凭借
近日,来自小红书搜索算法团队的论文《Generative Dense Retrieval: Memory Can Be a Burden》被自然语言处理领域国际会议 EACL 2024 接收为 Oral,接受率为 11.32%(144/1271)。
他们在论文中提出了一种新颖的信息检索范式——生成式密集检索(Generative Dense Retrieval,GDR)。该范式能够很好地解决传统生成式检索(Generative Retrieval,GR)在处理大规模数据集时所面临的挑战。它是从记忆机制得到的灵感。
在过往的实践中,GR凭借其独特的记忆机制,实现了查询与文档库间的深度交互。然而,这种依赖于语言模型自回归编码的方法,在处理大规模数据时存在着明显的局限性,包括细粒度文档特征模糊、文档库规模受限、索引更新困难等。
小红书提出的 GDR 采用由粗到细的两阶段检索思想,首先利用语言模型有限的记忆容量,实现查询到文档将的映射,然后通过向量匹配机制完成文档将到文档的精细映射。GDR 通过引入密集集检索的向量匹配机制,有效缓解了 GR 的固有弊端。
此外,团队还设计了「记忆友好的文档簇标识符构建策略」与「文档簇自适应的负采样策略」,分别提升了两阶段的检索性能。在 Natural Questions 数据集的多个设定下,GDR 不仅展现了 SOTA 的 Recall@k 表现,更在保留深度交互优势的同时实现了良好的可扩展性,为信息检索的未来研究开辟了新的可能性。
1.背景
文本搜索工具具有重要的研究与应用价值。传统搜索范式,如基于字词匹配度的稀疏检索(sparse retrieval, SR)和基于语义向量匹配度的密集检索(dense retrieval, DR),虽然各有千秋,但随着预训练语言模型的兴起,基于此的生成式检索范式开始崭露头角。 生成式检索范式的开端主要基于查询和候选文档之间的语义匹配度。通过将查询和文档映射到同一语义空间,将候选文档的检索问题转化为向量匹配度的密集检索。这种开创式的检索范式利用了预训练语言模型的优势,为文本搜索领域带来了新的机遇。 然而,生成式检索范式仍面临挑战。一方面,现有的预训
在训练过程中,模型以给定查询作为上下文,自回归地生成相关文档的标识符。这一过程实现了模型对于候选语料库的记忆。查询进入模型后与模型参数交互并自回归解码,隐式地产生了查询与候选语料库的深度交互,而这种深度交互正是 SR 和 DR 所缺少的。因此,当模型能够准确记忆候选文档时,GR 能够表现出优异的检索性能。
尽管GR的记忆机制并非无懈可击。我们通过经典DR模型(AR2)与GR模型(NCI)之间的对比实验,证实了记忆机制至少会带来三大挑战:
1)细粒度文档特征模糊:
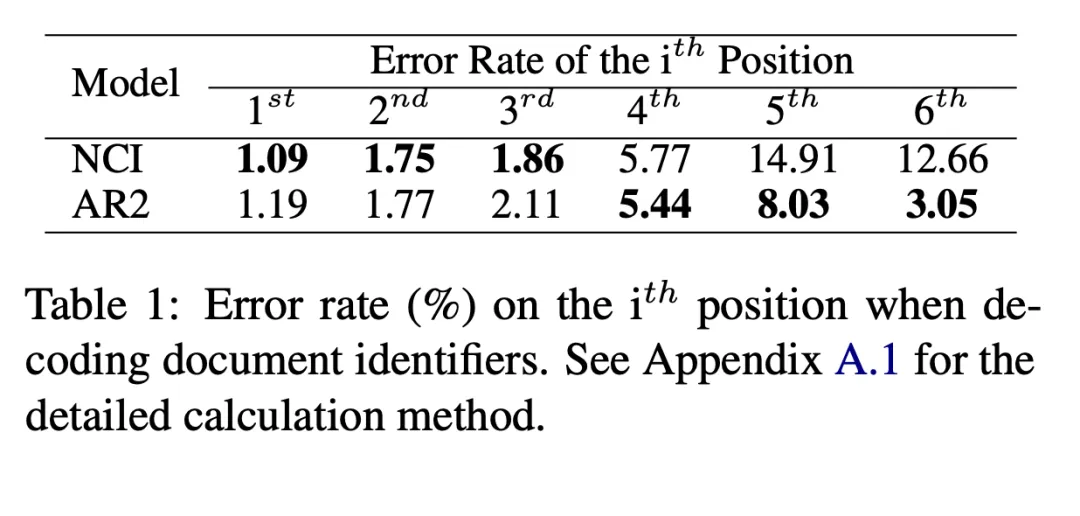
我们分别计算了 NCI 和 AR2 在由粗到细解码文档标识符的每一位时发生错误的概率。对于 AR2,我们通过向量匹配找到给定查询最相关的文档对应的标识符,再统计标识符的首次出错步数,得到 AR2 对应的分步解码错误率。如表1所示,NCI 在解码的前半段中表现良好,而后半段中错误率较高,AR2 与之相反。这说明 NCI 通过整体记忆库,能较好地完成查找到候选文档语义空间的粗粒度映射。但是由于训练过程中的选择特征是由查找来决定的,因此其细粒度映射难以被准确记忆,故而在细粒度映射时表现不佳。
2)文档库规模受限:
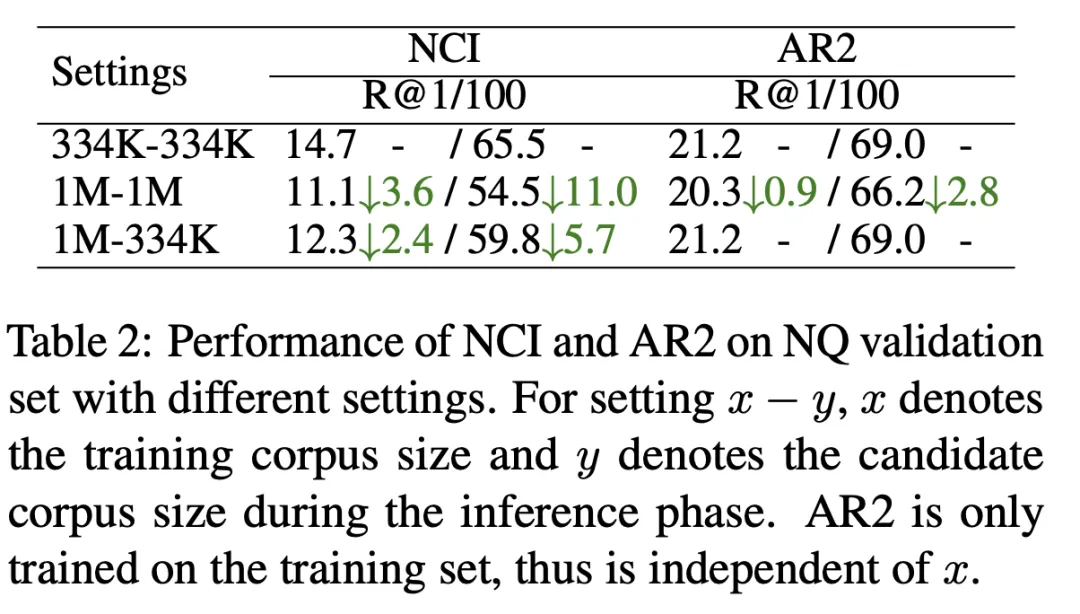
如表 2 所示,我们分别以 334K 的候选文档库大小(第一行)和 1M 的候选文档大小(第二行)训练了 NCI 模型并以 R@k 指标进行测试。结果表明 NCI 在 R@100 上下降了 11 point,对比之下 AR2 只下降了 2.8 point。为了探究候选文档库规模扩大使 NCI 性能显著下降的原因,我们进一步测试了在 1M 文档库上训练的 NCI 模型在以 334K 为候选文档库时的测试结果(第三行)。与第一行相比,NCI 记忆更多文档的负担导致了其召回性能的显著下降,这说明模型有限的记忆容量限制了其记忆大规模的候选文档库。
3)索引更新困难:
当新文档需要加入候选库时,需要更新文档标识符,并且需要重新训练模型以重新记忆所有文档。否则,过时的映射关系(查询到文档标识符和文档标识符到文档)将显著降低检索性能。
上述问题阻碍了 GR 在真实场景下的应用。为此,我们在分析后认为 DR 的匹配机制与记忆机制有着互补的关系,因此考虑将其引入 GR,在保留记忆机制的同时抑制其带来的弊端。我们提出了生成式密集检索新范式(Generative Dense Retrieval,GDR):
- 我们整体设计了由粗到细的两阶段检索框架,利用记忆机制实现簇间匹配(查询到文档簇的映射),通过向量匹配机制完成簇内匹配(文档簇到文档的映射)。
- 为了协助模型记忆候选文档库,我们构建了记忆友好的文档簇标识符构建策略,以模型记忆容量为基准控制文档簇的划分粒度,增益簇间匹配效果。
- 在训练阶段,我们依据两阶段检索的特点提出文档簇自适应的负采样策略,增强簇内负样本的权重,增益簇内匹配效果。
2.1 基于记忆机制的簇间匹配
以查询作为输入,我们利用语言模型记忆候选文档库,并自回归生成 k 个相关文档簇(CID),完成如下映射:
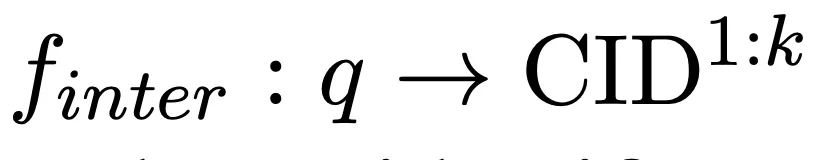
在这一过程中,CID 的生成概率为:
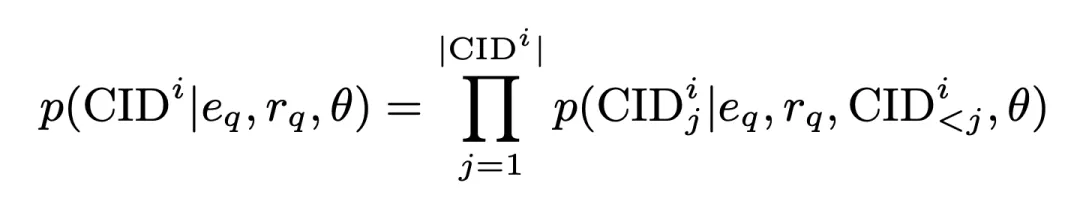
其中
是编码器产生的所有查询嵌入,
是编码器产生的一维查询表征。该概率同时作为簇间匹配分数被存储,参与后续运算。基于此,我们采用标准交叉熵损失训练模型:
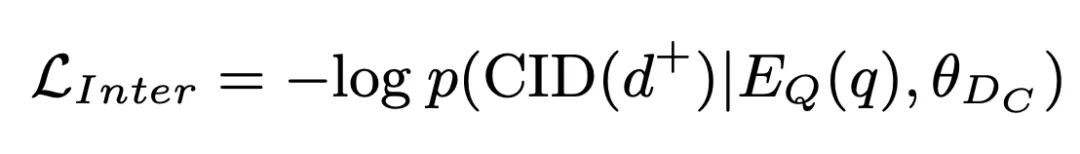
2.2 基于向量匹配机制的簇内匹配
我们进一步从候选文档簇内检索候选文档,完成簇内匹配:
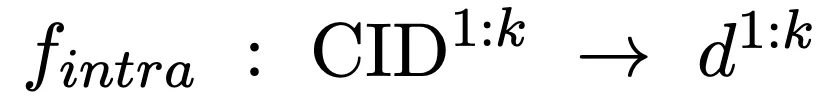
我们引入一个文档编码器提取候选文档的表征,这一过程会离线完成。以此为基础,计算簇内文档与查询间的相似度,作为簇内匹配分数:
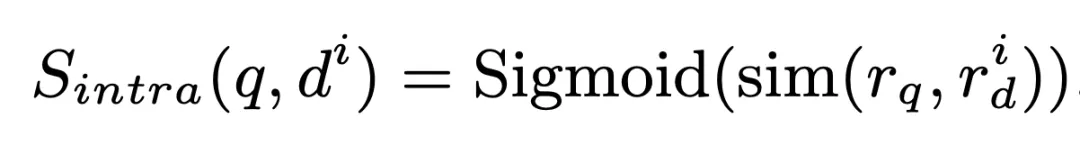
在这一过程中,NLL loss 被用来训练模型:
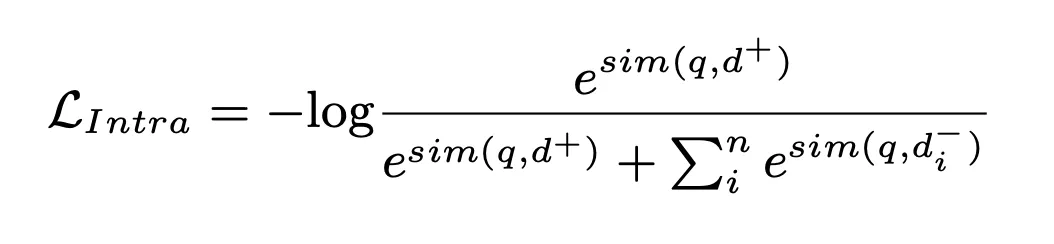
最后,我们计算文档的簇间匹配分数与簇内匹配分数的加权值并进行排序,选出其中的 Top K 作为检索出的相关文档:
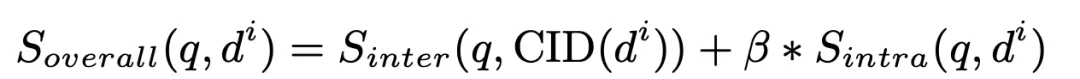
其中 beta 在我们的实验中设定为 1。
2.3 记忆友好的文档簇标识符构建策略
为了充分利用模型有限的记忆容量实现查询与候选文档库之间的深度交互,我们提出记忆友好的文档簇标识符构建策略。该策略首先以模型记忆容量为基准,计算簇内文档数上限:
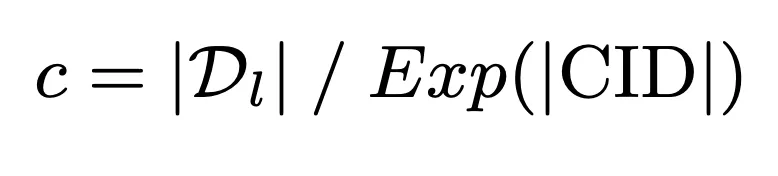
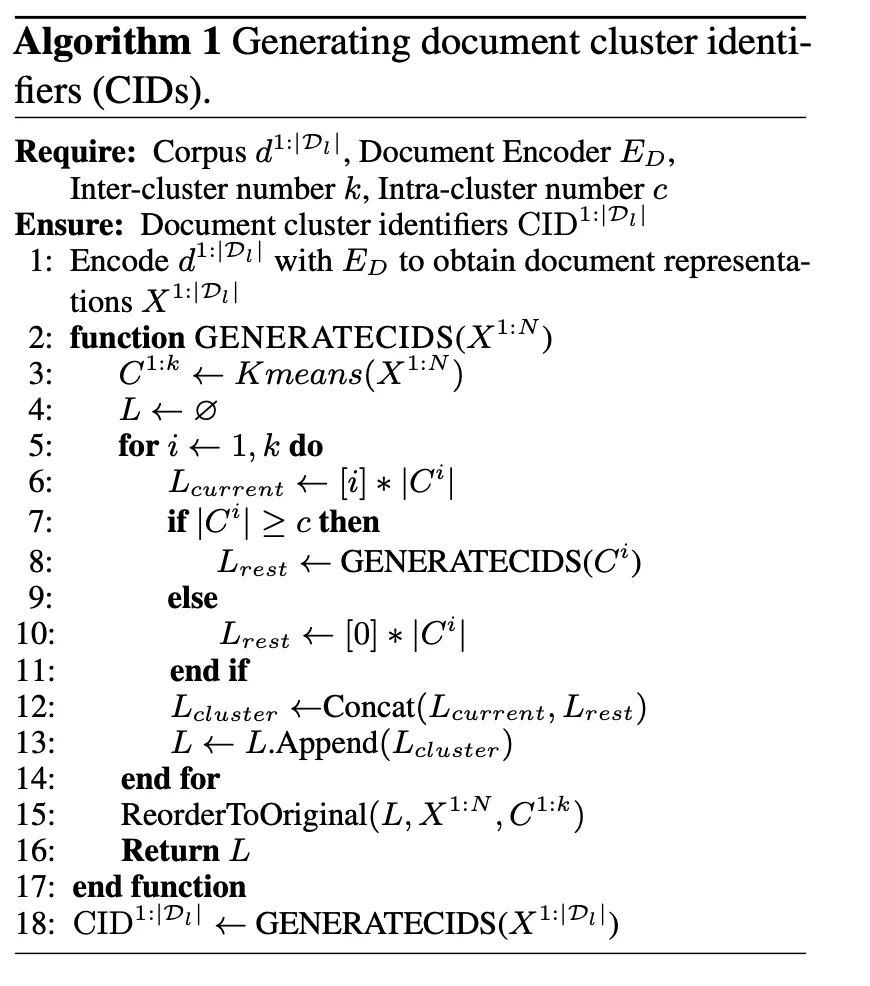
在此基础上,进一步通过 K-means 算法构建文档簇标识符,保障模型的记忆负担不超过其记忆容量:
2.4 文档簇自适应的负采样策略
GDR 两阶段的检索框架决定了在簇内匹配过程中簇内的负样本所占比重更大。为此,我们在第二阶段训练过程中以文档簇划分为基准,显式增强了簇内负样本的权重,从而获得更好的簇内匹配效果:
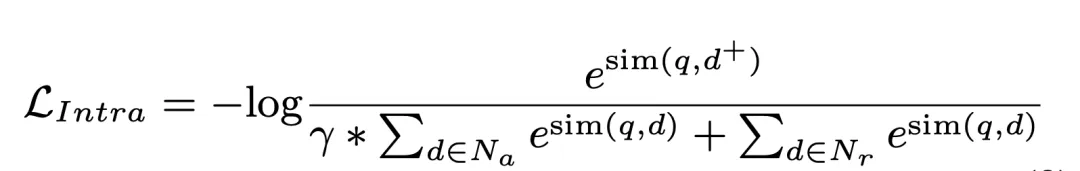
3.实验
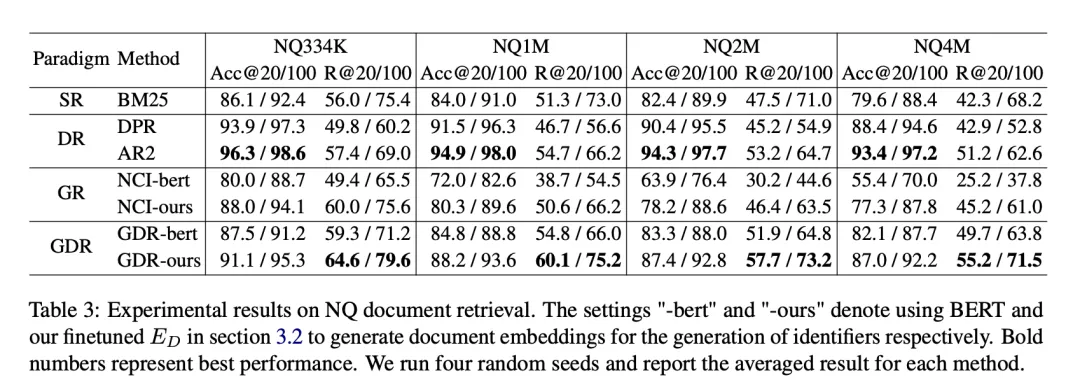
实验中使用的数据集为 Natural Questions (NQ),它包含 58K 个训练对(查询和相关文档)以及 6K 个验证对,伴随着 21M 个候选文档库。每个查询多个相关文档,这对模型的召回性能提出了更高的要求。为了评估 GDR 在不同规模文档库上的性能,我们构建了 NQ334K、NQ1M、NQ2M 和 NQ4M 等不同设置,通过向 NQ334K 添加来自完整 21M 语料库的其余段落来实现。GDR 在每个数据集上分别生成 CIDs,以防止更大候选文档库的语义信息泄露到较小的语料库中。我们采用 BM25(Anserini 实现)作为 SR 基线,DPR 和 AR2 作为 DR 基线,NCI 作为 GR 的基线。评价指标包括 R@k 和 Acc@k。
3.1 主实验结果
在 NQ 数据集上,GDR 在 R@k 指标上平均提高了 3.0,而在 Acc@k 指标上排名第二。这表明 GDR 通过粗到细的检索过程,最大化了记忆机制在深度交互和匹配机制在细粒度特征辨别中的优势。
3.2 扩展到更大的语料库
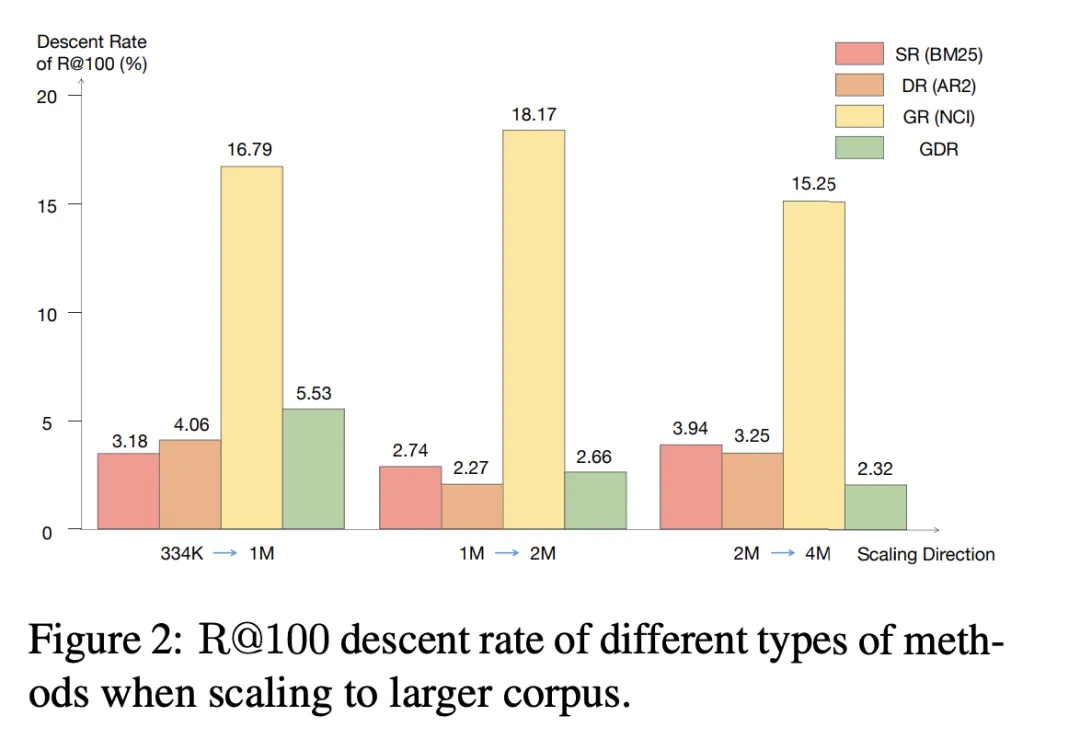
我们注意到当候选语料库扩展到更大的规模时,SR 和 DR 的 R@100 下降率保持在 4.06% 以下,而 GR 在所有三个扩展方向上的下降率超过了 15.25%。相比之下,GDR 通过将记忆内容集中在固定体量的语料库粗粒度特征上,实现了平均 3.50% 的 R@100 下降率,与 SR 和 DR 相近。
3.3 消融实验
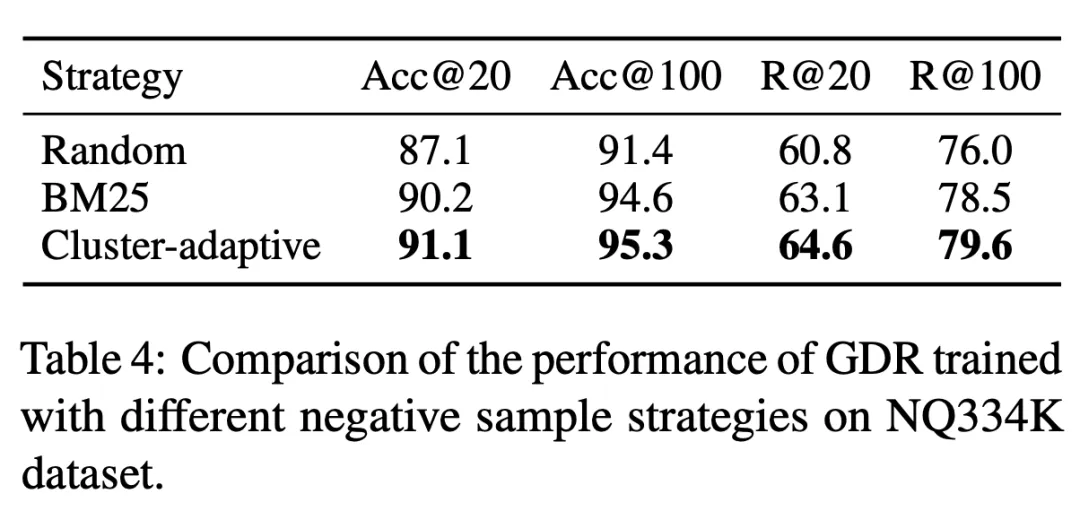
表 3 中 GDR-bert 与 GDR-ours 分别代表了传统和我们的 CID 构建策略下对应的模型表现,实验证明使用记忆友好的文档簇标识符构建策略,可以显著减轻记忆负担,从而带来更好的检索性能。此外,表 4 表明 GDR 训练时采用的文档簇自适应的负采样策略,通过提供更多的文档簇内辨别信号,增强了细粒度匹配能力。
3.4 新文档加入
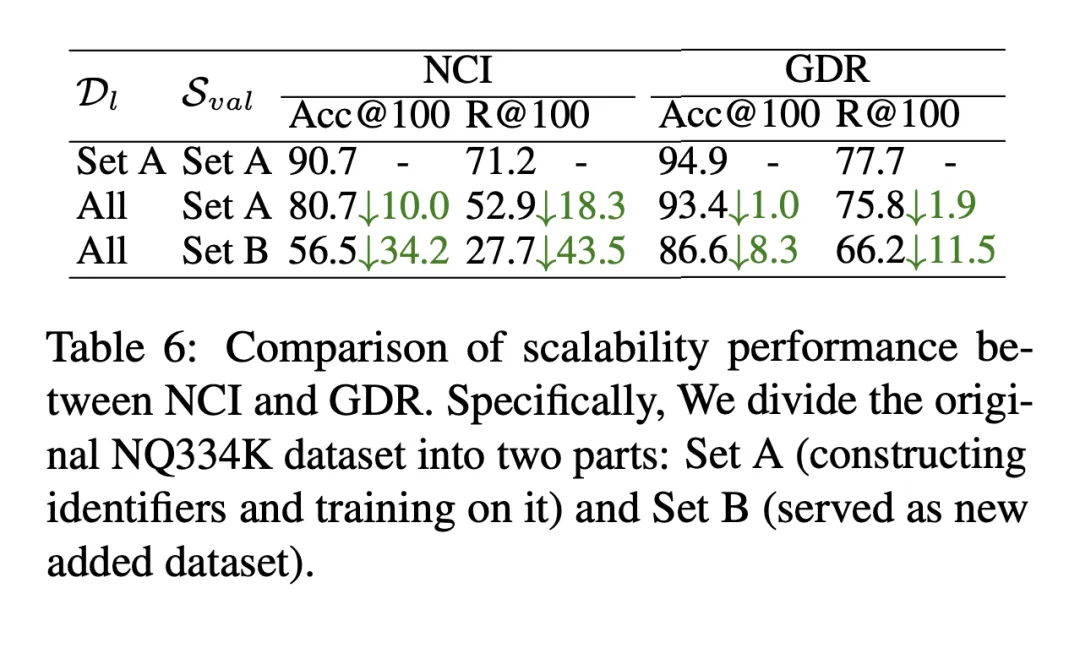
当有新文档加入候选文档库时,GDR 将新文档加入距离最近的文档簇聚类中心,并赋予相应标识符,同时通过文档编码器提取向量表征更新向量索引,从而完成对新文档的快速扩展。如表 6 所示,在添加新文档到候选语料库的设定下,NCI 的 R@100 下降了 18.3 个百分点,而 GDR 的性能仅下降了 1.9 个百分点。这表明 GDR 通过引入匹配机制缓解记忆机制的难以扩展性,在无需重新训练模型的情况下保持了良好的召回效果。
3.5 局限性
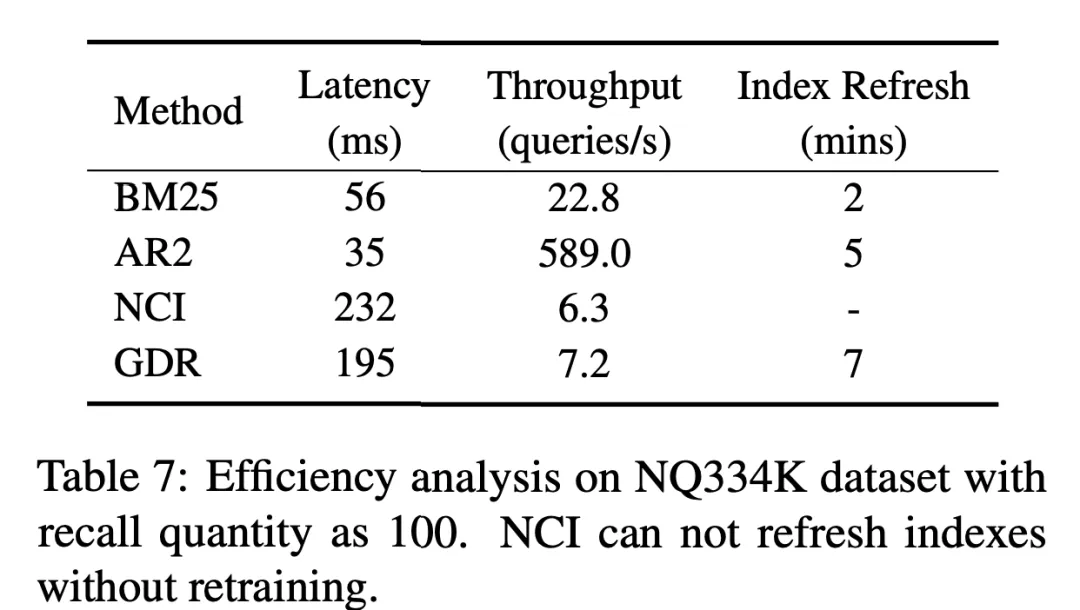
受限于语言模型自回归生成的特点,尽管 GDR 在第二阶段引入了向量匹配机制,相比于 GR 实现了显著的检索效率提升,但相比于 DR 与 SR 仍有较大的提升空间。我们期待未来有更多的研究帮助缓解记忆机制引入检索框架时带来的时延问题。
4.结语
本项研究中,我们深入探讨了记忆机制在信息检索中的双刃剑效应:一方面这一机制实现了查询与候选文档库的深度交互,弥补了密集检索的不足;另一方面模型有限的记忆容量与更新索引的复杂性,它在面对大规模和动态变化候选文档库时显得捉襟见肘。为了解决这一难题,我们创新性地将记忆机制与向量匹配机制进行层次化结合,实现两者扬长避短、相得益彰的效果。
我们提出了一个全新的文本检索范式,生成式密集检索(GDR)。GDR 该范式对于给定查询进行由粗到细的两阶段检索,先由记忆机制自回归地生成文档簇标识符实现查询到文档簇的映射,再由向量匹配机制计算查询与文档间相似度完成文档簇到文档的映射。
记忆友好的文档簇标识符构建策略保障了模型的记忆负担不超过其记忆容量,增益簇间匹配效果。文档簇自适应的负采样策略增强了区分簇内负样本的训练信号,增益簇内匹配效果。大量实验证明,GDR 在大规模候选文档库上能够取得优异的检索性能,同时能够高效应对文档库更新。
作为一次对传统检索方法进行优势整合的成功尝试,生成式密集检索范式具有召回性能好、可扩展性强、在海量候选文档库场景下表现稳健等优点。随着大语言模型在理解与生成能力上的不断进步,生成式密集检索的性能也将进一步提升,为信息检索开辟更加广阔的天地。
论文地址:https://arxiv.org/abs/2401.10487
5.作者简介
- 袁沛文
现博士就读于北京理工大学,小红书社区搜索组实习生,在 NeurIPS、ICLR、AAAI 、EACL 等发表多篇一作论文。主要研究方向为大语言模型推理与评测、信息检索。 - 王星霖
现博士就读于北京理工大学,小红书社区搜索组实习生,在 EACL、NeurIPS、ICLR 等发表数篇论文,在国际对话技术挑战赛 DSTC11 上获得测评赛道第二名。主要研究方向为大语言模型推理与测评、信息检索。 - 冯少雄
负责小红书社区搜索向量召回。博士毕业于北京理工大学,在 ICLR、AAAI、ACL、EMNLP、NAACL、EACL、KBS 等机器学习、自然语言处理领域顶级会议/期刊上发表数篇论文。主要研究方向为大语言模型测评推理蒸馏、生成式检索、开放域对话生成等。 - 道玄
小红书交易搜索团队负责人。博士毕业于浙江大学,在 NeurIPS、ICML 等机器学习领域顶级会议上发表数篇一作论文,长期作为多个顶级会议/期刊审稿人。主要业务覆盖内容搜索、电商搜索、直播搜索等。 - 曾书
硕士毕业于清华大学电子系,在互联网领域从事自然语言处理、推荐、搜索等相关方向的算法工作,目前在小红书社区搜索负责召回和垂类搜索等技术方向。








火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。