


使用Huggingface微调BART模型在WMT16数据集上进行翻译的代码示例
Bartender 是一款经典的 Mac 菜单栏图标管理工具,内含拖拽管理、快速搜索等实用功能,与系统高度集成。界面整理和高频系统操作被放到一起考虑,桌面或窗口内容一多时,管理起来会更省心。
如果你想在翻译任务上测试一个新的体系结构,比如在自定义数据集上训练一个新的标记,那么处理起来会很麻烦,所以在本文中,我将介绍添加新标记的预处理步骤,并介绍如何进行模型微调。因为HuggingfaceHub有很多预训练过的模型,可以很容易地找到预训练标记器。但是我们要添加一个标记可能就会有些棘手,下面我们来完整的介绍如何实现它,首先加载和预处理数据集。加载数据集我们使用WMT16数据集及其罗马尼亚语-英语子集。load_dataset()函数将从Huggingface下载并加载任何可用的数据集。impor
如果你想在翻译任务上测试一个新的体系结构,比如在自定义数据集上训练一个新的标记,那么处理起来会很麻烦,所以在本文中,我将介绍添加新标记的预处理步骤,并介绍如何进行模型微调。
因为Huggingface Hub有很多预训练过的模型,可以很容易地找到预训练标记器。但是我们要添加一个标记可能就会有些棘手,下面我们来完整的介绍如何实现它,首先加载和预处理数据集。
加载数据集
我们使用WMT16数据集及其罗马尼亚语-英语子集。load_dataset()函数将从Huggingface下载并加载任何可用的数据集。
import datasets

 dataset = datasets.load_dataset("stas/wmt16-en-ro-pre-processed", cache_dir="./wmt16-en_ro")
在上图1中可以看到数据集内容。我们需要将其“压平”,这样可以更好的访问数据,让后将其保存到硬盘中。
def flatten(batch):
 batch['en'] = batch['translation']['en']
 batch['ro'] = batch['translation']['ro']

 return batch

 # Map the 'flatten' function
 train = dataset['train'].map( flatten )
 test = dataset['test'].map( flatten )
 validation = dataset['validation'].map( flatten )

 # Save to disk
 train.save_to_disk("./dataset/train")
 test.save_to_disk("./dataset/test")
 validation.save_to_disk("./dataset/validation")
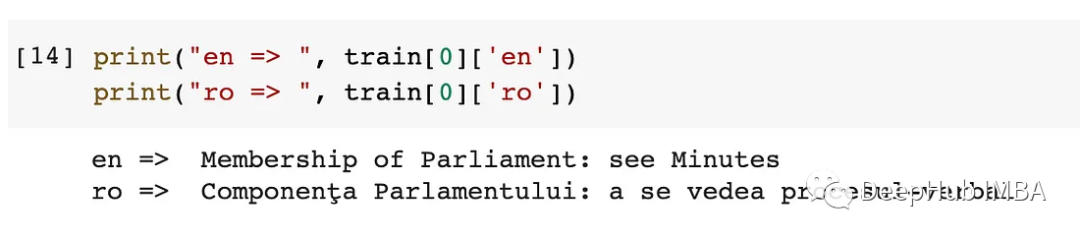
下图2可以看到,已经从数据集中删除了“translation”维度。
标记器
标记器提供了训练标记器所需的所有工作。它由四个基本组成部分:(但这四个部分不是所有的都是必要的)
Models:标记器将如何分解每个单词。例如,给定单词“playing”:i) BPE模型将其分解为“play”+“ing”两个标记,ii) WordLevel将其视为一个标记。
Normalizers:需要在文本上发生的一些转换。有一些过滤器可以更改Unicode、小写字母或删除内容。
Pre-Tokenizers:为操作文本提供更大灵活性处理的函数。例如,如何处理数字。数字100应该被认为是“100”还是“1”、“0”、“0”?
Post-Processors:后处理具体情况取决于预训练模型的选择。例如,将 [BOS](句首)或 [EOS](句尾)标记添加到 BERT 输入。
下面的代码使用BPE模型、小写Normalizers和空白Pre-Tokenizers。然后用默认值初始化训练器对象,主要包括
1、词汇量大小使用50265以与BART的英语标记器一致
2、特殊标记,如和
3、初始词汇量,这是每个模型启动过程的预定义列表。
from tokenizers import normalizers, pre_tokenizers, Tokenizer, models, trainers # Build a tokenizer bpe_tokenizer = Tokenizer(models.BPE()) bpe_tokenizer.normalizer = normalizers.Lowercase() bpe_tokenizer.pre_tokenizer = pre_tokenizers.Whitespace() trainer = trainers.BpeTrainer( vocab_size=50265, special_tokens=["", "", "", " ", " "], initial_alphabet=pre_tokenizers.ByteLevel.alphabet(), )
使用Huggingface的最后一步是连接Trainer和BPE模型,并传递数据集。根据数据的来源,可以使用不同的训练函数。我们将使用train_from_iterator()。
def batch_iterator():
 batch_length = 1000
 for i in range(0, len(train), batch_length):
 yield train[i : i + batch_length]["ro"]

 bpe_tokenizer.train_from_iterator( batch_iterator(), length=len(train), trainer=trainer )

 bpe_tokenizer.save("./ro_tokenizer.json")
BART微调
现在可以使用使用新的标记器了。
from transformers import AutoTokenizer, PreTrainedTokenizerFast

 en_tokenizer = AutoTokenizer.from_pretrained( "facebook/bart-base" );
 ro_tokenizer = PreTrainedTokenizerFast.from_pretrained( "./ro_tokenizer.json" );
 ro_tokenizer.pad_token = en_tokenizer.pad_token

 def tokenize_dataset(sample):
 input = en_tokenizer(sample['en'], padding='max_length', max_length=120, truncation=True)
 label = ro_tokenizer(sample['ro'], padding='max_length', max_length=120, truncation=True)

 input["decoder_input_ids"] = label["input_ids"]
 input["decoder_attention_mask"] = label["attention_mask"]
 input["labels"] = label["input_ids"]

 return input

 train_tokenized = train.map(tokenize_dataset, batched=True)
 test_tokenized = test.map(tokenize_dataset, batched=True)
 validation_tokenized = validation.map(tokenize_dataset, batched=True)
上面代码的第5行,为罗马尼亚语的标记器设置填充标记是非常必要的。因为它将在第9行使用,标记器使用填充可以使所有输入都具有相同的大小。
下面就是训练的过程:
from transformers import BartForConditionalGeneration
 from transformers import Seq2SeqTrainingArguments, Seq2SeqTrainer

 model = BartForConditionalGeneration.from_pretrained("facebook/bart-base" )

 training_args = Seq2SeqTrainingArguments(
 output_dir="./",
 evaluation_strategy="steps",
 per_device_train_batch_size=2,
 per_device_eval_batch_size=2,
 predict_with_generate=True,
 logging_steps=2,# set to 1000 for full training
 save_steps=64,# set to 500 for full training
 eval_steps=64,# set to 8000 for full training
 warmup_steps=1,# set to 2000 for full training
 max_steps=128, # delete for full training
 overwrite_output_dir=True,
 save_total_limit=3,
 fp16=False, # True if GPU
 )

 trainer = Seq2SeqTrainer(
 model=model,
 args=training_args,
 train_dataset=train_tokenized,
 eval_dataset=validation_tokenized,
 )

 trainer.train()
过程也非常简单,加载bart基础模型(第4行),设置训练参数(第6行),使用Trainer对象绑定所有内容(第22行),并启动流程(第29行)。上述超参数都是测试目的,所以如果要得到最好的结果还需要进行超参数的设置,我们使用这些参数是可以运行的。
推理
推理过程也很简单,加载经过微调的模型并使用generate()方法进行转换就可以了,但是需要注意的是对源 (En) 和目标 (RO) 序列使用适当的分词器。
总结
虽然在使用自然语言处理(NLP)时,标记化似乎是一个基本操作,但它是一个不应忽视的关键步骤。HuggingFace的出现可以方便的让我们使用,这使得我们很容易忘记标记化的基本原理,而仅仅依赖预先训练好的模型。但是当我们希望自己训练新模型时,了解标记化过程及其对下游任务的影响是必不可少的,所以熟悉和掌握这个基本的操作是非常有必要的。
本文代码:https://github.com/AlaFalaki/tutorial_notebooks/blob/main/translation/hf_bart_translation.ipynb









火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

PixTV 是一款在浏览器中使用的 AI 视觉内容创作平台,提供图片、视频、音频、文字生成、AI 分镜、局部重绘、提示词反推和无限画布等工具,适合短剧、漫剧、广告及社交媒体内容制作。


Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,