展开菜单
首页 精品内容 本月促销 装机必备 Windows PDF教程 macOS软件 IOS软件 Android AI 专题
全部分类

当前位置:

首页 > 业界资讯 > DeepMind升级Transformer,前向通过FLOPs最多可降一半

DeepMind升级Transformer,前向通过FLOPs最多可降一半

引入混合深度,DeepMind新设计可大幅提升Transformer效率。Transformer的重要性无需多言,目前也有很多研究团队致力于改进这种变革性技术,其中一个重要的改进方向是提升Transformer的效率,比如让其具备自适应计算能力,从而可以节省下不必要的计算。正如不久前Transformer架构的提出之一、NEARProtocol联合创始人IlliyaPolosukhin在与黄仁勋的对话中说到的那样:「自适应计算是接下来必须出现的。我们要关注,在特定问题上具体要花费多少计算资源。」其实人类就

本文目录

    引入混合深度,DeepMind 新设计可大幅提升 Transformer 效率。

    Transformer 的重要性无需多言,目前也有很多研究团队致力于改进这种变革性技术,其中一个重要的改进方向是提升 Transformer 的效率,比如让其具备自适应计算能力,从而可以节省下不必要的计算。

    正如不久前 Transformer 架构的提出之一、NEAR Protocol 联合创始人 Illiya Polosukhin 在与黄仁勋的对话中说到的那样:「自适应计算是接下来必须出现的。我们要关注,在特定问题上具体要花费多少计算资源。」DeepMind升级Transformer,前向通过FLOPs最多可降一半
    其实人类就天生具备自适应计算的能力 —— 人在解决各种不同的问题时,会自然地分配不同的时间和精力。

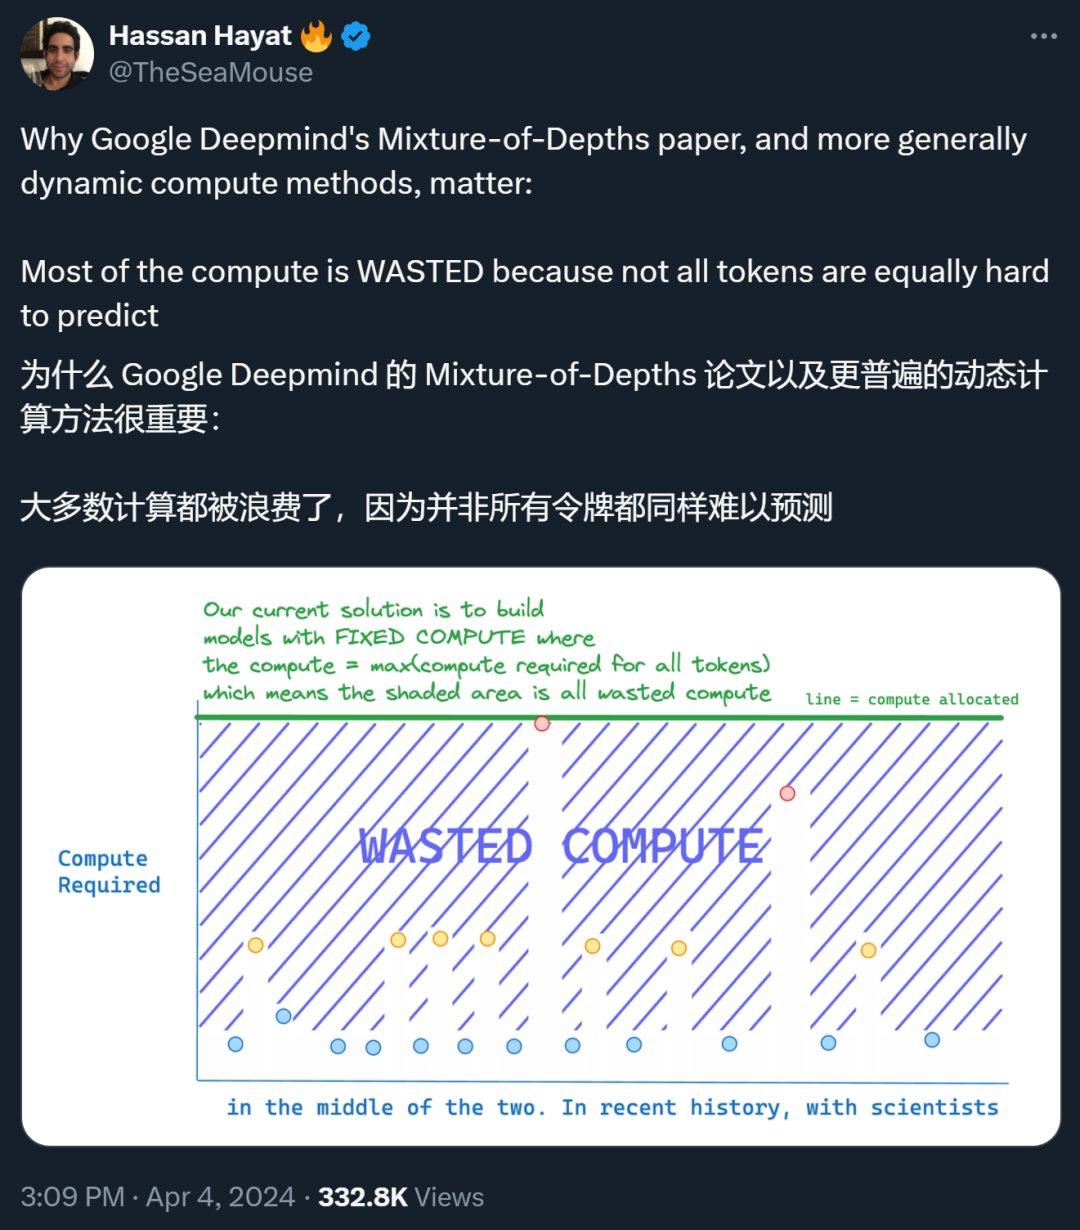
    语言建模也应如此,为了得到准确的预测结果,并不需要为所有 token 和序列都投入同样的时间或资源。但是,Transformer 模型在一次前向传播中却会为每个 token 花费同等的计算量。这不禁让人哀叹:大部分计算都被浪费了!
    DeepMind升级Transformer,前向通过FLOPs最多可降一半
    理想情况下,如果可以不执行非必要的计算,就可以降低 Transformer 的计算预算。

    条件式计算这种技术可在需要执行计算时才执行计算,由此可以减少总计算量。之前许多研究者已经提出了多种可以评估何时执行计算以及使用多少计算量的算法。

    但是,对于这个颇具挑战性的问题,普遍使用的解决形式可能无法很好地应对现有的硬件限制,因为它们往往会引入动态计算图。最有潜力的条件式计算方法反而可能是那些能协调使用当前硬件栈的方法,其会优先使用静态计算图和已知的张量大小(基于对硬件的最大利用而选取这个张量大小)。

    近日,Google DeepMind 研究了这个问题,他们希望使用更低的计算预算来缩减 Transformer 使用的计算量。
    DeepMind升级Transformer,前向通过FLOPs最多可降一半
    • 论文标题:Mixture-of-Depths: Dynamically allocating compute in transformer-based language models
    • 论文地址:https://arxiv.org/pdf/2404.02258.pdf
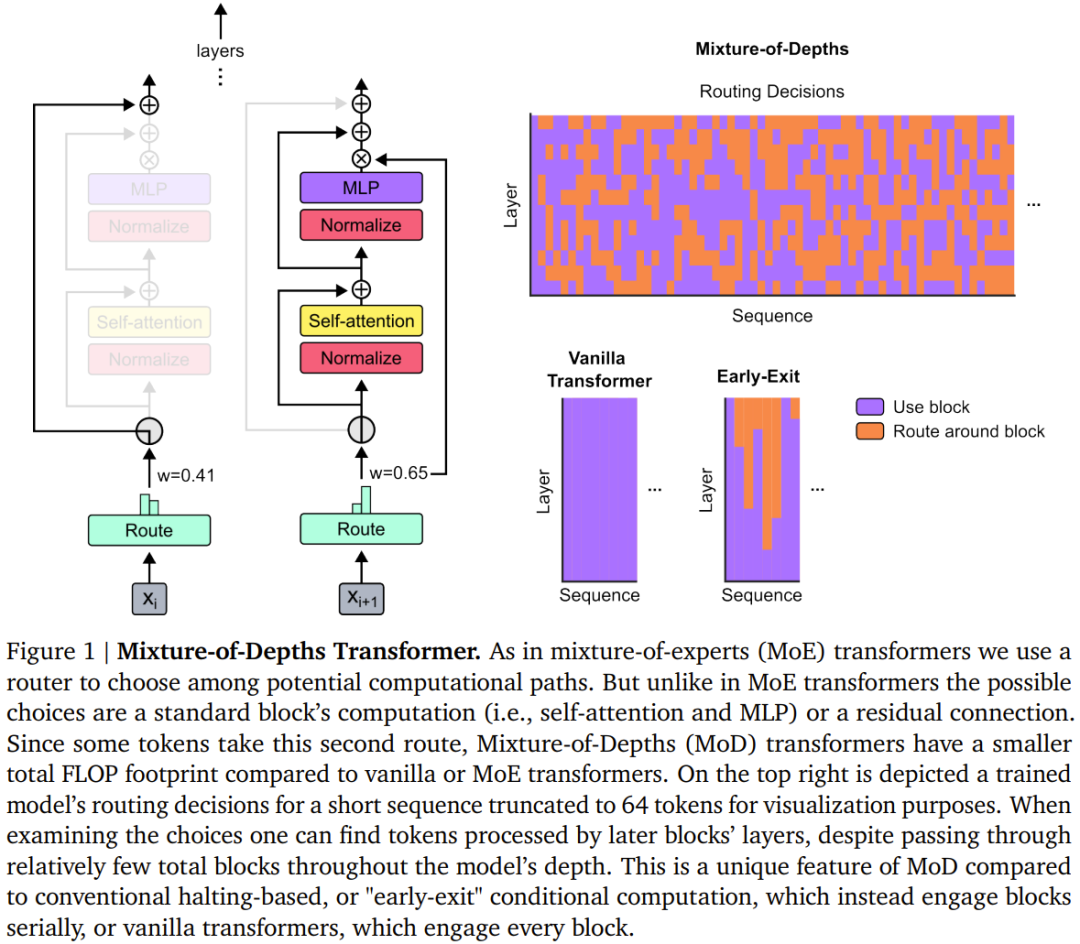
    他们设想:在每一层中,网络必须学会为每个 token 做决策,从而动态地分配可用计算预算。在他们的具体实现中,总计算量由用户在训练之前设定并且不再更改,而非网络工作时执行决策的函数。这样一来,便可以提前预知并利用硬件效率收益(比如内存足迹减少量或每次前向传播的 FLOPs 减少量)。该团队的实验表明:可以在不损害网络整体性能的前提下获得这些收益。

    DeepMind 的这个团队采用了类似于混合专家(MoE) Transformer 的方法,其中会在整个网络深度上执行动态 token 层面的路由决策。

    而与 MoE 不同的是,这里他们的选择是:要么是将计算应用于 token(和标准 Transformer 一样),要么就是通过一个残差连接绕过它(保持不变,节省计算)。另一个与 MoE 的不同之处是:这里是将这种路由机制同时用在 MLP 和多头注意力上。因此,这也会影响网络处理的键值和查询,因此该路由不仅要决定更新哪些 token,还要决定哪些 token 可供关注。

    DeepMind 将这一策略命名为 Mixture-of-Depths(MoD),以突显这一事实:各个 token 在 Transformer 深度上通过不同数量的层或模块。我们这里将其翻译成「混合深度」,见图 1。
    DeepMind升级Transformer,前向通过FLOPs最多可降一半
    MoD 支持使用者权衡考量性能与速度。一方面,使用者可以使用与常规 Transformer 同等的训练 FLOPs 来训练 MoD Transformer,这可为最终的对数概率训练目标带来多达 1.5% 的提升。另一方面,MoD Transformer 使用更少的计算量就能达到与常规 Transformer 同样的训练损失 —— 每一次前向传播的 FLOPs 可少最多 50%。

    这些结果表明,MoD Transformer 可以学习智能地路由(即跳过不必要的计算)。

    实现混合深度(MoD)Transformer 

    概况来说,其策略如下:

    • 设定一个静态的计算预算,该预算低于等价的常规 Transformer 所需的计算量;做法是限制序列中可参与模块计算(即自注意力模块和后续的 MLP)的 token 数量。举个例子,常规 Transformer 可能允许序列中的所有 token 都参与自注意力计算,但 MoD Transformer 可限定仅使用序列中 50% 的 token。 
    • 针对每个 token,每个模块中都有一个路由算法给出一个标量权重;该权重表示路由对各个 token 的偏好 —— 是参与模块的计算还是绕过去。 
    • 在每个模块中,找到最大的前 k 个标量权重,它们对应的 token 会参与到该模块的计算中。由于必定只有 k 个 token 参与到该模块的计算中,因此其计算图和张量大小在训练过程中是静态的;这些 token 都是路由算法认定的动态且与上下文有关的 token。
    路由方案

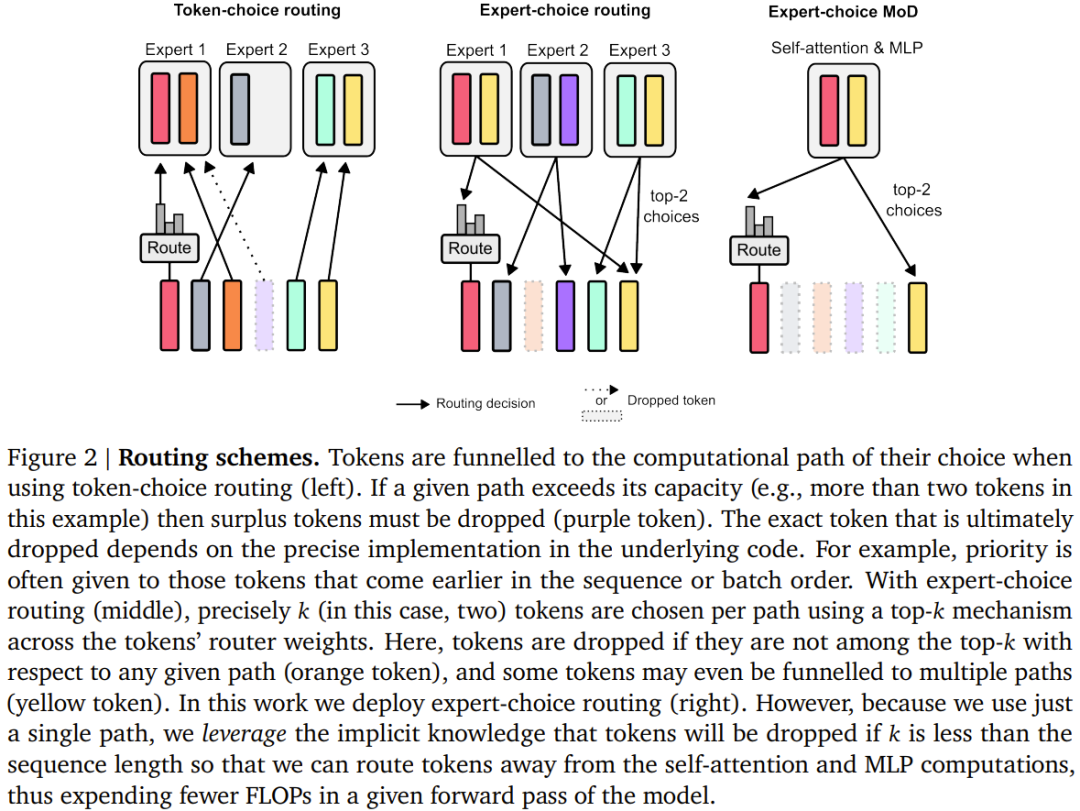
    该团队考虑了两种学习到的路由方案(见图 2):token 选择型和专家选择型。
    DeepMind升级Transformer,前向通过FLOPs最多可降一半
    在 token 选择型路由方案中,路由算法会跨计算路径(比如跨 MoE Transformer 中的专家身份)生成针对每个 token 的概率分布。然后 token 会被传送到它们偏好的路径(即概率最高的路径),而辅助损失可以确保所有 token 不会收敛到同一路径。token 选择型路由可能会有负载平衡问题,因为不能确保 token 在可能的路径之间划分适当。

    专家选择型路由则是将上述方案反过来:不是让 token 选择它们偏好的路径,而是让每条路径基于 token 偏好选择前 k 个 token(top-k)。这能确保负载完美平衡,因为每条路径总是保证 k 个 token。但是,这也可能导致某些 token 被过处理或欠处理,因为某些 token 可能是多条路径的前 k 名,另一些 token 则可能没有相应路径。

    DeepMind 的选择是使用专家选择型路由,原因有三。

    第一,它无需辅助性的平衡损失。

    第二,由于选取前 k 名这一操作取决于路由权重的幅度,因此该路由方案允许使用相对路由权重,这有助于确定当前模块计算最需要哪些 token;路由算法可以通过适当地设定权重来尽力确保最关键的 token 是在前 k 名之中 —— 这是 token 选择型路由方案无法做到的。在具体的用例中,有一条计算路径本质上是 null 操作,因此应该避免将重要 token 路由到 null。

    第三,由于路由只会经由两条路径,因此单次 top-k 操作就能高效地将 token 分成两个互斥的集合(每条计算路径一个集合),这能应对上面提及的过处理或欠处理问题。

    该路由方案的具体实现请参看原论文。
     
    采样

    尽管专家选择型路由有很多优点,但它也有一个很明显的问题:top-k 操作是非因果式的。也就是说,一个给定 token 的路由权重是否在前 k 名取决于其之后的路由权重的值,但在执行自回归采样时,我们无法获得这些权重。

    为了解决这个问题,该团队测试了两种方法。

    第一种是引入一个简单的辅助损失;实践证明,其对语言建模主目标的影响程度为 0.2%− 0.3%,但却能够让模型自回归地采样。他们使用了一个二元交叉熵损失,其中路由算法的输出提供 logit,通过选取这些 logit 中的 top-k,就能提供目标(即,如果一个 token 在 top-k 中,就为 1,否则为 0)。

    第二种方法是引入一个小的辅助 MLP 预测器(就像是又一个路由算法),其输入与路由算法的一样(具有 stop gradient),但其输出是一个预测结果:token 是否在序列的 top-k 中。该方法不会影响语言建模目标,实验表明也不会显著影响该步骤的速度。

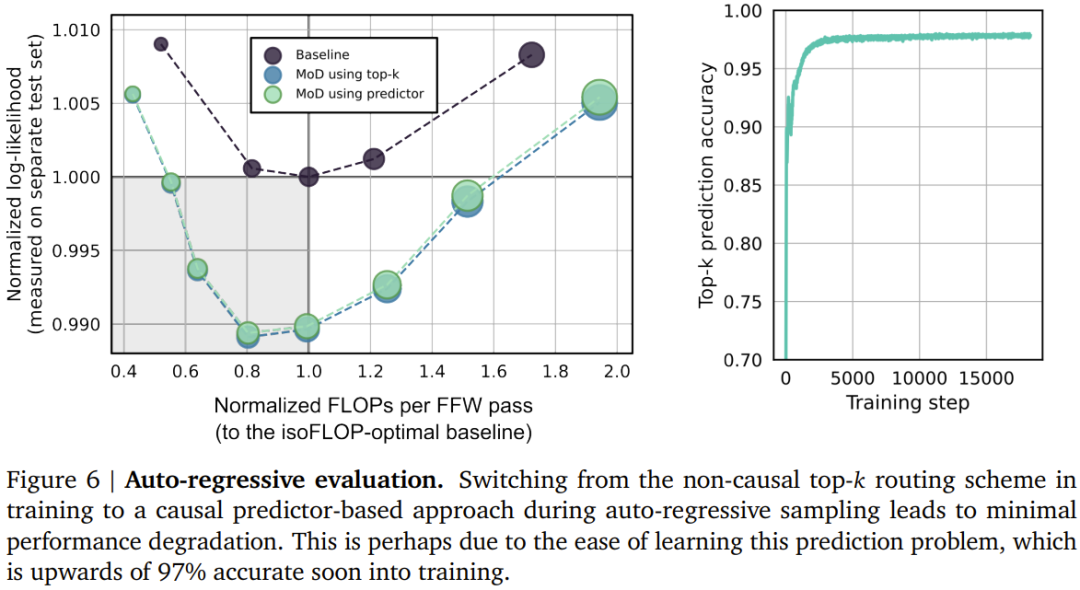
    有了这些新方法,就可以通过选择路由到的 token 来执行自回归采样,也可以根据路由算法的输出绕过一个模块,这无需依赖任何未来 token 的信息。实验结果表明,这是一种相对简单辅助任务,可以很快实现 99% 的准确度。
     
    结果

    训练,isoFLOP 比较

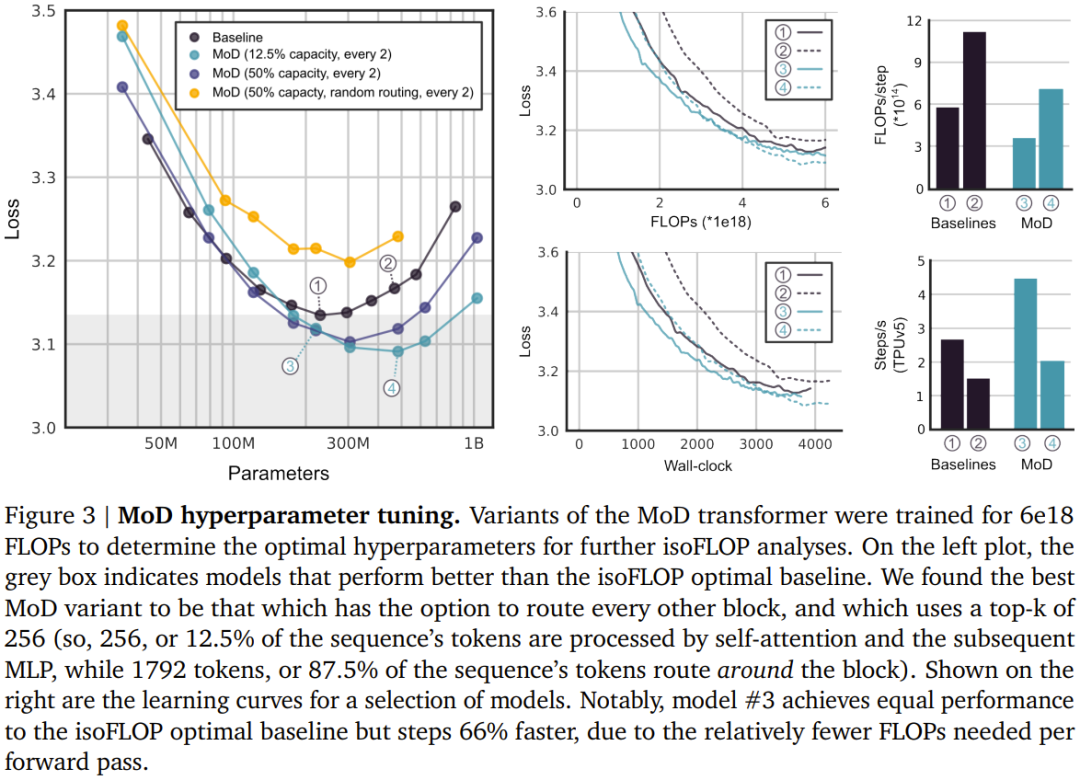
    首先,该团队训练了一些 FLOP 预算相对较小(6e18)的模型,以确定最优的超参数(见下图 3)。
    DeepMind升级Transformer,前向通过FLOPs最多可降一半
    总体而言,可以看到 MoD Transformer 会将基准 isoFLOP 曲线向右下方拖动。也就是说,最优的 MoD Transformer 的损失比最优的基准模型更低,同时参数也更多。这种效应带来了一个幸运的结果:存在一些和最优基准模型表现一样好甚至更好的 MoD 模型(同时步骤速度更快),尽管它们本身在其超参数设置下并不是 isoFLOP 最优的。举个例子,一个 220M 参数量的 MoD 变体(图 3 中的 3 号模型)稍优于 isoFLOP 最优基准模型(参数量也是 220M,图 3 中的 1 号模型),但这个 MoD 变体在训练期间的步骤速度快了 60% 以上。

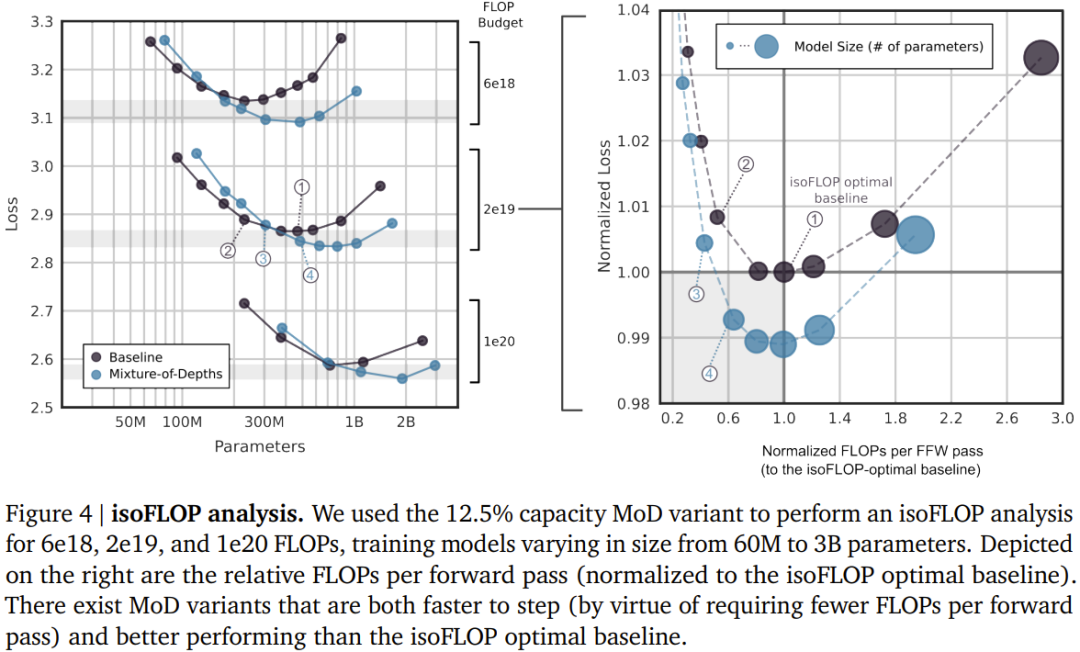
    下图 4 给出了总 FLOPs 为 6e18、2e19 和 1e20 时的 isoFLOP 分析。可以看到,当 FLOP 预算更大时,趋势依然继续。
    DeepMind升级Transformer,前向通过FLOPs最多可降一半
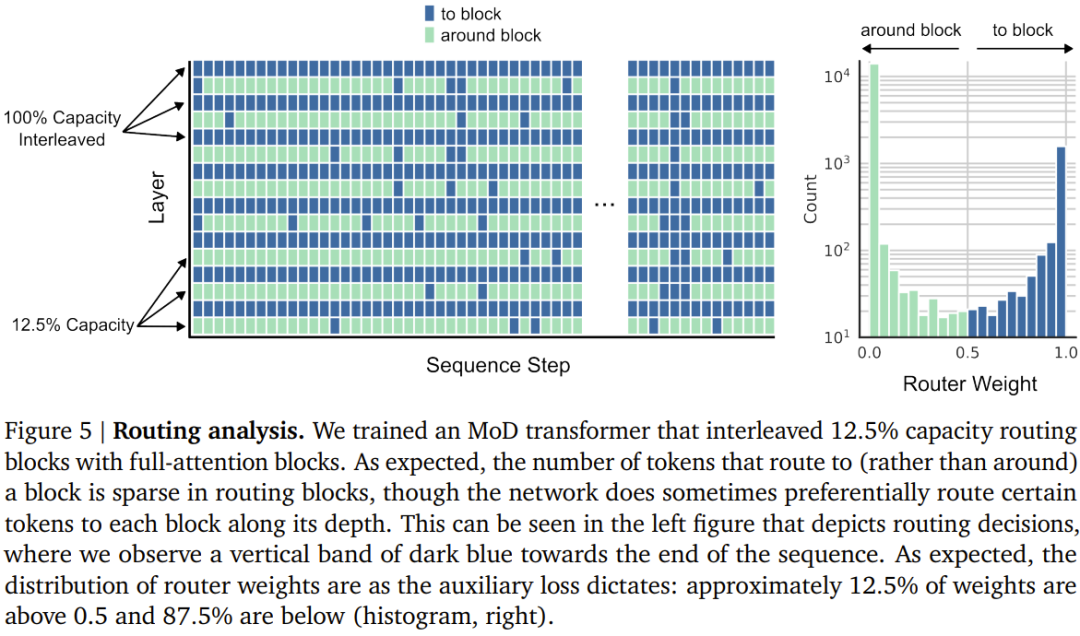
    下图 5 给出了一个使用交织的路由模块训练的 MoD Transformer 的路由决策。尽管其中存在大量绕过模块的情况,但这个 MoD Transformer 依然能实现优于常规 Transformer 的性能。
    DeepMind升级Transformer,前向通过FLOPs最多可降一半
    自回归评估

    他们也评估了 MoD 变体的自回归采样表现,结果见下图 6。这些结果表明 MoD Transformer 所带来的计算节省不仅仅局限于训练设置。
    DeepMind升级Transformer,前向通过FLOPs最多可降一半
    混合深度与专家(MoDE)

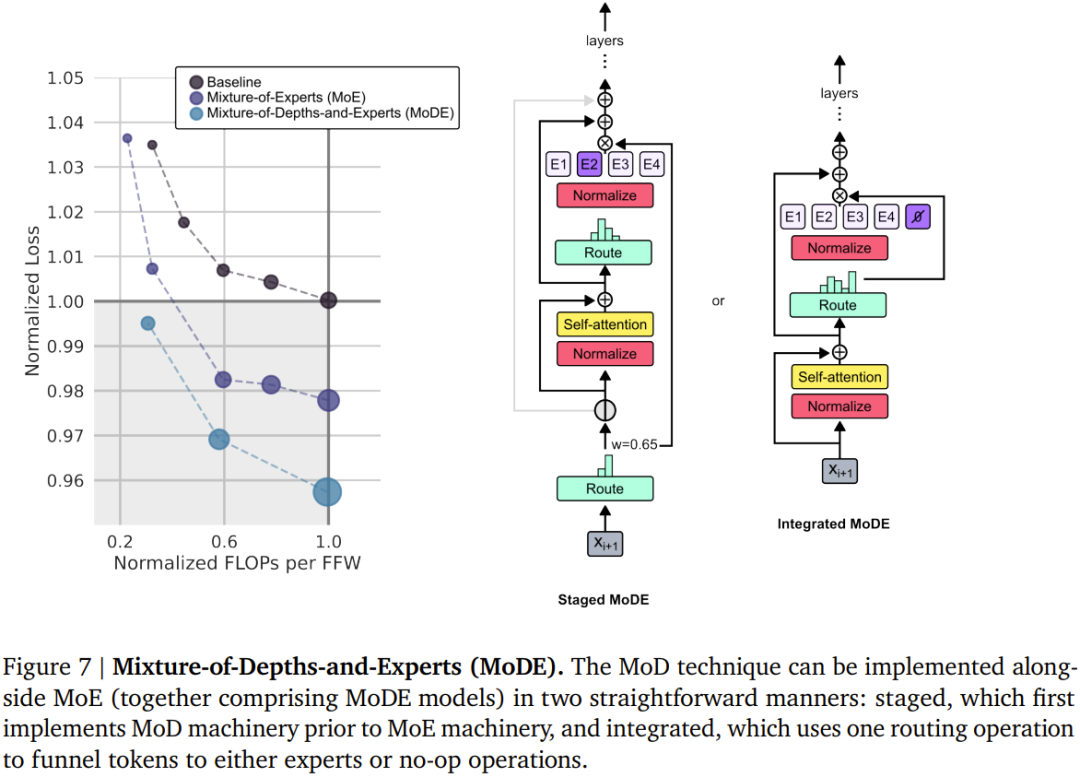
    MoD 技术可以自然地与 MoE 模型整合起来,组成所谓的 MoDE 模型。下图 7 展示了 MoDE 及其带来的提升。
    DeepMind升级Transformer,前向通过FLOPs最多可降一半
    MoDE 有两种变体:分阶段 MoDE 和集成式 MoDE。

    其中分阶段 MoDE 是在自注意力步骤之前进行路由绕过或到达 token 的操作;而集成式 MoDE 则是通过在常规 MLP 专家之间集成「无操作」专家来实现 MoD 路由。前者的优势是允许 token 跳过自注意力步骤,而后者的好处在于其路由机制很简单。

    该团队注意到,以集成方式实现 MoDE 明显优于直接降低专家的能力、依靠丢弃 token 来实现残差路由的设计。
    本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系bd@zhengruan.com
    作者最新文章
    业界资讯
    相关文章 更多
    精品专题 更多
    装机必备

    正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

    Windows

    正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

    PDF教程

    正软商城PDF教程频道提供PDF编辑、转换、合并、拆分、压缩及格式处理方法,同时介绍常用PDF软件和工具的使用技巧。

    macOS软件

    正软商城macOS软件专区,精选适用于Mac电脑的办公、设计、影音、效率、开发和系统工具,提供软件功能介绍、macOS兼容版本、正版授权及购买下载服务。

    IOS软件

    正软商城iOS软件专区,精选适用于iPhone和iPad的办公、学习、影音、设计、效率及AI应用,提供功能介绍、适用设备、系统要求和正版获取方式等信息。

    AI

    正软商城AI软件专区,汇集AI写作、AI绘画、AI视频、AI办公、AI编程、AI翻译、智能客服和数据分析等人工智能工具,提供功能介绍、适用平台、收费方式及正版购买信息。

    Mac软件 更多
    Aperty macOS版
    Aperty macOS版

    Aperty 是 Skylum 推出的 AI 人像修图软件,支持自然肤质修饰、瑕疵处理、面部与身体调整、预设及批量同步。

    火山引擎 网页版
    火山引擎 网页版

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。


    立刻MV 网页版
    立刻MV 网页版

    立刻MV 面向音乐人、内容创作者和品牌团队,帮助用户低成本完成歌曲 MV、歌词视频、AI 分镜、图生视频与最终合成。

    蛙蛙写作 网页版
    蛙蛙写作 网页版

    蛙蛙写作 AI 创作工具,覆盖小说、剧本、文案,一键生成文稿,打通文字转视频全流程,高效解决创作难题。

    讯飞智作 网页版
    讯飞智作 网页版

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    超级简历WonderCV 网页版
    超级简历WonderCV 网页版

    超级简历WonderCV是面向应届生和AI小白的智能求职平台,覆盖简历、面试与职业规划。

    音述AI 网页版
    音述AI 网页版

    音述AI,是一个以“用声音述说故事”为核心的 AI 音乐创作与声音分享社区。

    AionClaw macOS版
    AionClaw macOS版

    AionClaw 是可在桌面端运行的任务型 AI 助手,通过数字专家与技能市场组合办公、创作、数据和开发能力。

    Loomy macOS版
    Loomy macOS版

    Loomy 是科大讯飞推出的桌面 AI 助手,可通过对话、任务与工作目录协助处理办公、内容创作和资料整理。

    AirBuddy 3 macOS版
    AirBuddy 3 macOS版

    AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

    AirServer macOS版
    AirServer macOS版

    AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

    AnyDesk macOS版
    AnyDesk macOS版

    AnyDesk macOS版是一款适用于远程办公、设备维护和客户支持的远程桌面工具,可连接并操作异地计算机,支持文件传输、无人值守访问、会话权限控制及跨平台协作。

    WINDOWS 更多
    讯飞绘文 网页版
    讯飞绘文 网页版

    讯飞绘文网页版是科大讯飞推出的AI图文创作与内容运营工具,覆盖热点选题、文章生成、稿件校对、智能配图、排版发布和数据复盘等环节,适合自媒体创作者及内容团队在线使用。

    Maya(Autodesk Maya) Windows版
    Maya(Autodesk Maya) Windows版

    Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

    Aperty Windows版
    Aperty Windows版

    Aperty 是 Skylum 推出的 AI 人像修图软件,支持自然肤质修饰、瑕疵处理、面部与身体调整、预设及批量同步。

    火山引擎 网页版
    火山引擎 网页版

    火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。

    立刻MV 网页版
    立刻MV 网页版

    立刻MV 面向音乐人、内容创作者和品牌团队,帮助用户低成本完成歌曲 MV、歌词视频、AI 分镜、图生视频与最终合成。

    蛙蛙写作 网页版
    蛙蛙写作 网页版

    蛙蛙写作 AI 创作工具,覆盖小说、剧本、文案,一键生成文稿,打通文字转视频全流程,高效解决创作难题。

    讯飞智作 网页版
    讯飞智作 网页版

    讯飞智作是一款基于语音合成技术、虚拟人驱动技术与数字人形象声音构建能力的 AI 数字人音视频创作平台。

    超级简历WonderCV 网页版
    超级简历WonderCV 网页版

    超级简历WonderCV是面向应届生和AI小白的智能求职平台,覆盖简历、面试与职业规划。

    音述AI 网页版
    音述AI 网页版

    音述AI,是一个以“用声音述说故事”为核心的 AI 音乐创作与声音分享社区。

    AionClaw Windows版
    AionClaw Windows版

    AionClaw 是可在桌面端运行的任务型 AI 助手,通过数字专家与技能市场组合办公、创作、数据和开发能力。

    Loomy Windows版
    Loomy Windows版

    Loomy 是科大讯飞推出的桌面 AI 助手,可通过对话、任务与工作目录协助处理办公、内容创作和资料整理。

    AirServer Windows版
    AirServer Windows版

    AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。