


剑桥团队开源:赋能多模态大模型RAG应用,首个预训练通用多模态后期交互知识检索器

Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
论文链接:https://arxiv.org/abs/2402.08327DEMO链接:https://u60544-b8d4-53eaa55d.westx.seetacloud.com:8443/项目主页链接:https://preflmr.github.io/论文标题:PreFLMR:ScalingUpFine-GrainedLate-InteractionMulti-modalRetrievers背景虽然多模态大模型(如GPT4-Vision、Gemini等)展示了强大的通用图文理解能力,但在处理需
- 论文链接:https://arxiv.org/abs/2402.08327
- DEMO 链接:https://u60544-b8d4-53eaa55d.westx.seetacloud.com:8443/
- 项目主页链接:https://preflmr.github.io/
- 论文标题:PreFLMR: Scaling Up Fine-Grained Late-Interaction Multi-modal Retrievers
背景
虽然多模态大模型(如GPT4-Vision、Gemini等)展示了强大的通用图文理解能力,但在处理需要专业知识的问题时表现不如人意。即使是GPT4-Vision,也无法有效回答知识密集型问题(如图一所示),这给许多企业级应用带来了挑战。
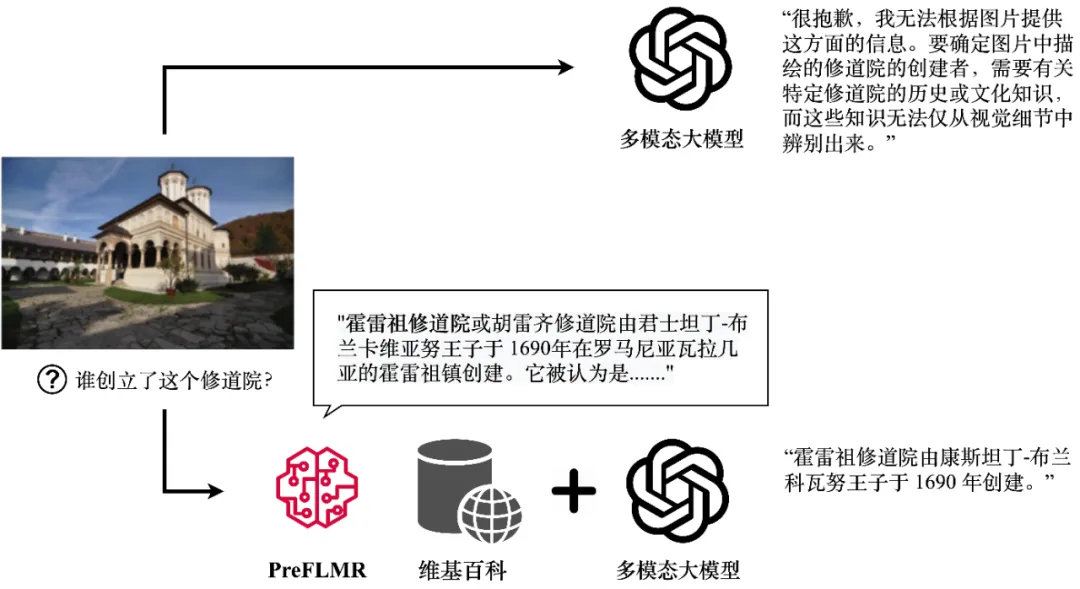
GPT4-Vision 可以通过 PreFLMR 多模态知识检索器获取相关知识,并生成准确的答案。图中展示了模型的实际输出结果。
检索增强生成(RAG,Retrieval-Augmented Generation)为解决这个问题提供了一个简单有效的方法,让多模态大模型在某个领域变得像“领域专家”一样。其工作原理如下:首先,利用轻量级知识检索器(Knowledge Retriever)从专业数据库(如Wikipedia或企业知识库)中检索相关的专业知识;接着,大型模型将这些知识与问题一起作为输入,输出准确的答案。多模态知识提取器的知识“召回能力”直接影响着大型模型在回答推理问题时是否能获取准确的专业知识。
近期,剑桥大学信息工程系人工智能实验室完整开源了首个预训练、通用多模态后期交互知识检索器 PreFLMR (Pre-trained Fine-grained Late-interaction Multi-modal Retriever)。相比以往常见的模型,PreFLMR 有以下特点:
PreFLMR是一款通用预训练模型,能有效解决文本检索、图像检索和知识检索等多个子任务。经过百万级多模态数据的预训练,该模型在多个下游检索任务中表现出色。另外,作为一款优秀的基础模型,PreFLMR 经过针对私有数据的微调后,能够迅速发展成为优秀的领域专用模型。
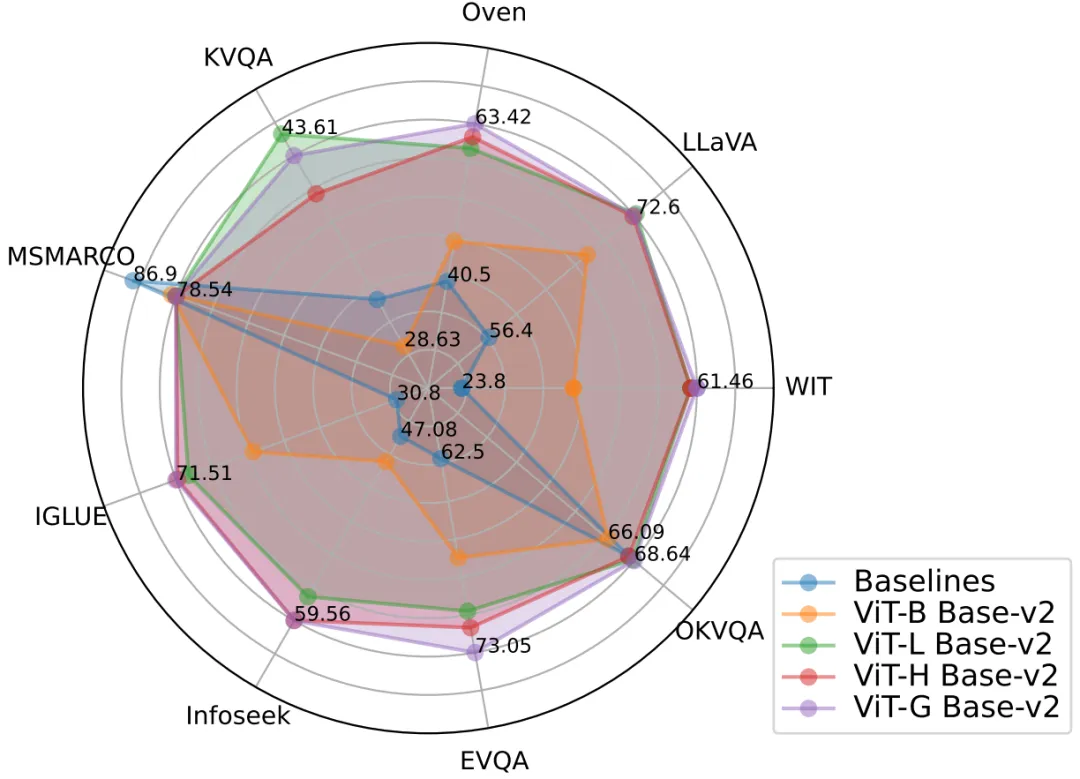
图 2:PreFLMR 模型同时在多项任务上取得极佳的多模态检索表现,是一个极强的预训练基底模型。
2. 传统的密集文本检索(Dense Passage Retrieval, DPR)只使用一个向量表征问询(Query)或文档(Document)。剑桥团队在 NeurIPS 2023 发表的 FLMR 模型证明了 DPR 的单向量表征设计会导致细粒度信息损失,导致 DPR 在需要精细信息匹配的检索任务上表现不佳。尤其是在多模态任务中,用户的问询(Query)包含复杂场景信息,压缩至一维向量极大抑制了特征的表达能力。PreFLMR 继承并改进了 FLMR 的结构,使其在多模态知识检索中有得天独厚的优势。
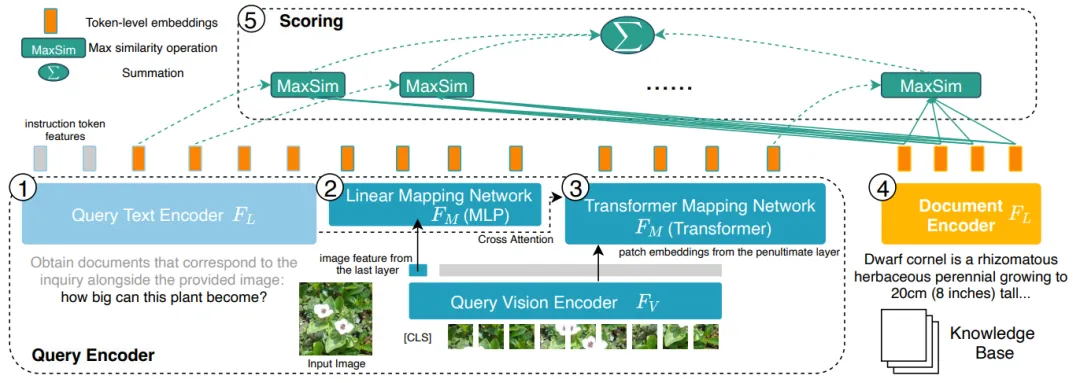
图 3:PreFLMR 在字符级别(Token level)上编码问询(Query,左侧 1、2、3)和文档(Document,右侧 4),相比于将所有信息压缩至一维向量的 DPR 系统有信息细粒度上的优势。
3.PreFLMR 能够根据用户输入的指令(例如 “提取能用于回答以下问题的文档” 或 “提取与图中物品相关的文档”),从庞大的知识库中提取相关的文档,帮助多模态大模型大幅提升在专业知识问答任务上的表现。
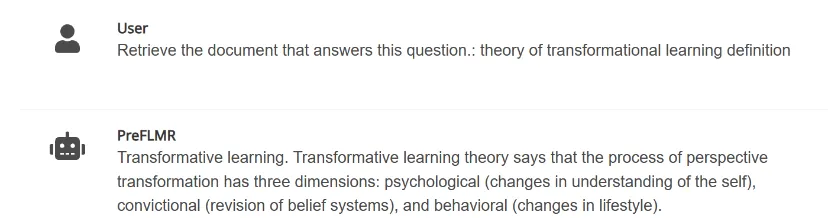
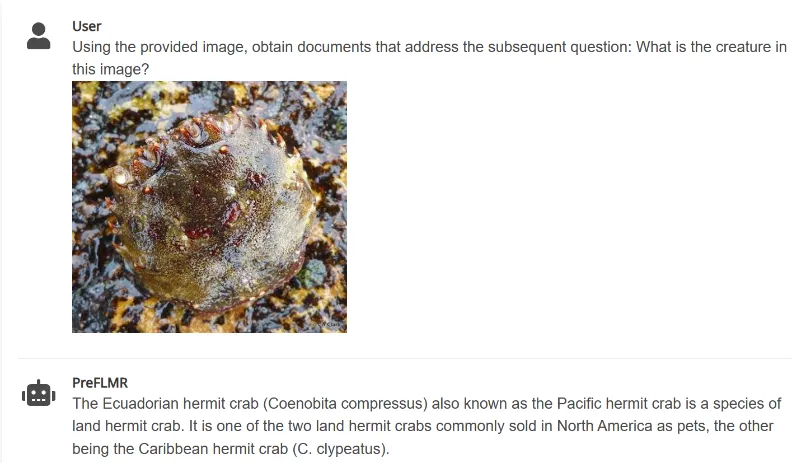
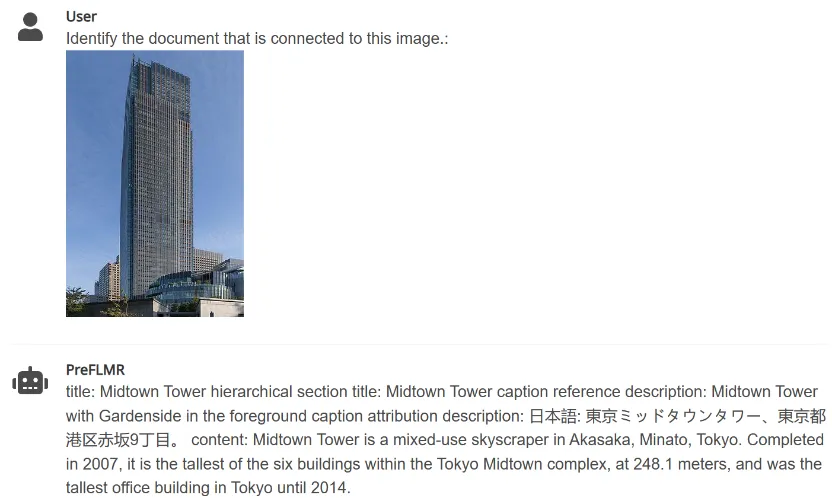
图 4:PreFLMR 可以同时处理图片提取文档、根据问题提取文档、根据问题和图片一起提取文档的多模态问询任务。
剑桥大学团队开源了三个不同规模的模型,模型的参数量由小到大分别为:PreFLMR_ViT-B (207M)、PreFLMR_ViT-L (422M)、PreFLMR_ViT-G (2B),供使用者根据实际情况选取。
除了开源模型 PreFLMR 本身,该项目还在该研究方向做出了两个重要贡献:
- 该项目同时开源了一个训练和评估通用知识检索器的大规模数据集,Multi-task Multi-modal Knowledge Retrieval Benchmark (M2KR),包含 10 个在学界中被广泛研究的检索子任务和总计超过百万的检索对。
- 在论文中,剑桥大学团队对比了不同大小、不同表现的图像编码器和文本编码器,总结了扩大参数和预训练多模态后期交互知识检索系统的最佳实践,为未来的通用检索模型提供经验性的指导。
下文将简略介绍 M2KR 数据集,PreFLMR 模型和实验结果分析。
M2KR 数据集
为了大规模预训练和评估通用多模态检索模型,作者汇编了十个公开的数据集并将其转换为统一的问题 - 文档检索格式。这些数据集的原本任务包括图像描述(image captioning),多模态对话(multi-modal dialogue)等等。下图展示了其中五个任务的问题(第一行)和对应文档(第二行)。
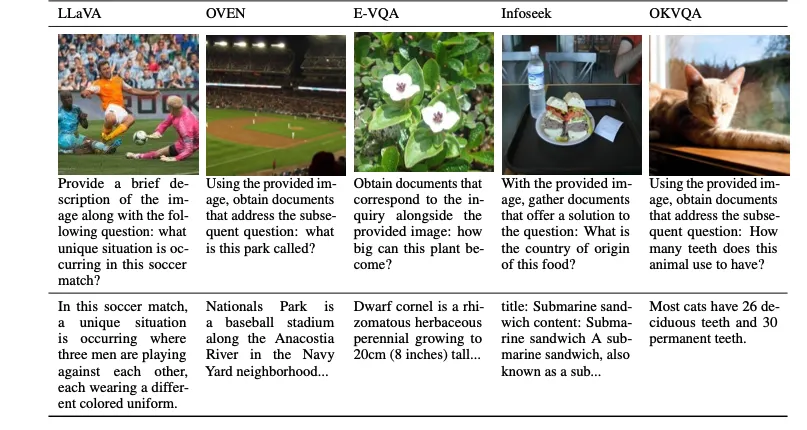
图 5:M2KR 数据集中的部分知识提取任务
PreFLMR 检索模型
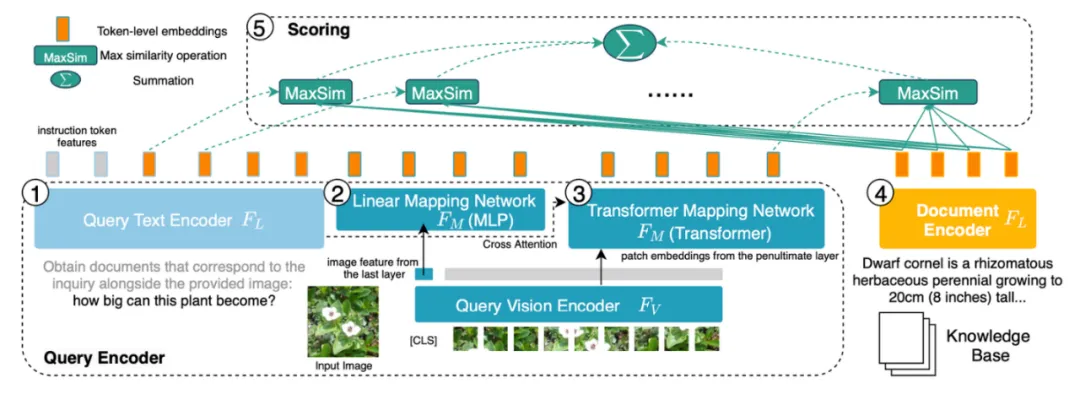
图 6:PreFLMR 的模型结构。问询(Query)被编码为 Token-level 的特征。PreFLMR 对问询矩阵中的每一个向量,找到文档矩阵中的最近向量并计算点积,然后对这些最大点积求和得到最后的相关度。
PreFLMR 模型基于发表于 NeurIPS 2023 的 Fine-grained Late-interaction Multi-modal Retriever (FLMR) 并进行了模型改进和 M2KR 上的大规模预训练。相比于 DPR,FLMR 和 PreFLMR 用由所有的 token 向量组成的矩阵对文档和问询进行表征。Tokens 包含文本 tokens 和投射到文本空间中的图像 tokens。后期交互(late interaction)是一种高效计算两个表征矩阵之间相关性的算法。具体做法为:对问询矩阵中的每一个向量,找到文档矩阵中的最近向量并计算点积。然后对这些最大点积求和得到最后的相关度。这样,每个 token 的表征都可以显式地影响最终的相关性,以此保留了 token-level 的细粒度(fine-grained)信息。得益于专门的后期交互检索引擎,PreFLMR 在 40 万文档中提取 100 个相关文档仅需 0.2 秒,这极大地提高了 RAG 场景中的可用性。
PreFLMR 的预训练包含以下四个阶段:
- 文本编码器预训练:首先,在 MSMARCO(一个纯文本知识检索数据集)上预训练一个后期交互文文检索模型作为 PreFLMR 的文本编码器。
- 图像 - 文本投射层预训练:其次,在 M2KR 上训练图像 - 文本投射层并冻结其它部分。该阶段只使用经过投射的图像向量进行检索,旨在防止模型过度依赖文本信息。
- 持续预训练:然后,在 E-VQA,M2KR 中的一个高质量知识密集型视觉问答任务上持续训练文本编码器和图像 - 文本投射层。这一阶段旨在提升 PreFLMR 的精细知识检索能力。
- 通用检索训练:最后,在整个 M2KR 数据集上训练所有权重,只冻结图像编码器。同时,将问询文本编码器和文档文本编码器的参数解锁进行分别训练。这一阶段旨在提高 PreFLMR 的通用检索能力。
同时,作者展示了 PreFLMR 可以在子数据集(如 OK-VQA、Infoseek)上进一步微调以在特定任务上获得更好的检索性能。
实验结果和纵向扩展
最佳检索结果:表现最好的 PreFLMR 模型使用 ViT-G 作为图像编码器和 ColBERT-base-v2 作为文本编码器,总计二十亿参数。它在 7 个 M2KR 检索子任务(WIT,OVEN,Infoseek, E-VQA,OKVQA 等)上取得了超越基线模型的表现。
扩展视觉编码更加有效:作者发现将图像编码器 ViT 从 ViT-B(86M)升级到 ViT-L(307M)带来了显著的效果提升,但是将文本编码器 ColBERT 从 base(110M)扩展到 large(345M)导致表现下降并造成了训练不稳定问题。实验结果表明对于后期交互多模态检索系统,增加视觉编码器的参数带来的回报更大。同时,使用多层 Cross-attention 进行图像 - 文本投射的效果与使用单层相同,因此图像 - 文本投射网络的设计并不需要过于复杂。
PreFLMR 让 RAG 更加有效:在知识密集型视觉问答任务上,使用 PreFLMR 进行检索增强大大提高了最终系统的表现:在 Infoseek 和 EVQA 上分别达到了 94% 和 275% 的效果提升,经过简单的微调,基于 BLIP-2 的模型能够击败千亿参数量的 PALI-X 模型和使用 Google API 进行增强的 PaLM-Bison+Lens 系统。
结论
剑桥人工智能实验室提出的 PreFLMR 模型是第一个开源的通用后期交互多模态检索模型。经过在 M2KR 上的百万级数据预训练,PreFLMR 在多项检索子任务中展现出强劲的表现。M2KR 数据集,PreFLMR 模型权重和代码均可以在项目主页 https://preflmr.github.io/ 获取。
拓展资源
- FLMR paper (NeurIPS 2023): https://proceedings.neurips.cc/paper_files/paper/2023/hash/47393e8594c82ce8fd83adc672cf9872-Abstract-Conference.html
- 代码库:https://github.com/LinWeizheDragon/Retrieval-Augmented-Visual-Question-Answering
- 英文版博客:https://www.jinghong-chen.net/preflmr-sota-open-sourced-multi/
- FLMR 简介:https://www.jinghong-chen.net/fined-grained-late-interaction-multimodal-retrieval-flmr/











火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。








AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,

AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。